Материал: Дискретная математика. учебное пособие. Собенина О.В
Рассмотрим работу алгоритма на примере. Пусть дан взвешенный граф (рис. 4.34).
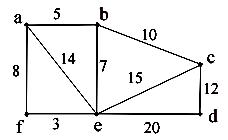
Рис. 4.34. Граф
Полагаем
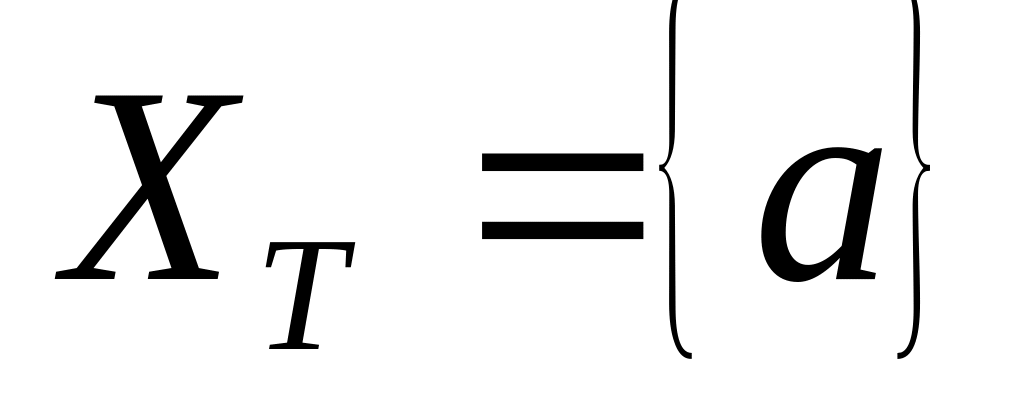 и
Формируем
пометки для вершин.
b [a,5], e [a,14], f [a,8], c [0, ], d [0, ].
Выбираем вершину
с минимальной пометкой, т.е. вершину b.
Добавляем эту вершину к
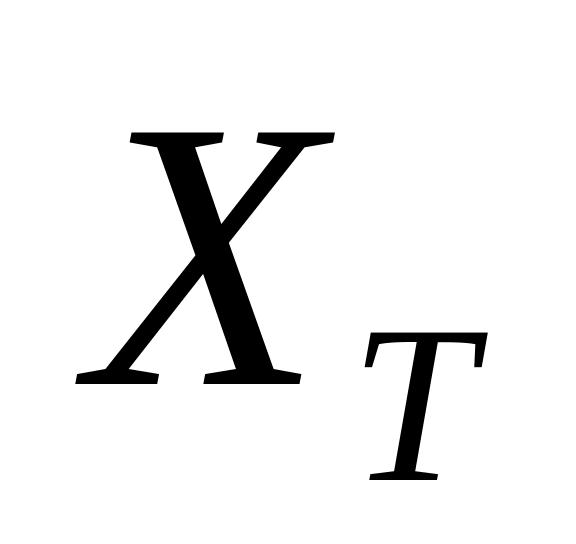 ,
а соответствующее ребро к
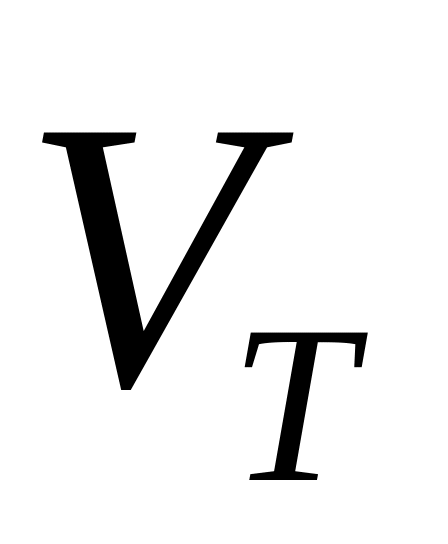 .
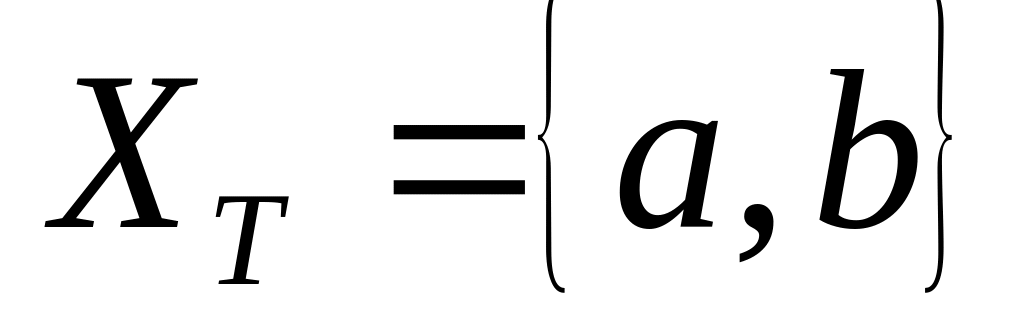 ,
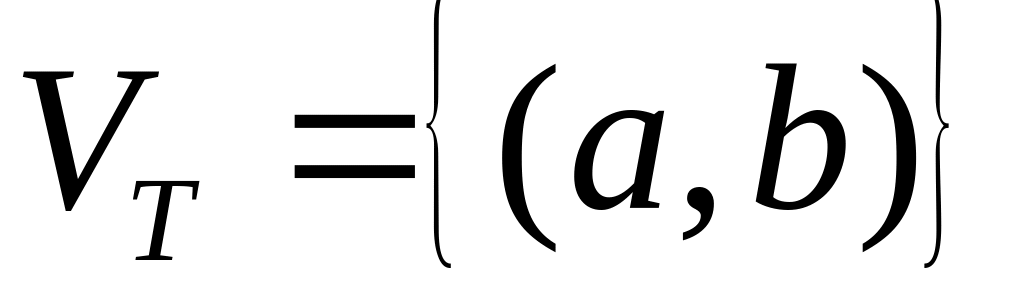 .
Меняем пометки для вершин, смежных с вершинами из множества . Пометку вершины e [a,14] меняем на [b,7].
c [b,10], e [b,7], f [a,8], d [0, ].
Выбираем вершину с минимальной пометкой, т.е. вершину e, формируем множества и .
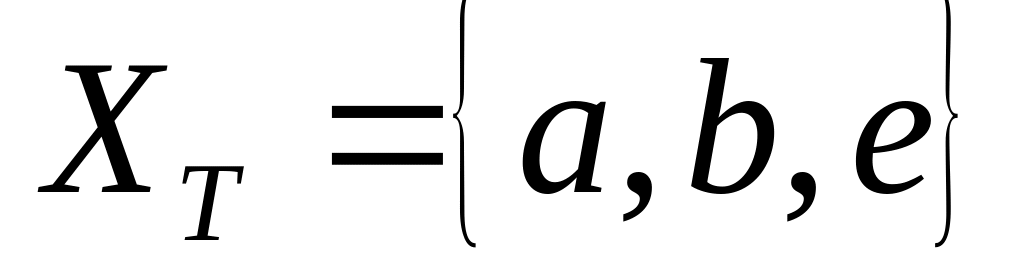 ,
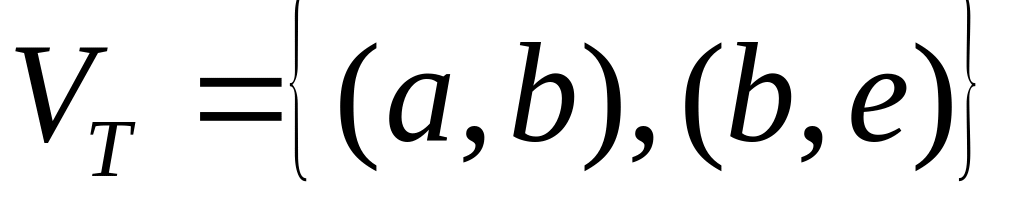 .
Устанавливаем пометки вершин.
f [e,3], d [e,20], c [b,10]. Вершина с минимальной помет-кой f.
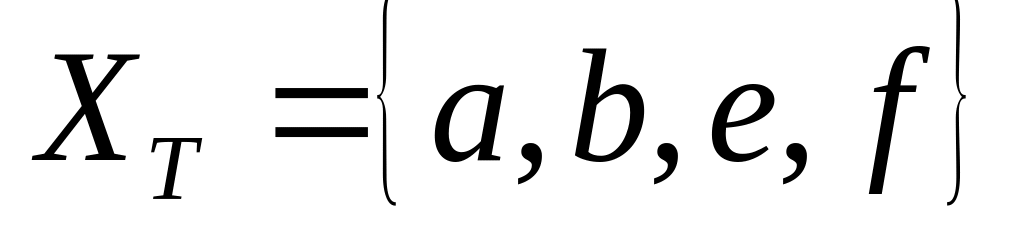 ,
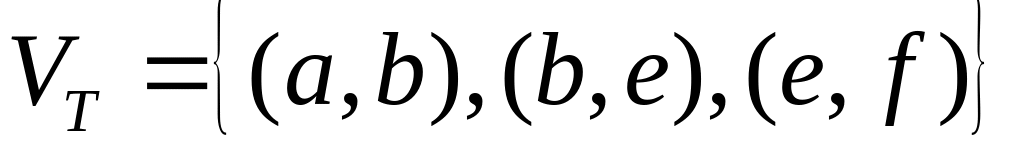 и т.д.
c [b,10], d [e,20]. Вершина с минимальной пометкой c.
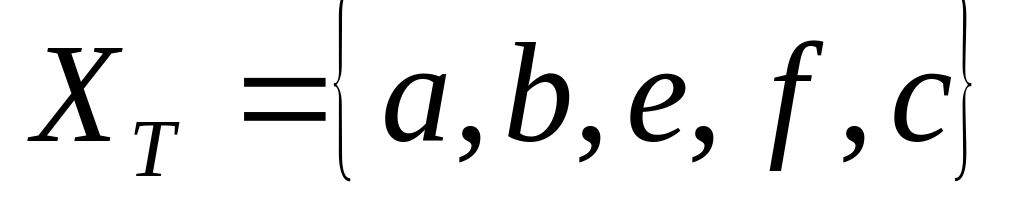 ,
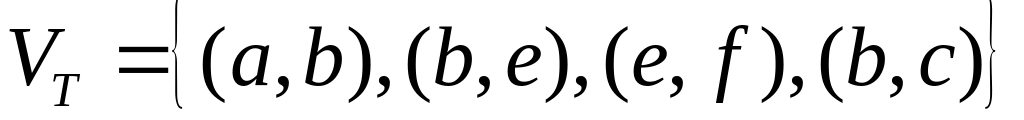
d [c,12].
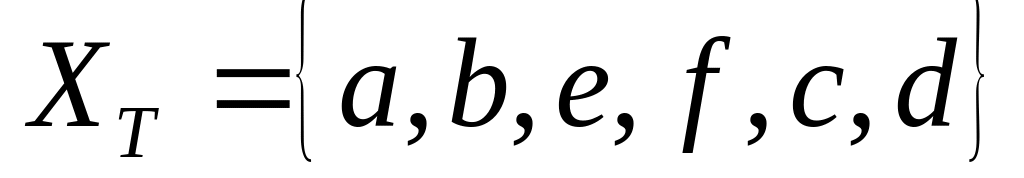 ,
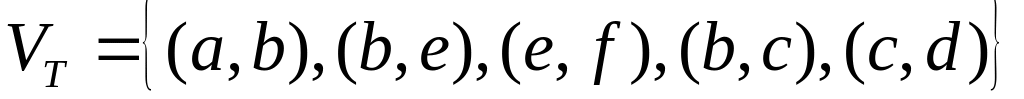
Т.к. , то все вершины включены в остов, останов алгоритма. Кратчайший остов представлен на рис. 4.35.
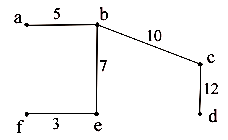
Рис. 4.35
Рассмотрим алгоритм Краскала построения кратчайшего остова взвешенного графа.
Шаг 1. Включить в остов T все вершины исходного графа. Пусть количество вершин равно n.
Шаг 2. Упорядочить ребра графа G в порядке неубывания из весов.
Шаг 3. Начав с первого ребра в этом списке, добавлять ребра в граф Т, соблюдая условие: такое добавление не должно приводить к появлению цикла в графе Т.
Шаг 4. Повторять шаг 3 до тех пор, пока число ребер в Т не станет равным n-1. Полученный граф Т является кратчайшим остовом графа G.
П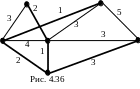 риведенный
алгоритм, в частности, позволяет находить
остов в невзвешенном
графе, положив сij
= 1 для всех
ребер.
Пример. На рис. 4.36 показан остов минималь-ного веса взвешенного графа. Ребра, вошедшие в остов, выделены жир-ным. Вес остова равен 9.
4.11.4. Обходы графа по глубине и ширине
Обход графа – это некоторое систематическое перечисление его вершин (и / или ребер). Наибольший интерес представляют обходы, использующие локальную информацию. Среди всех обходов наиболее известны поиск в ширину и глубину. Эти обходы можно описать так.
При поиске в глубину, отправляясь в «путешествие» по графу из некоторой начальной вершины xо, мы действуем следующим образом. Пусть, «путешествуя», мы достигли некоторой вершины x (в начале «путешествия» x=x0). Отмечаем вершину x и просматриваем вершины из ее списка смежности L[x].
При условии, что в этом списке существует хотя бы одна неотмеченная вершина, продолжаем «путешествие» из первой такой вершины y, действуя как описано выше «ныряем» вглубь, т.е. просматриваем вершины списка смежности L[y] вершины y, откладывая анализ других элементов L[x] как возможных продолжений поиска «на потом».
Если же неотмеченных вершин в L[x] нет, то возвращаемся из x в ту вершину, из которой мы в нее попали, и продолжаем анализировать список смежности этой вершины.
Рассмотрим теперь поиск в ширину. При поиске в ширину «правила игры» такие: достигнув некоторой вершины, отмечаем ее. Затем просматриваем ее список смежности L[x] и отмечаем все ранее не отмеченные вершины списка (при старте поиска x=xo). После того как отмечены все вершины из L[x], вершину x считаем полностью обработанной и продолжаем обработку вершин из списка L[x] по очереди согласно описанным правилам.
Именно в обработке сразу всего списка смежности текущей вершины заключается принципиальное отличие поиска в ширину от поиска в глубину: там мы «ныряли» как можно «глубже», а здесь идем, «загребая» сразу все, что можно.
Поиск в ширину заканчивается, когда все вершины полностью обработаны или продолжение поиска невозможно.
Теорема 4.11.2. Если граф G=(X,V) связен, то поиск в ширину и глубину обойдут все вершины по одному разу.
Доказательство.
Единственность обхода вершин. Обходятся только вершины попавшие в Т. В Т попадают только неотмеченные вершины. При попадании в Т вершина отмечается. Следовательно, любая вершина будет обойдена не более одного раза.
Завершаем ость алгоритма. Всего в Т может попасть не более р вершин. На каждом шаге одна вершина удаляется из Т. Следовательно, алгоритм завершит работу не более чем через р шагов.
Обход всех вершин. От противного. Пусть алгоритм закончил работу, и вершина z не обойдена. Значит, не попала в Т. Следовательно, она не была отмечена. Отсюда следует, что все вершины, смежные с z, не были обойдены и отмечены. Аналогично, любые вершины, смежные с неотмеченными, сами не отмечены (после завершения алгоритма). Но G связан, значит, существует путь (x, z). Следовательно, вершина x не отмечена. Но она была отмечена на первом шаге.
Рассмотрим более подробно алгоритм поиска в ширину в графе.
Вход. Граф G=(X,V), заданный матрицей смежности начальная вершина (не обязательно первый элемент массива).
Выход. Массив Т меток вершин, где каждая метка равна длине пути от x 0 до x.
Шаг 1.В начале все вершины у нас не отмечены w[x]=0.
Шаг 2. Выбираем вершину с которой начнем обход и помещаем ее в структуру данных Т.
Шаг 3. Отмечаем эту вершину в качестве пройденной w[x]=1.
Шаг 4. Начинаем просматривать смежные с ней вершины, если данную вершину не просматривали (т.е. w[z]=0) то помещаем ее в структуру данных Т, и отмечаем ее как пройденную w[z]=1.
Шаг 5. Обход будем выполнять до тех пор, пока не отметим все вершины.
На рис. 4.37 представлен граф, вершины которого занумерованы согласно очередности, в которой они посещаются в процессе поиска в ширину.
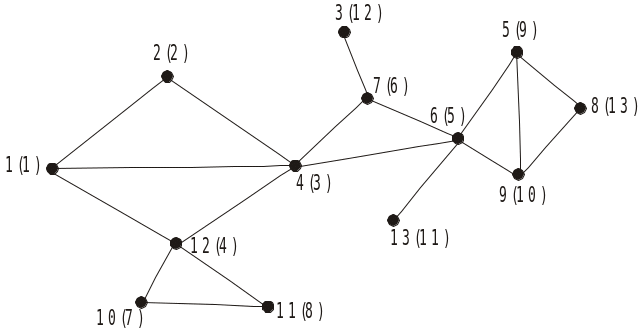
Рис. 4.37
4.11.5. Упорядоченные и бинарные деревья
Определим по индукции понятие упорядоченного дерева:
1) пустое множество и список (а), где а некоторый элемент, является упорядоченным деревом;
2) если T1, T2,..., Тп непустые упорядоченные деревья, a некоторый новый элемент, то список Т = (a, T1, T2, ..., Тn) образует упорядоченное дерево. При этом элемент а называемся корнем упорядоченного дерева Т;
3) любое упорядоченное дерево строится в соответствии с п.п. 1 и 2.
Если T1, T2, ..., Тn упорядоченные деревья, то список (T1, T2, ..., Тn) называется упорядоченным лесом.
Для заданного упорядоченного дерева Т определим множество S(Т) его упорядоченных поддеревьев:
если Т = , то S(T) = ;
если Т = (а), то S(T) = {(a)};
если Т=(a, T1, T2, ..., Тn), то S(T)=S(T1)...S(Tn){Т}.
Непустое упорядоченное дерево Т может интерпретироваться в виде системы пронумерованных непустых множеств, каждое из которых взаимно однозначно соответствует упорядоченному поддереву из S(Т) так, что:
1) если Т' поддерево упорядоченного дерева Т", Т',Т"S(T), то для соответствующих множеств X' и X" выполняется включение X' X";
2) если Т' не является поддеревом упорядоченного дерева Т", Т',Т"S(T), то соответствующие множества не пересекаются.
Пример. Упорядоченному дереву
(1, (2, (4), (6)), (3, (6, (8), (9)), (7)))
с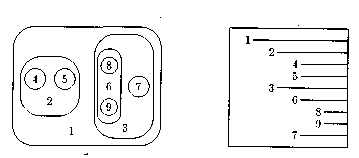 оответствует
система множеств, изображенная на рис.
4.38.
Рис. 4.38 Рис. 4.39
Упорядоченное дерево может также интерпретироваться в виде так называемого уступчатого списка, который используется в оглавлениях. На рис. 4.39 представлен уступчатый список, соответствующий упорядоченному списку из примера.
Согласно следующему тезису любая схема, в которой заданы определенные приоритеты между элементами, может рассматриваться как некоторое упорядоченное дерево.
Тезис. Любая иерархическая классификационная схема интерпретируется некоторым упорядоченным деревом.
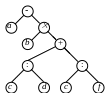
Например, и виде упорядоченного дерева представляется любой терм. На рис. 4.40 изображено упорядоченное дерево, соответствующее терму t=a-b(c:d+e:f).