Практическое задание: Методы социально-экономического прогнозирования
Методы социально-экономического прогнозирования
Методы
социально-экономического прогнозирования
. Выполнить сглаживание с помощью метода скользящей средней. По полученному сглаженному ряду сделать вывод о характере тренда и сезонной компоненте.
Построим график исходного ряда ri и проанализируем его.
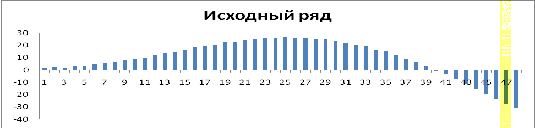
По графику видно, что ряд достаточно
ровный. Рассмотрим часть ряда более близко.
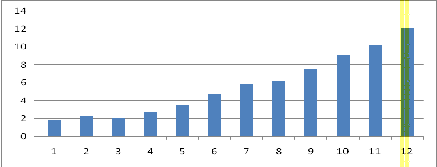
Можно предположить что, сезонная
компонента имеет интервал равный двум. Выделим сезонную компоненту с помощью
скользящей средней за 2 месяца. После сглаживания построим график полученного
ряда.
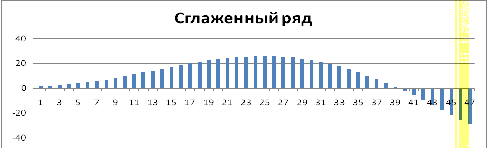
Можно сделать вывод по сглаженному ряду, что тренд имеет нелинейный вид. Скорее всего, уравнение тренда имеет вид полинома n-ой степени. Дальнейшие расчеты мы все же будем проводить с исходными данными, так как при сглаживании теряются несколько наблюдений, что приводит к результатам, отражающих не совсем реальную ситуацию.
Проанализируем исходный ряд на
наличие стационарности. Проведем гипотезу на наличие единичного корня (Тест
Дики-Фуллера).
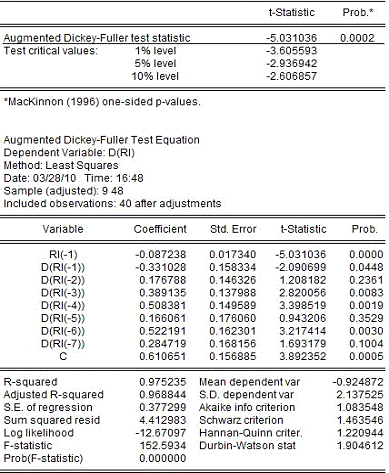
В данной таблице значение Prob статистики Дики-Фуллера равно нулю, так как DFнаб.=-5,031036<DFкрит. (0,01)= -3,605593, следовательно, гипотеза отвергается, а значит, единичного корня нет, т.е. ряд стационарный.
. Вычислить значения ACF и PACF до 12 лага. Сделать выводы о сезонной компоненте.
По исходному ряду строим ACF и PACF до 12 лага:
Quick-Series Statistics-Correlogram:
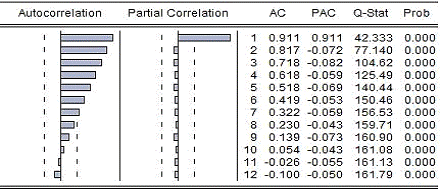
Q-статистика указывает на наличие автокорреляции, причем значительную. Об этом нам говорит и то, что Prob равно нулю. Т.к. PACF резко падает, то, скорее всего, в модель необходимо включить процесс AR(1). Этой рекомендацией мы воспользуемся в пункте задания 6. А пока перейдём к построению других моделей.
3. Выделить сезонную компоненту в аддитивной и мультипликативной модели. Построить модели T+S+E, TSE. Сравнить эти модели.
Продолжаем использование прикладного пакета Eviews.
Нам необходимо построить аддитивную и мультипликативную модели.
1) С видом аддитивной модели мы уже определились ранее по виду графика сглаженного ряда. Попробуем построить полиномы различных степеней и выбрать наилучший.
Генерируем ряд времени:
· genr t=1;
· genr t(1)=t+1.
· ls ri c t t^2 - полином 2-ой степени:
·
Коэффициент
Стандартная
ошибка
t-статистика
P-значение
с
-11.95197
1.694269
-7.054353
0.000
t
3.359159
0.159505
21.05996
0.000
t2
-0.076939
0.003156
-24.37867
0.000
R2
0.939987
R2adj
0.93732
Стандартная ошибка уравнения
3.750848
F-критерий
352.4173
P-значение (F-критерия)
0.000000
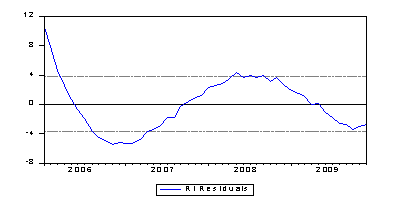
График остатков:
ls ri c t t^2 t^3 - полином 3-ей степени:
Коэффициент
Стандартная
ошибка
t-статистика
P-значение
с
-2.252503
1.078528
-2.088497
0.0426
t
1.099443 5.827629
0
t2
0.037173
0.008897
4.178029
0.0001
t3
-0.001553
0.000119
-12.99947
0
R2
0.987602
R2adj
0.986757
Стандартная ошибка уравнения
1.72409
F-критерий
1168.329
P-значение (F-критерия)
0
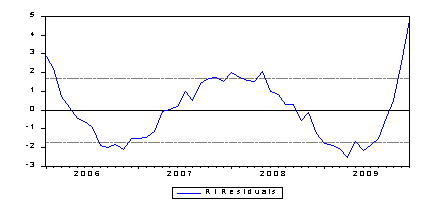
График остатков:
ls ri c t t^2 t^3 t^4 - полином 4-ой степени:
Коэффициент
Стандартная
ошибка
t-статистика
P-значение
с
3.652268
0.360666
10.12645
0
t
-1.106609
0.099745
-11.09436
0
t2
0.234935
0.008158
28.79658
0
t3
-0.007787
0.000249
-31.27871
0
t4
6.36E-05
2.52E-06
25.23106
0
R2
0.999216
R2adj
0.999143
Стандартная ошибка уравнения
0.43869
F-критерий
13693.3
P-значение (F-критерия)
0
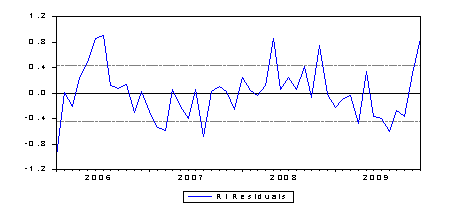
График остатков:
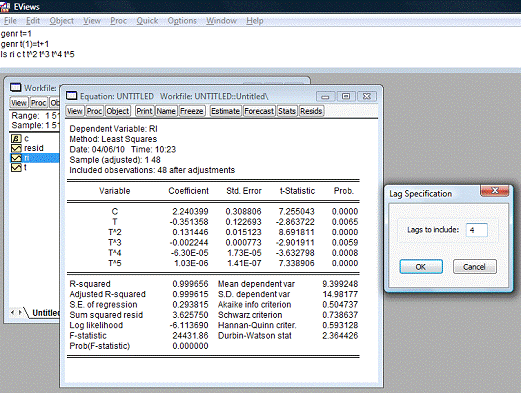
ls ri c t t^2 t^3 t^4 t^5 - полином 5-ой степени:
Коэффициент
Стандартная
ошибка
t-статистика с
2.240399
0.308806
7.255043
0
t
-0.351358
0.122693
-2.863722
0.0065
t2
0.131446
0.015123
8.691811
0
t3
-0.002244
0.000773
-2.901911
0.0059
t4
-6.30E-05
1.73E-05
-3.632798
0.0008
t5
1.03E-06
1.41E-07
7.338906
0
R2
0.999656
R2adj
0.999615
Стандартная ошибка уравнения
0.293815
F-критерий
24431.86
P-значение (F-критерия)
0
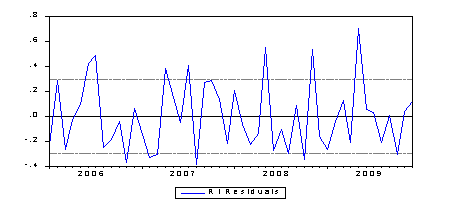
График остатков:
· Построим
сравнительную таблицу:
Степень полинома
Количество незначимых коэффициентов
R2
R2adj
Стандартная ошибка уравнения
F-критерий
P-значение (F-критерия)
2
0
0.939987
0.93732
3.750848
352.4173
0
3
0
0.987602
0.986757
1.72409
1168.329
0
4
0
0.999216
0.99914
0.43869
13693.3 5
0
0.999656
0.99962
0.293815
24431.86
0
Наилучшими характеристиками обладает
уравнение тренда в виде полинома 5-ой степени:
Y = 2.2404 - 0.3514*T + 0.13145*T^2 - 0.0022*T^3 - 6.3e-05*T^4 + 1.03e-06*T^5 (1).
Нами построена аддитивная модель.
Найдём ее характеристики, чтобы в дальнейшем составить сравнительную таблицу
аддитивной и мультипликативной моделей.
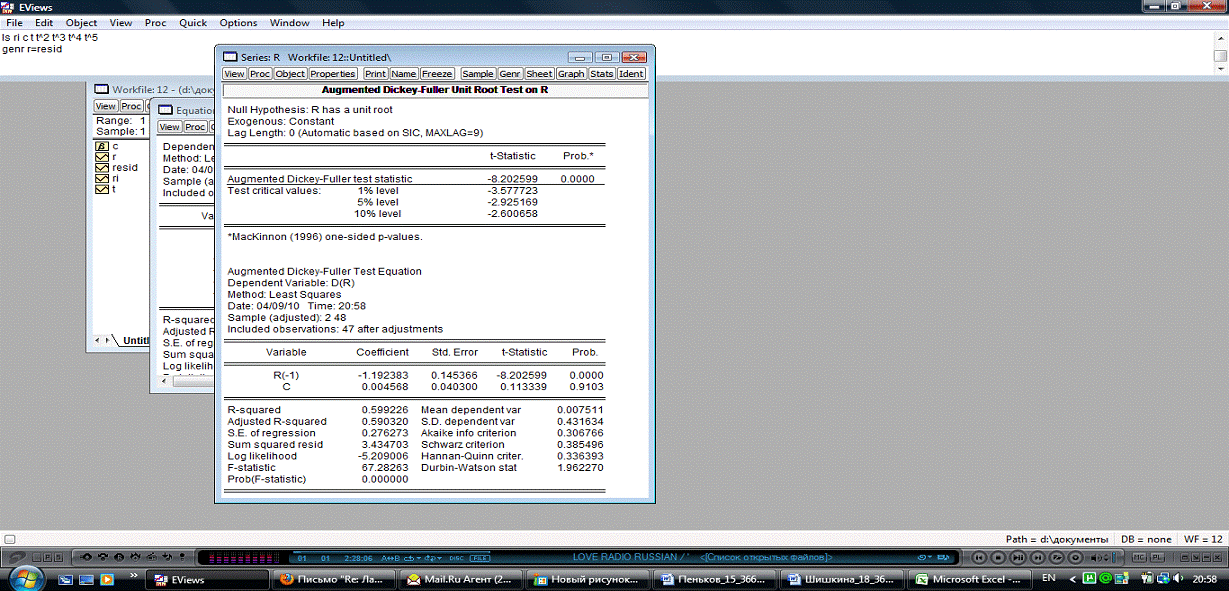
Проверим остатки на стационарность,
для этого запишем в командной строке:
genr r=resid→
Series Statistics →Unit Root Test
Так как Prob статистики Дики-Фуллера
равно нулю, то гипотеза отвергается, а значит, единичного корня нет, т.е. ряд
стационарный.
LM тест: View - Residual test - Serial Correlation LM test
F-statistic
0.486079
Probability
0.7458
Obs*R-squared
2.33643
Probability
0.6741
Переменная
Коэффиц.
Станд.ошб.
t-статистика
P-значение
C
0.011758
0.316923
0.0371
0.9706
T
-0.006962
0.126049
-0.055232
0.9562
T^2
0.001049
0.015551
0.06746
0.9466
T^3
-6.11E-05
0.000796
-0.076757
0.9392
T^4
1.50E-06
1.78E-05
0.084134
0.9334
T^5
-1.31E-08
1.45E-07
-0.090124
0.9287
RESID(-1)
-0.205802
0.163053
-1.262175
0.2146
RESID(-2)
-0.063417
0.166311
-0.381315
0.7051 -0.10421
0.167418
-0.622456
0.5374
RESID(-4)
-0.007582
0.164904
-0.045977
0.9636
R-squared
0.048676
Mean dependent var
8.38E-15
Adjusted R-squared
-0.176638
S.D. dependent var
0.277747
S.E. of regression
0.301281
Akaike info criterion
0.621504
Sum squared resid
3.449264
Schwarz criterion
1.011337
Log likelihood
-4.916086
Hannan-Quinn criter.
0.768822
F-statistic
0.216035
Durbin-Watson stat
1.984577
Prob (F-statistic)
0.990376
В результате данного теста мы видим,
что Prob значения статистик LM теста отличны от нуля и все коэффициенты не
значимы, что говорит об отсутствии автокорреляции.
Значения ACF и PACF:
View - Residual
test - Correlogram - Q-statistics
Из этих двух тестов мы видим, что
скорее всего автокорреляция отсутствует.
2) Теперь построим мультипликативную модель. Для этого логично
воспользоваться знанием свойств логарифма. Мультипликативная модель имеет вид: y=dea+bt^2+….
Введём в командную строку следующее:
Перейдём к аддитивной модели,
посредствам логарифмирования:
genr ri=ri+31 [чтобы все числа стали положительными]
genr y=@log(ri) [логарифмируем ряд]
ls y c ty c t t2
ls y c t t2 t3
и т.д.
Нам необходимо выбрать наилучшую
мультипликативную модель, аналогично мы выбирали аддитивную модель.
Лучшими характеристиками обладает
модель построенная по формуле:
сглаживание скользящий аддитивный
модель
ls y c t t^2 t^3 t^4 t^5 t^6 t^7 t^8 t^9 t^10.