Материал: Волченков Логическое программирование язык пролог 2015
|
Код 2.1 |
ancestor(_, Адам) :- !, fail. |
% У Адама предков нет. |
ancestor(Адам, Ева) :-!. |
% У Евы один предок – Адам. |
%Все люди, кроме Адама – потомки Адама.
%Все люди, кроме Адама и Евы – потомки Евы. ancestor(Адам, X).
ancestor(Ева, X).
ancestor(X, Y) :- parent(X, Y). % Родитель есть предок.
ancestor(X, Y) :- parent(X, Z), ancestor(Z, Y).
%Родитель предка есть предок.
Вэтом определении 6 клозов (утверждений) представляют последовательность. Два первых клоза – правила, два следующих – факты, два последних – правила. Изменение их порядка не меняет логического смысла представляемых ими аксиом. Но именно данный порядок обеспечивает правильную работу алгоритма логиче-
ского вывода, например, для цели ?– first_man(A), ancestor(X, A).
(«Кто предок первого человека?»)
Разумеется, в данной программе должны быть и другие опреде-
ления (определения других предикатов). Например, определения предикатов first_man/1 и parent/2.
Первое из них, очевидно, состоит из одного факта
first_man(Адам).
А второе определение может содержать множество фактов типа
parent(Иван, Пётр). parent(Анна, Пётр). parent(Пётр, Сергей).
…
4. Сопоставление структур данных в Прологе
Впроцессе логического вывода методом резолюций, реализованном в Прологе, на каждом этапе производится действие, о котором шла речь в предыдущей лекции – это унификация двух литералов. (Напомним, что если положительный и отрицательный литералы в двух дизъюнктах унифицируются, то к ним применяется правило резолюции.)
ВПрологе этими литералами являются:
31

подцель запроса (целевого утверждения);
какой-нибудь факт или левая часть какого-нибудь правила определения предиката.
Механизм унификации двух литералов является одним из двух наиважнейших механизмов Пролога. Он называется также «сопос-
тавлением структур» или «сопоставлением образцов». В искусственном интеллекте используется также термин: «pattern matching».
(О втором механизме – автоматическом возврате – пойдёт речь ниже.)
Сопоставление структур в Прологе осуществляется по следующему алгоритму:
Прежде всего, устанавливается договорённость, что в каждой исходной структуре нет переменных, которые есть в другой структуре, вне зависимости от того, как они обозначаются.
Сопоставляемые структуры просматриваются синхронно слева направо.
Если обе структуры – это атомоподобные термы, то для успешного сопоставления они должны быть одинаковыми.
Если одна из структур – переменная, а другая нет, то переменная получает значение, равное другой структуре. Затем это значение присваивается всем вхождениям этой переменной в обеих исходных структурах.
Если обе структуры переменные, то они заменяются одной переменной, этой же переменной заменяются и все вхождения сопоставляемых переменных в исходных структурах.
Если обе структуры – сложные термы, то их функторы (имена) должны быть одинаковыми, при этом алгоритм сопоставления должен успешно завершиться для всех пар компонентов, просматриваемых слева направо.
Можно убедиться в том, что данный алгоритм даёт результат, согласующийся с тем, который был рассмотрен на предыдущей лекции в Примере 1.5.
Пример 2.4. Рассмотрим результаты каждого шага алгоритма, приводящего к какой-нибудь замене:
Исходные структуры:
p(f(X, b), X, g(X), V), p(Y, a, Z, g(W)).
32

Шаг 1. p(f(X, b), X, g(X), V), Шаг 2. p(f(a, b), a, g(a), V), Шаг 3. p(f(a, b), a, g(a), V), Шаг 4. p(f(a, b), a, g(a), g(W)),
p(f(X, b), a, Z, g(W)). p(f(a, b), a, Z, g(W)). p(f(a, b), a, g(a), g(W)). p(f(a, b), a, g(a), g(W)).
Итак, обе исходные структуры успешно сопоставились.
5.Логический вывод – сведение целевого утверждения к пустому дизъюнкту
При поиске ответа на запрос к базе данных, как было отмечено ранее, в Прологе реализована стратегия линейной резолюции. Рассмотрим, что представляет собой каждый шаг алгоритма логического вывода в соответствии с этой стратегией.
Шаг 1. Берётся первая подцель C1 целевого утверждения ?– C1, …, Cm. и выбирается фрагмент базы данных Пролога (определение предиката p/n), который соответствует этой подцели. Если такого определения в базе данных нет, то происходит «откат» – возврат к последнему применению шага 2 данного алгоритма и отмена производимой в этом пункте замены, после чего ищется другой возможный результат. Если «откат» невозможен, логический вывод завершается неуспехом – производится переход к шагу 5 данного алгоритма.
Шаг 2. В выбранном фрагменте БД (определении предиката) утверждения просматриваются по порядку до тех пор, пока не найдётся утверждение, подходящее для сопоставления. Это означает, что: а) если утверждением является факт, то он сопоставляется с подцелью, б) если утверждением является правило, то с подцелью сопоставляется левая часть этого правила. После этого производится соответствующее сопоставление, и в случае а) подцель C1 удаляется из целевого утверждения, а в случае б) подцель C1 заменяется правой частью соответствующего правила. Если же сопоставления найти не удаётся ни для одного утверждения данного фрагмента, производится «откат», описанный в шаге 1 алгоритма.
Шаг 3. В случае а) целевое утверждение становится на одну подцель «короче», а в случае б) в нём появятся новые подцели. Случай а) может привести к тому, что целевое утверждение не будет содержать ни одной подцели. Это означает, что логический вы-
33
вод успешно завершён, – производится переход к шагу 5 данного алгоритма. В противном случае производится переход к шагу 4.
Шаг 4. Найденный унификатор применяется ко всем (!) подцелям нового целевого утверждения и производится переход к шагу 1 данного алгоритма.
Шаг 5. Конец алгоритма.
Следует отметить, что рассмотренный алгоритм не даёт гарантии успешного или неуспешного завершения: он может, попросту, «зациклиться» по причине наличия рекурсивных правил в базе данных Пролога. Так, кстати, часто и бывает, когда определения некоторых предикатов сделаны не удачно. (Например, правильно с точки зрения логики, но неправильно с точки зрения процедурной семантики Пролога.)
Пример 2.5. Заменим последнее правило определения преди-
ката ancestor/2 из Примера 2.3
ancestor(X, Y) :- parent(X, Z), ancestor(Z, Y). % Родитель предка есть предок.
другим, казалось бы, не менее корректным с точки зрения логики, правилом:
ancestor(X, Y) :- ancestor(X, Z), parent(Z, Y). % Предок родителя есть предок.
Будем считать, что этот предикат используется не только для поиска предков какого-нибудь человека, как это было в Примере 2.3, но и наоборот – для поиска потомков какого-нибудь человека.
После проведенной замены логический вывод для цели
?– ancestor(Иван, Y).
(если ищутся не дети, а внуки и правнуки Ивана) не завершится никогда!
Автор полагает, что его слушатели и читатели начинают ясно сознавать, что программирование на Прологе – это далеко не ремесло, а искусство и овладеть им многим бывает весьма нелегко.
Примеры логического вывода
Пример 2.6. Рассмотрим программу на Прологе, представленную кодом 2.2.
34
Код 2.2
дедушка(X, Y) :– отец(X, Z), отец(Z, Y).
дедушка(X, Y) :– отец(X, Z), мать(Z, Y).
отец(отец(X), X). % У каждого человека есть отец мать(мать(X), X). % У каждого человека есть мать ?– дедушка(X, Y). % Существует ли дедушка?
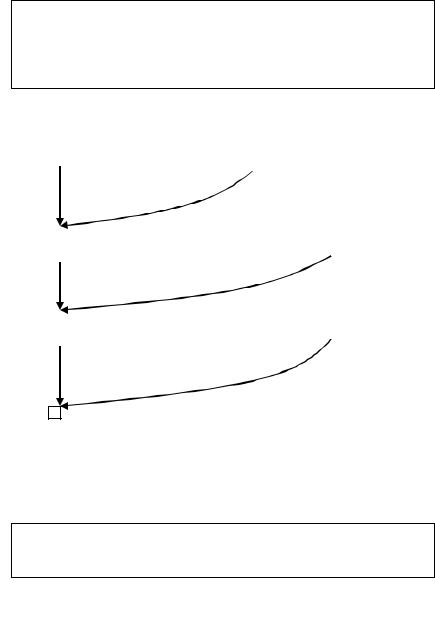
Логический вывод быстро, без возвратов, приводит к решению, представленному на рис. 2.4.
?– дедушка(X, Y).
дедушка(X1, Y1) :– отец(X1, Z), отец(Z, Y1).
X=X1; Y=Y1
?– отец(X1, Z), отец(Z, Y1). |
отец(отец(X2), X2). |
||
|
|
X1=отец(X2); Z=X2 |
|
?– отец(X2, Y1). |
отец(отец(X3), X3). |
||
|
|
X2=отец(X3); Y1=X3 |
|
|
|
|
|
|
|
|
|
Рис. 2.4. Пример логического вывода для цели ?– дедушка(X, Y).
«Квадратиком» на рис. 2.4 обозначен успех логического вывода. Побочный эффект: X=отец(отец(X3)); Y=X3.
Экспресс-эксперимент на компьютере даёт ожидаемый результат: «У каждого человека дедушка существует – и это отец отца»:
| ?- дедушка(X, Y).
X= отец(отец(Y)) ,
Y= _
35