Материал: 5856

81
не менее, эти матрицы существуют и имеют следующий вид:
g(x) |
|
|
||
|
|
|
|
|
xg(x) |
|
|
||
G x2 g(x) |
|
, |
||
|
|
|
|
|
............. |
|
|
||
|
|
|
|
|
|
r 1 |
|
|
|
x |
|
g(x) |
|
|
(h(x))c(xh(x))c
H (x2h(x))c
..............
(xk 1h(x))c
,
(3.48)
где (h(x))c - полином, согласованный с h(x), то есть коэффициенты этого по-
линома записаны в обратном порядке |
hcj hn 1 j . Например, при n=7 для |
h(x) 1 x x2 x4 имеем (h(x))c x2 x4 x5 |
x6 . |
Рассмотрим конкретный пример. Для (n,k) – кодов с кодовым расстоянием три, исправляющих все однократные ошибки (циклических кодов Xэмминга), в Приложении 1 приведены следующие возможные значения параметров: (7,4), (15,11), (31,26), и т.д. Проанализируем наиболее короткий код (7,4). Для него даны два варианта производящего полинома: g(x) 1 x x3 либо g(x) 1 x2 x3 . Коды, построенные на основе любого из них, оказываются разными, но эквивалентными. Выберем для определённости первый полином g(x) 1 x x3 .
Далее найдём проверочный полином из соотношения (3.44), для этого выполним деление (1 xn ) на g(x) столбиком (рис.3.2).
|
x7+1 |
x3+x+1 |
|
+ x7+x5+x4 |
|
|
|
x4+x2+x+1 |
|||
|
x5+x4+1 |
|
|
|
+ x5+x3+x2 |
|
|
x4+x3+x2+1
+ x4+x2+x
x3+x+1 + x3+x+1
0
Рис.3.2. Вычисление проверочного полинома для (7,4)-кода
Таким образом, проверочный полином имеет вид h(x) 1 x x2 x4 . Пользуясь способом (3.54), запишем производящую и проверочную
матрицы
1101000 |
|
|
0010111 |
|
|
|
|
|
|
||
G 0110100 |
, |
H 0101110 . |
(3.49) |
||
0011010 |
|
|
|
||
|
|
|
1011100 |
|
|
|
|
|
|
||
0001101 |
|
|
|
|
|
Убедитесь, что эти матрицы удовлетворяют соотношению (3.18).
82
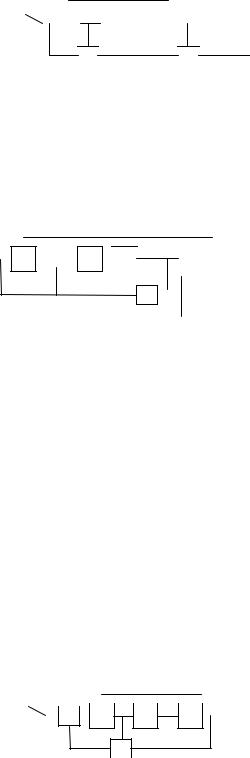
Схема кодера, реализующего метод (3.45) в соответствии с рис. 2.10, приведена на рис. 3.3. Ячейки регистра обнуляются, затем при замкнутом
|
К |
|
|
|
|
ТИ |
|
||||||
a3,…,a0 |
о о |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
s6,…,s0 |
|
|
|
|
|
M2 |
|
|
|
|
|
M2 |
|
||
|
g0 |
|
|
g1 |
|
g2 |
|
g3 |
|
||||
Рис. 3.3. Схема кодера несистематического (7,4)-
кода на основе производящего полинома
ключе K в кодер вводятся 4 информационных символа, при этом в схеме вычисляются и выводятся 4 первых символа кодовой комбинации. Далее
ключ K размыкается, и в течении следующих трёх тактов вычисляются и вы-
g0 |
|
g1 |
g2 |
|
g3 |
|
|
|
|
|
|
|
|
|
|
||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
ТИ |
||
|
|
|
|
|
|
|
|
|
|
1 |
|
|
|
П |
s0,…,s6 |
||
|
M2 |
|
|
|
|
|
|
|
о |
||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
о |
|
|
|
|
|
|
|
|
|
|
|
|
|
о |
|
|
|
|||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||
|
|
|
|
|
|
|
|
|
|
|
|||||||
|
|
|
|
|
|
|
|
2 |
|
|
|
|
|||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||
|
|
|
|
|
|
M2 |
|
|
|
|
|
|
|
|
|||
a0,…,a3 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
водятся значения
Схема кодера систематического кода, реализующая метод (3.34), дана на рис. 3.4.
Это схема деления полинома xr a(x) на полином g(x), но, в отличие от схемы рис.2.11, она построена несколько иначе, поскольку ориентирована не на вычисление частного, а на вычисление остатка. Регистр обнуляется, переключатель П переводится в положение 2, и в течение 4 тактов в кодер вводят 4 информационных символа. Одновременно эти символы поступают на выход в качестве информационной части кодовой комбинации s6 a3 ,..., s3 a0
(обратите внимание, что ввод и вывод производятся в обратном порядке, начиная с коэффициентов при старших степенях x). В это время в регистре с обратными связями начинается вычисление остатка. Затем переключатель П переводится в положение 1, отключая вход, и в течение следующих 3 тактов
|
К |
|
|
|
|
|
|
|
ТИ |
|||
v0,…,v6 |
о |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||
о M2 |
|
|
|
|
|
|
||||||
|
|
|
|
|
||||||||
M2
|
|
|
g3 |
g0 |
g1 |
g2 |
Рис. 3.5. Схема декодера (7,4)-кода на основе производящего полинома
83
завершается вычисление остатка и его элементы выводятся на месте проверочных символов кодовой комбинации
Схема декодера, приведённая на рис. 3.5, также ориентирована на вычисление остатка от деления полинома v(x) на полином g(x) (формула (3.43)), поэтому она практически не отличается от предыдущей схемы. Регистр обнуляется, ключ K замыкается, и в течение 7 тактов в регистр вводятся 7 символов принятой комбинации, начиная с v6 (старшего разряда). После завершения ввода в ячейках регистра оказывается записанным значение остатка res(x). Если res(x)=0 (в 3 ячейках регистра оказались нули), считают, что в принятой комбинации ошибок нет, и на этом декодирование заканчивается.
В противном случае (res(x) 0) , ключ К размыкается (фактически это соответствует ситуации, когда последующие входные символы равны нулю), и подают ещё 7 тактовых импульсов, формально продолжая процесс деления. Номер такта, на котором в ячейках регистра оказывается комбинация 100 (это случай res(x)=1, учитывается обратный порядок следования символов), и есть номер ошибочного символа. После этого исправление этого символа и отделение информационных символов – это тривиальные операции.
Чтобы не было сомнений, заметим, что ожидаемая комбинация 100 в течение 7 тактов обязательно появится, причём один раз. Дело в том, что при отключении входа схема рис. 3.5 превращается в генератор двоичной псевдослучайной М-последовательности с периодом (2.21) равным 7. Свойства
М-последовательности таковы, что в течение периода в ячейках генератора обязательно по одному разу оказываются записанными все r-разрядные двоичные комбинации, кроме нулевой, разумеется.
Обратите внимание, что наличие сумматоров на стыках между ячейками регистра сдвига определяется значениями коэффициентов полинома g(x): сумматор есть, если g j 1, и он отсутствует, если g j 0 . Таким образом, зная
g(x), можно сразу составить схемы кодера и декодера для любого циклического кода (или схему генератора М-последовательности).
Как показывает практика, формальное запоминание приведённых соотношений и схем мало что даёт для понимания сути вопроса, если детально не разобрать хотя бы десяток конкретных численных примеров. В частности, если нужно закодировать информационную последовательность 0011, для которой a(x) x2 x3 , то, проследив такт за тактом работу схемы рис.3.4 и записывая содержимое ячеек, можно убедиться в том, что на выходе появится комбинация 1100010, которой соответствует полином s(x) x x5 x6 (значение этого полинома вычислите отдельно по формуле (3.46) и сравните с комбинацией).
В заключение обязательно нужно отметить следующее обстоятельство. Благодаря циклическому свойству, при кодировании и декодировании циклического кода удаётся организовать конвейерную обработку длинных по-
84
следовательностей символов в устройствах, содержащих удивительно малое количество простейших логических элементов. Например, для кода (255,247) кодер и декодер содержат по 8 ячеек регистра сдвига и по 4 сумматора по модулю 2. Благодаря этому ценному качеству среди всевозможных линейных блочных кодов именно циклические коды нашли наиболее широкое применение.
Более того, в последнее время нашли широкое применение недвоичные циклические коды – это коды Рида-Соломона.
Каждые символ кодовой комбинации такого кода является М-ичной цифрой, где, как обычно, M = 2m, причем m – целое число. Как и у любого другого линейного блочного (n,k)-кода, кодовое слово кода Рида-Соломона (обозначается RS(n,k)) содержит n символов, из них k информационных и r проверочных, причем n = M–1.
Гарантировано, что при декодировании в кодовом слове будут обнаружены и исправлены t = r/2 символов независимо от их расположения внутри кодового слова. Параметр t носит название корректирующей способности кода. Либо могут быть восстановлены r стертых символов.
RS(n,k)-код также полностью определяется производящим полиномом степени r, но коэффициенты полинома – это М-ичные цифры. Кодер и декодер строятся по схеме регистра сдвига с обратными связями, но ячейки регистра рассчитаны на хранение М-ичных цифр, такими же являются и весовые коэффициенты, а суммирование проводится по модулю М.
На практике при использовании RS(n,k)-кода последовательность двоичных символов, поступающих на вход кодера, разбивают на группы, допустим, по k = 8 бит в каждой, и долее с каждым байтом оперируют как с 256ичным символом. В итоге кодовое слово будет фактически содержать 8 (28 1) 2040 бит. Если код содержит, например, 40 проверочных символов, то он может исправить до 160 ошибочных бит при условии их кучного расположения в байтах. Отсюда видно, что RS(n,k)-код неплохо работает при наличии пакетов ошибок.
3.5 Декодирование в СПИ с каналом переспроса
Рассмотрим ситуацию, когда кроме прямого канала, предназначенного для передачи информации из пункта A в пункт B, существует ещё вспомогательный обратный канал из пункта B в пункт A, называемый каналом переспроса. Единственное назначение этого канала – повысить достоверность передачи информации в прямом канале.
Пакеты, передаваемые в прямом канале, кодируются блочным кодом, и
в пункте B осуществляется лишь обнаружение ошибок в принятой n-
разрядной комбинации. После завершения этой процедуры в канал переспроса передаётся всего один бит, два возможных значения которого имеют, до-
85
пустим, следующий смысл: 0 – ошибок не обнаружено, нужно передавать следующую комбинацию; 1 – обнаружение ошибки, нужно ещё раз передать данную комбинацию. Возможны такие неблагоприятные ситуации, когда повторная передача будет проводиться более чем один раз.
В такой системе получателю будет выдана ошибочная комбинация, если произойдёт хотя бы одно из событий:
1) в принятой комбинации произошли ошибки слишком высокой кратности q dкод , которые не способен обнаружить применяемый код (см. формулу (3.5)). Вероятность такого события
|
n |
|
Pп |
P(q) , |
(3.50) |
|
q dкод |
|
|
|
где P(q) – вероятность того, что ровно q бит в принятой n-разрядной комбинации являются ошибочными. В канале с независимыми ошибками эту вероятность можно найти по биномиальной формуле Бернулли
|
|
|
P(q) Cnq pq (1 p)n q , |
(3.51) |
где Cnq |
n! |
- число сочетаний из n по q, |
|
|
|
|
|
||
q!(n q)! |
|
|||
|
|
|
||
p – вероятность ошибки в одном символе, то есть в длинной последовательности символов, передаваемых в прямом канале, одна ошибка появляется
всреднем на 1/p символов;
2)произошла ошибка в обратном канале. Обозначим вероятность этого
события Ро.
В итоге вероятность выдачи ошибочной комбинации найдём по формуле сложения вероятностей
P |
P P P P . |
(3.52) |
ош |
п o п o |
|
На практике обычно Pп<<1, Po<<1, поэтому Pош Pп Po .
В СПИ без канала переспроса в пункте B приходится не только обнаруживать, но и исправлять ошибки, при этом вероятность выдачи ошибочной комбинации равна
|
n |
|
|
Pош1 |
|
P(q), |
(3.53) |
|
q qи 1 |
|
|
|
|
|
где qи - максимальная кратность исправляемых ошибок (3.6).
Численные расчёты показывают, что при той же величине избыточности R=r/n СПИ с обратным каналом обеспечивает большую помехоустойчивость, если ошибки в прямом канале происходят редко ( pn 1), а обратный канал ещё более надёжен (Po Pп ) .
Рассмотрим пример. Пусть задано p 10 4 , Po 10 8 , в прямом канале
применяется код Xэмминга (127,120). Тогда имеем