Материал: 5856
86
Pп P(3) ... P(127) P(3)
125 126 127 10 12 0, 9999124 3, 3 10 7 , 6
причём опущены слагаемые P(4), P(5),…, вносящие несущественный вклад. Для итоговой вероятности ошибок имеем
Pош 3,3 10 7 10 8 3,3 10 15 3, 4 10 7 .
В отсутствие канала переспроса тот же код используем для исправления ошибок (всего лишь однократных) и имеем
Pош1 P(2) ... P(127) P(2)
126 127 10 8 0, 9999125 7, 9 10 5 , 2
то есть вероятность ошибки намного выше.
Вероятность повторной передачи комбинации в СПИ с переспросом в нашем примере
Pповт P(1) P(2) P(1) 1, 26 10 2 ,
то есть в среднем примерно одна из 80 комбинаций будет передаваться повторно, что ненамного увеличивает избыточность, хотя ресурс времени для повторных передач, разумеется, нужно выделять.
Если декодер выдал ошибочную комбинацию, то это будет другая комбинация из кодовой таблицы, скорее всего, наиболее близкая к той комбинации, которая в действительности была передана (вспомним, что в реальных СПИ наиболее вероятно появление ошибок малых кратностей). Следовательно, в такой комбинации из общего количества n символов лишь dкод символов являются ошибочными. Тогда битовая вероятность ошибки на выходе деко-
дера приближенно равна
p |
P |
dкод |
, |
|
b |
ош |
n |
(3.54) |
|
|
|
|||
то есть на выходе декодера одна ошибка появляется в среднем на 1/pb бит. Естественно, что метод переспроса достаточно широко применяется в
современных цифровых СПИ.
3.6 Свёрточные коды
Среди неблочных кодов наибольшее применение нашли сверточные коды. На выходе кодера формируется непрерывная последовательность связанных между собой двоичных символов так, что в этой последовательности нельзя выделить блоки, независимые от других, для того, чтобы декодировать их раздельно.
Тем не менее ради удобства свёрточный код также характеризуют двумя положительными числами n и k. Отношение этих чисел k/n называется степенью кодирования (k n) . Это значит, что в бесконечно длинной после-
87
довательности на выходе кодера на каждые n передаваемых символов приходится k информационных и r = n – k проверочных символов. Избыточность кода при этом, как обычно, определяется отношением R = r/n.
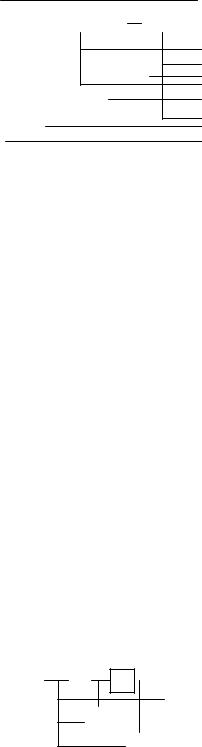
Кодер свёрточного кода содержит К-разрядный регистр сдвига, n многовходовых сумматоров mod2 и n-входовый мультиплексор (рис. 3.6). Целое число К называется длиной кодового ограничения по входу.
Инф. |
|
|
К ячеек регистра сдвига |
|
|
|
|
|
|
|
|
||||||||||||||||
|
|
|
|
|
|
|
|
||||||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
1 |
2 |
... |
k |
|
1 |
2 |
... |
k |
|
1 |
2 |
... |
k |
|
|
|
|
|
||||||||
биты |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
M21 |
|
MUX |
|
|||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
M22 |
|
|
|
|||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
M2n |
|
|
|
|||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||
Рис. 3.6. Общая схема кодера сверточного кода со степенью кодирования k/n
В течение k тактов в регистр сдвига быстро вводятся очередные k информационных символов, а затем мультиплексор совершает цикл опроса сумматоров, выдавая очередные n символов на выход кодера. Далее указанный цикл многократно повторяется в той же последовательности.
Способ подключения каждого сумматора к ячейкам регистра сдвига определяется либо вектором связи g (g0 , g1,..., gK 1) , либо соответствующим
ему генераторным полиномом |
g(x) g |
0 |
g x ... g |
K 1 |
xK 1 |
, причём обычно на |
|
|
1 |
|
|
вход одного сумматора подаётся не более чем по одному символу из каждой k-разрядной информационной подпоследовательности.
Таким образом, для полного описания способа кодирования нужно задать n векторов связи (генераторных полиномов). Если k первых генератор-
ных полиномов равны g0 (x) 1, g1 (x) x , ..., gk 1 (x) xk 1 , получается систематический свёрточный код, у которого из каждых n позиций первые k позиций занимают информационные символы.
В качестве примера рассмотрим очень простой систематический свёрточный код, у которого довольно низкая степень кодирования k/n = 1/3, высокая избыточность R = 2/3 и небольшая длина кодового ограничения К=3.
Зададим для этого кода три генераторных полинома |
|
|||||||||||||||
g1 (x) 1, |
g2 (x) 1 x , |
g3 (x) 1 x2 , |
(3.55) |
|||||||||||||
из которых g1 (x) генерирует (точнее, |
тождественно передаёт) информацион- |
|||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||
|
|
|
|
|
|
|
|
|
|
|
|
|||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
MUX |
|
|
|
|||
|
|
|
|
M2 |
|
|
|
|
|
|
|
|
|
|
||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
|
|
|
|
|
|
|
|
M2 |
|
|
|
|
|
|||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Рис. 3.7. Схема кодера систематического сверточного кода для k/n=1/3
88
ную последовательность (И), а g2 (x) и g3 (x) генерируют первую (П1) и вто-
рую (П2) проверочные последовательности соответственно. Схема кодера дана на рис. 3.7.
В таблице 3.4 для заданной информационной последовательности показано, каковыми оказываются обе проверочные последовательности и последовательность на выходе кодера.
Существуют разные способы декодирования свёрточных кодов. Один из самых простых – это метод порогового декодирования.
Таблица 3.4. Последовательности символов в кодере свёрточного кода k/n=1/3
И |
1 |
0 |
1 |
1 |
0 |
0 |
1 |
… |
П1 |
|
1 |
1 |
0 |
1 |
0 |
1 |
… |
П2 |
|
… |
0 |
1 |
1 |
1 |
1 |
… |
Выход |
|
… |
110 |
101 |
011 |
001 |
111 |
… |
кодера |
|
|
|
|
|
|
|
|
Опишем его суть на приведённом примере. На очередном шаге, переходя к рассмотрению очередного информационного символа, пытаются ответить на вопрос, есть ли в этом символе ошибка. Для этого по принятым информационным символам по тем же правилам (рис. 3.7) вычисляют две новые проверочные последовательности. В итоге для анализа имеется пять последовательностей: информационная, две принятые проверочные и две новые проверочные (табл. 3.5).
Таблица 3.5. Последовательности симвлов, участвующие в пороговом декодировании
|
и |
и |
и и и и |
Принятые |
п1 |
п1 |
п1 п1 п1 п1 |
|
п2 п2 п2 п2 п2 п2 |
||
Новые |
п1 |
п1 |
п1 п1 п1 п1 |
|
п2 п2 п2 п2 п2 п2 |
||
Далее попарно сравнивают принятые и вычисленные проверочные символы, причём в этой процедуре участвуют лишь те проверочные символы, которые зависят от данного информационного символа (они помечены в табл. 3.5). Выносимое решение (исправлять данный информационный символ или оставить без изменения) определяется количеством совпадающих пар. Если число совпадающих пар меньше порога, равного двум, информационный символ изменяют на противоположный. Рассмотрев различные варианты расположения ошибок в полученной пятёрке принятых символов, следует убедиться, что таким способом выбирается наиболее правдоподобное ло-
89
кальное решение.
Кстати, этот же метод декодирования можно представить в другой интерпретации: рассматриваются два возможных варианта значений текущего информационного символа (0 или 1) и для каждого варианта вычисляются ожидаемые значения всех пяти символов. Выбирается тот вариант, для которого ожидаемые значения символов в этой пятёрке ближе к тому, что наблюдается в действительности (по количеству совпадений).
Именно эта идея реализуется в более сложных алгоритмах декодирования, причём рассматриваются различные варианты не для одного, а для целой серии предыдущих информационных символов. Ширина окна декодирования – это число последних принятых символов, которое нужно хранить в декодере. С увеличением этой ширины увеличивается объём вычислений, но зато все лучше используются потенциальные возможности кода. Предел улучшения обычно наступает, когда ширина окна существенно превышает полную длину кодового ограничения.
Разумный компромисс обеспечивают хорошие современные алгоритмы декодирования, основанные на том, что анализ выбранного варианта заканчивается досрочно и он отбрасывается, если в процессе анализа уже наблюдаются существенные расхождения ожидаемого с действительным. Один из самых эффективных – алгоритм декодирования Витерби, позволяющий приблизиться к потенциальным характеристикам кода, но у него объем вычислений при декодировании растет экспоненциально с увеличением длины кодового ограничения, поэтому она обычно не более десяти.
Одно из главных достоинств свёрточного кода – простота реализации, позволяющая проводить кодирование с высокой скоростью. Другое достоинство – это способность обнаруживать и исправлять пакеты (вспышки) ошибок, если длина пакета меньше чем К.
Корректирующая способность несистематических кодов несколько выше, но они могут быть катастрофическими, то есть после серии неудачных исправлений может возникнуть бесконечное число ошибок на выходе декодера. Нужно, чтобы n производящих многочленов не имели общих делителей.
Для ослабления подобных эффектов иногда используют следующий приём: непрерывный свёрточный код искусственно превращают в “блочный”, то есть периодически прекращают подачу информационных символов на вход кодера на время, достаточное для того, чтобы вывести содержимое кодера и очистить регистры декодера.
3.7 Перемежение символов
Анализ свойств помехоустойчивых кодов показывает, что корректирующая способность любого блочного кода ограничена. В частности, код мо-
90
жет правильно воспроизвести кодовую комбинацию лишь в том случае, когда количество ошибочных символов в ней мало, а именно, удовлетворяет условию (3.6).
Вканале с независимыми ошибками кодовое расстояние dкод всегда можно выбрать так, что подавляющее большинство ошибочных комбинаций будет удовлетворять этому условию, следовательно, ошибки в них будут исправлены. Главное, что избыточность при этом не слишком велика, то есть применение кодирования оказывается эффективным.
Вканале с группированием ошибок при том же их общем количестве оказывается, что большинство комбинаций вообще не содержит ошибок. В остальных комбинациях их так много, что код не может их исправить. И в том, и в другом случае применение корректирующего кода оказывается бесполезным и даже вредным: энергию, которая затрачивается на передачу проверочных символов, лучше было бы целиком вложить в информационные символы, то есть вообще отказаться от помехоустойчивого кодирования. Подобный эффект производит и воздействие импульсных помех.
То же самое, правда, в более завуалированной форме, происходит и при использовании сверточных кодов.
Из сказанного ясно, что если уж использовать помехоустойчивое кодирование, то очень полезным был бы способ, позволяющий ошибки из пакетов более или менее равномерно распределять по кодовым комбинациям. Именно для этого предложен метод, который носит название перемежение
(interliving).
Наиболее широко применяется перемежение по времени (последовательный способ передачи), хотя в последнее время в системах радиосвязи начинает использоваться перемежение по частоте (параллельный способ передачи).
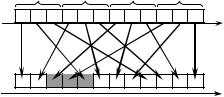
Весьма популярен табличный способ перемежения по времени. Для этого n-разрядные комбинации с выхода кодера записываются в виде строк прямоугольной таблицы. После заполнения m-строк считывание и передача в линию производится по столбцам. В приемнике осуществляется обратное преобразование: запись по столбцам, считывание и подача на вход декодера
–по строкам. Это эквивалентно перемещению символов во времени, показанному на рис. 3.8. В показанном примере, если в линии возникает пакет,
а)
t
б)
t
Рис. 3.8. Схема, иллюстрирующая табличный способ перемежения по времени (n = 3, m = 4):
а) последовательность символов с выхода кодера; б) последовательность символов, подаваемых в линию