Материал: 5856
101
рой вероятность ее появления, естественно, равна сумме вероятностей объединяемых букв.
Процесс кодирования удобно графически иллюстрировать при помощи горизонтально расположенного дерева (слева – ветви, справа – корень), у которого всегда две ветви объединяются в одну, более крупную. Объединяемые ветви обозначаются двоичными цифрами: верхняя – 1, нижняя – 0. Чтобы записать кодовое слово, соответствующее данной букве, нужно двигаться к ней от корня дерева и считывать эти двоичные цифры.
Пример. Закодировать буквы алфавита, приведенного в табл. 4.2, и оценить избыточность полученного кода.
Таблица 4.2 – Пример ряда распределения вероятностей букв алфавита
xj |
x1 |
x2 |
x3 |
x4 |
x5 |
x6 |
p(xj) |
0,1 |
0,2 |
0,25 |
0,05 |
0,25 |
0,15 |
Энтропия источника сообщений равна
H(X) = –0,1 log0,1 – – 0,15 log0,15 = 2,423 бит/букву.
Очевидно, что из-за неравновероятности букв алфавита сообщение на выходе источника имеет избыточность
Rs 1 H(X ) / H(X )max 0,0627,
где H(X)max = logs = 2,585 бит/букву.
Кодовое дерево показано на рис. 4.2, где в разрывах ветвей указаны суммарные вероятности объединяемых букв.
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
0,55 |
1 |
|
|
|
|
|
|
|
|
|
|
|
0,45 |
|
|
|
|
|
|
|
|
|
1,00 |
||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||
Комби- |
xj |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||
|
|
|
|
|
|
|
|
|
|
|
1 |
|
|
0 |
|
||||||
нация |
|
|
|
|
|
|
|
|
|
|
|
|
|
0,30 |
|
|
|
||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
10 |
x3 |
|
|
0,25 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
0 |
|
|
|
|
|
||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
01 |
x5 |
|
|
0,25 |
|
1 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
00 |
x2 |
|
|
0,20 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
0 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
111 |
x6 |
|
|
0,15 |
|
|
|
|
|
|
1 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
1101 |
x1 |
|
|
0,10 |
|
1 |
0,15 |
|
|
|
|
|
|
|
|
|
|
|
|
||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
1100 |
x4 |
|
|
0,05 |
|
|
|
|
0 |
|
|
|
|
|
|
|
|
|
|||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||||
|
|
|
|
|
0 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
|
Рис. 4.2. Кодовое дерево кода Хафмана |
|
|
|
|||||||||||||||||
Средняя длина кодового слова (4.14) на выходе кодера равна L = 2 0,25 + + 4 0,05 = 2,45 (бит/букву), и избыточность (4.13) этого сигнала
102
составляет R = 1 – 2,423/2,45 = 0,011.
Итак, алфавит источника удалось закодировать с малой избыточностью, даже меньшей, чем избыточность входного сигнала.
Следует отметить, что использование кода Хафмана позволяет получить сигнал с минимально возможной избыточностью, но из этого не следует, что избыточность сигнала на выходе кодера всегда будет меньше, чем избыточность исходного алфавита. Возможна такая, на первый взгляд парадоксальная ситуация, когда все s букв алфавита равновероятны и, следовательно, входной сигнал не содержит избыточности, но выходной сигнал избыточен. Поэтому еще раз подчеркнем, что кодирование с нулевой избыточностью возможно лишь для распределений вероятностей специального вида, а именно, когда вероятности всех букв могут быть представлены в форме (4.18).
Другой весьма хороший код – это код Шеннона-Фано. Здесь также буквы алфавита предварительно располагаются в порядке убывания вероятностей. Кодирование двоичным кодом проводится в несколько этапов:
1)весь алфавит делится на две группы (верхнюю и нижнюю) так, чтобы суммарные вероятности в каждой из групп были по возможности равны друг другу (к сожалению, если вероятности всех букв не могут быть представлены в виде (4.18), при выполнении этой операции возможен субъективный подход); затем для каждой буквы записывается первый символ кодового слова: 1– для букв, попавших в верхнюю группу, и 0 – для букв из нижней группы;
2)каждая группа делится, в свою очередь, на две равновероятные подгруппы, и в каждом кодовом слове записывается второй символ по тому же принципу.
Такое деление и дописывание символов проводится до тех пор, пока в каждой подгруппе не останется по одной букве.
Если m > 2, на каждом шаге проводится деление группы букв на m равновероятных подгрупп и для их нумерации используются символы 0,1,...,(m–
1).
Обратите внимание, что при кодировании и кодом Хафмана, и кодом Шеннона-Фано в самой структуре кодовой таблицы уже заложена возможность разделения при приеме последовательно передаваемых кодовых комбинаций. Например, при кодировании кодом рис. 4.2 принятая двоичная последовательность 0011000100111однозначно декодируется как последова-
тельность букв x2x4x5x2x6 . Это обусловлено тем, что в кодовой таблице никакая комбинация не является началом другой, более длинной комбинации.
При использовании обоих кодов любая, даже одиночная ошибка в принятой последовательности лишает приемник возможности правильно декодировать ее оставшуюся часть, но эту проблему обсуждать не будем, поскольку, напомним, эти коды предназначены исключительно для кодирования при отсутствии помех (реально, в ситуации, когда возможность появле-
103
ния ошибки пренебрежимо мала).
Кодирование блоками, упоминаемое в теореме Шеннона, предполагает использование тех же кодов, но кодовая таблица содержит не отдельные буквы передаваемого текста, а их комбинации (двухбуквенные, трехбуквенные и т.д.), при этом, естественно, нужно указать вероятности появления этих комбинаций. При кодировании n-буквенных комбинаций объем кодовой таблицы равен N = sn, т.е. экспоненциально растет с увеличением длины блоков. Положительный эффект при этом заключается в том, что вероятности всех n- буквенных блоков все более точно могут быть представлены в форме (4.18), т.е. избыточность может быть сделана сколь угодно малой.
Главный недостаток обоих кодов заключаются в том, что для их применения нужно знать вероятности появления букв (или их комбинаций при кодировании блоками), а на практике такая благоприятная ситуация возникает чрезвычайно редко.
Код Лемпела-Зива [1–3] свободен от этого недостатка. Здесь кодовая таблица, изначально почти пустая, заполняется одновременно в пунктах передачи и приема в процессе кодирования (декодирования), причем в эту таблицу вносятся лишь такие все более длинные отрезки передаваемого сообщения, которые еще не встречались ранее. Каждому отрезку в таблице присваивается n-разрядный номер. При внесении очередной записи (строки) в таблицу передается блок, содержащий:
1)номер отрезка, уже имеющегося в таблице;
2)символ, следующий в передаваемом сообщении за этим отрезком. Рассмотрим пример кодирования двоичным кодом Лемпела-Зива дво-
ичного сообщения 0010101000101. Сообщение короткое, поэтому можно взять небольшое значение n = 3.
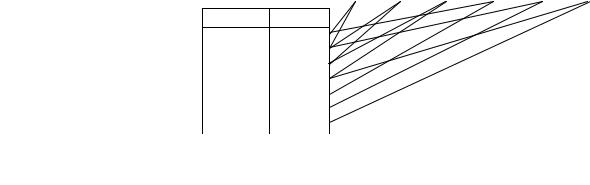
На рис. 4.3 показаны двоичные последовательности на входе и выходе кодера, причем ради наглядности они разбиты на части, соответствующие отдельным шагам. Сплошные линии указывают, какие номера извлекаются из кодовой таблицы и подаются на выход кодера. Штриховые линии показывают путь внесения очередных записей в кодовую таблицу (первая запись “пробел” и его номер 000 внесены в таблицу заранее). Убедитесь, что по передаваемой последовательности в пункте приема можно в том же порядке заполнять кодовую таблицу и декодировать сигнал.
Для дальнейшего сокращения избыточности полезно те отрезки в кодовой таблице, для которых уже существуют всевозможные более длинные по-
Вход |
0 |
01 |
010 |
1 |
00 |
0101 |
Выход |
0000 |
0011 |
0100 |
0001 |
0010 |
0111 |
Отрезок Номер
-000
0 |
001 |
01 |
010 |
010 |
011 |
1 |
100 |
00 |
101 |
0101 |
110 |
Рис. 4.3. Пример кодирования кодом Лемпела-Зива
104
следовательности (длина больше на единицу), исключать из таблицы и повторно использовать освободившиеся номера. Например, поле записи отрезка 00 можно было бы исключить отрезок 0, т.к. для него уже существуют более длинные 01 и 00, но мы эту операцию не выполняли.
Из приведенного примера видно, что код Лемпела-Зива даже увеличивает избыточность при кодировании коротких сообщений (на входе было 13 бит, а на выходе стало 24), однако при кодировании более длинных сообщений это соотношение постепенно улучшается. Доказано, что асимптотически (при увеличении длины сообщения) избыточность этого кода стремится к нулю.
Код Лемпела-Зива является основой многих процедур архивирования файлов.
Все рассмотренные выше методы – это универсальные методы, позво-
ляющие кодировать любое цифровое сообщение без потери информации.
Разработаны также специализированные методы, каждый из которых предназначен для кодирования сообщений определенного вида (голосовых, видеоизображений и т.п.) и основан на учете особенностей данного вида [2– 4]. Кодирование такими методами производится с частичной потерей информации, что выливается в погрешности при восстановлении сообщения в приемнике. Можно увеличить степень сжатия за счет увеличения погрешностей.
4.3Взаимная информация
Вканале с помехами возможны ситуации, когда принятое значение m-
ичного символа yk отличается от переданного значения xj, хотя в нормальных условиях все-таки более вероятно, что k=j. В принципе, возможно появление
любой пары xj, yk.
Количество информации, извлекаемой получателем из принятого сигнала yk, когда в действительности передавалось сообщение xj, К. Шеннон предложил определять по формуле
I ( x |
; y |
|
) log |
p( x j / yk ) |
. |
|
|
k |
|
|
|||||
j |
|
|
p( x j |
) |
|
(4.19) |
|
|
|
|
|
|
|||
Отметим некоторые очевидные свойства величины (4.19). 1) Свойство симметрии
I ( x |
; y |
|
) I ( y |
|
; x |
|
) log |
p( x j / yk ) |
|
|
|||
k |
k |
j |
|
|
|||||||||
j |
|
|
|
|
|
|
p( x j ) |
|
|||||
|
|
|
|
|
|
|
|
|
|
|
|||
|
|
|
log |
p( yk / x j ) |
log |
p( x j , yk ) |
(4.20) |
||||||
|
|
|
|
|
p( yk ) |
p( x j ) p( yk ) |
|
||||||
|
|
|
|
|
|
|
|
|
|||||
вытекает из формулы умножения вероятностей (1.8). Вследствие того, что значение переданного сообщения xj и значение принятого сигнала yk входят в (4.20) одинаковым образом, эта величина получила более короткое название
105
взаимной информации между xj и yk.
2) В канале без помех возможны лишь пары xj, yj, поэтому для остальных пар находить взаимную информацию просто нет смысла. Для таких пар имеем
I ( x j ; y j ) I ( x j ) I ( y j ), |
(4.21) |
т.к. в таком канале всегда p(xj/yj)= p(yj/xj)=1. В канале без помех, как уже отмечалось, вся информация, создаваемая источником, достигает получателя.
3) Взаимная информация есть разность двух собственных информа-
ций |
|
I ( x j ; yk ) I ( x j ) I x j / yk I ( yk ) I yk / x j . |
(4.22) |
И в канале с помехами при большом отношении сигнал/помеха наибо- |
|
лее вероятным является k=j, поэтому обычно p(xj / y j ) p(x j ) |
и, следователь- |
но, I(xj/yj)<I(xj), тогда I(xj;yj)>0. Но иногда все-таки случается k ≠ j, и в этой ситуации вполне возможно, что I(xj/yk)>I(xj) и, следовательно, количество получаемой информации отрицательно I(xj;yk)<0.
4) Если X и Y независимы (помеха полностью подавляет полезный сигнал), всегда I(xj;yk)=0, т.к. P(xj/yk)=P(xj).
Математическое ожидание случайной величины “взаимная информация” равно
m m |
|
|
|
I ( X ;Y ) p( x j |
, yk )I ( x j |
; yk ) |
(4.23) |
j 1 k 1 |
|
|
|
|
|
|
|
и называется средней взаимной информацией между X и Y, причем вместо |
|||
I(xj;yk) можно подставить любое из трех соотношений (4.20).
Средняя взаимная информация также обладает свойствами: симметрии
I(X;Y)=I(Y;X); в канале без помех I(X;Y)=H(X)=H(Y); для независимых |
X и Y |
всегда I(X;Y)=0, а в общем случае имеем |
|
I ( X ;Y ) H ( X ) H X / Y . |
(4.24) |
Напомним, что Н(Х) ≥ 0 и Н(Х/Y) ≥ 0.
Воспользовавшись неравенством Иенсена для логарифмической функции при Z>0
M log Z log M Z |
(4.25) |
и, положив Zj,k=P(xj)/P(xj/yk), можно показать, что |
|
I(X;Y ) 0 . |
(4.26) |
Отсюда, кстати, следует, что всегда H(X/Y)≤H(X).
В свете сказанного величины, входящие в формулу (4.24), приобретают вполне определенный смысл. Информация H(X), созданная источником, делится на две части:
I(X;Y) – то, что доходит до получателя;
H(X/Y) – то, что потеряно в канале из-за воздействия помех на сигнал. Соотношение между этими двумя частями в первую очередь зависит от
отношения сигнал/помеха.