Материал: 5856
96
|
Ij=-logp(xj) |
3,32 |
0,74 |
2,47 |
3,06 |
. |
|
p(xj) |
0,10 |
0,60 |
0,18 |
0,12 |
|
|
|
Математическое ожидание случайной величины “собственная информация” равно
m |
(4.6) |
H ( X ) M log p( X ) p(x j ) log p(x j ) |
|
j 1 |
|
и называется энтропией сигнала Х.
Для примера (4.5) имеем H(X)=–0,1 log0,1–0,6 log0,6–
–0,18 log0,18–0,12 log0,12= 1,587 бит.
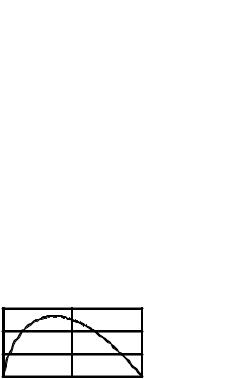
Чтобы упростить подобные однотипные вычисления, в Приложении 2 дана таблица значений функции h(p)= –plog(p), а на рис. 4.1 – ее график.
0,6h(p) |
|
|
|
0,4 |
|
|
|
0,2 |
|
|
|
0,0 |
|
|
p |
0 |
0,5 |
1 |
p |
|
Рис. 4.1. Вспомогательная функция h(p)= –plog2p
Свойства энтропии:
1)Н(Х) 0, причем знак равенства имеет место лишь при детерминированном сигнале Х (это легко показать, убедившись в том, что h(р)=0 лишь при р=0 и при р=1);
2)сигнал Х, имеющий m возможных состояний, обладает максимальной энтропией
H(x) Hmax=logm |
(4.7) |
вслучае, когда все эти состояния равновероятны, т.е. p(xj)=1/m.
Всправедливости этого утверждения можно убедиться, проверив, что “выравнивание” вероятностей любых двух состояний ведет к увеличению энтропии. Действительно, имеем
|
p p |
2 |
|
h( p1 ) h( p2 ), |
|
2h |
1 |
|
|
||
2 |
|
(4.8) |
|||
|
|
|
|
поскольку функция h(р) – выпуклая.
Эти два свойства показывают, что энтропия, в дополнение к своему основному назначению (среднее количество собственной информации в симво-
ле Х) может использоваться как мера неопределенности исхода опыта над случайным объектом Х.
Энтропия Н(Х) – детерминированная величина, поэтому ее удобнее использовать для описания информационного содержания сигналов, нежели
97
набор значений (4.2).
Чтобы увеличить количество возможных вариантов N, передаваемое сообщение обычно формируют в виде последовательности длины n, состо-
ящей из m-ичных символов |
X X , X |
,..., X |
|
, |
|
где каждый символ может |
|||||||||
|
|
|
1 2 |
|
n |
|
|
|
|
|
|
|
|
|
|
принять одно из значений x , x ,..., x , при этом |
N mn . |
|
|
|
|
|
|
|
|||||||
|
1 |
2 |
m |
|
|
|
|
|
|
|
|
|
|
|
|
Собственная информация последовательности x |
|
1 |
2 |
n |
|
определя- |
|||||||||
, x |
|
,..., x |
|||||||||||||
|
|
|
|
|
|
|
|
|
i |
|
j |
|
k |
|
|
ется тем же способом (4.2) |
,..., xk |
) log p(xi , xj |
|
,..., xk |
|
) |
|
|
|
(4.2а) |
|||||
I (xi , xj |
|
|
|
||||||||||||
1 |
2 |
n |
|
|
1 |
|
2 |
|
n |
|
|
|
|
|
|
и, естественно, обладает теми же свойствами. К ним можно добавить лишь свойство аддитивности, вытекающее из формулы умножения вероятностей,
I(xi 1 , xj 2 , xq 3 ,..., xr n 1 , xk n ) log p(xi 1 )
log p(xj 2 / xi 1 ) log p(xq 3 / xi 1 , xj 2 ) ...
log p(xk n / xi 1 , xj 2 ,..., xr n 1 )
(4.9)
I (x |
) I (x |
|
|
/ x |
) I (x |
/ x |
, x |
|
) ... |
|
|
1 |
|
2 |
|
|
1 |
3 |
1 |
2 |
|
i |
j |
|
|
i |
q |
i |
j |
|
|
|
I (x |
n / x |
1 , x 2 ,..., x n 1 ), |
|
|
|
|
||||
k |
i |
|
j |
|
|
r |
|
|
|
|
где обозначение I(a/b) использовано для определения условной собственной информации, т.е. информации, содержащейся в символе а при условии, что к этому времени наблюдателю уже известны значения всех символов, входящих в группу b.
Энтропия последовательности символов также определяется способом
(4.6)
H (X) H ( X 1 , X 2 ,..., X n )
m |
m |
m |
1 |
2 |
n |
1 |
2 |
n |
(4.6a) |
... p(xi , x j |
|
,..., xk |
) log p(xi , x j |
|
,..., xk |
). |
|||
i 1 |
j 1 |
k 1 |
|
|
|
|
|
|
|
Вычисляя формально математические ожидания обеих частей равенства (4.9), видим, что и энтропия последовательности обладает свойством аддитивности
1 |
2 |
1 |
|
H (X) H ( X ) H ( X |
/ X ) ... |
|
|
H ( X n / X 1 , X 2 ,..., X n 1 ). |
(4.10) |
||
Уточняя свойство экстремальности (4.7), отметим, что и энтропия последовательности максимальна
H(X) Hnmax log N nlog m nHmax , |
(4.11) |
когда все N состояний равновероятны. Это возможно лишь в том случае, ко-
гда и для каждого символа все его m состояний равновероятны, а символы в последовательности независимы.
С этим свойством связано весьма важное понятие избыточности сигнала. Сигнал Х обладает избыточностью, если количество информации (эн-

98
тропия) Н(Х), содержащейся в нем, меньше того максимального количества
Hnmax ,которое он в принципе мог бы содержать при тех же m и n. Коэффициент избыточности определяется по формуле
R 1 H(X) Hnmax |
(4.12) |
и может принимать значения 0 R 1. Иногда удобнее использовать другую формулу, приводящую к тому же результату,
R 1 Lmin |
L Lr / L, |
(4.13) |
где L – среднее количество символов в сообщении (среднее значение может быть даже дробным);
Lmin – минимальное среднее количество символов, необходимое для того, чтобы вместить то же количество информации, следовательно, величина Lr есть среднее количество избыточных (“лишних”) символов.
Несмотря на внешнее сходство формул (3.25) и (4.13), они определяют избыточность по-разному: в первом случае – в техническом смысле, а во втором – в более общем, информационном смысле. Результаты вычислений по обеим формулам для сигнала на выходе декодера совпадают в единственном случае, когда двоичный сигнал на его входе не содержит избыточности, то есть все его N=2k комбинаций равновероятны.
Избыточность письменных текстов в любом из европейских языков довольно велика: она составляет 70–80%. Использование различных сокращений есть способ уменьшения избыточности. В иных случаях избыточность сознательно увеличивают, например, указывая сумму прописью в финансовых документах. Использование корректирующих кодов также основано на введении в передаваемый сигнал избыточных, проверочных символов.
Из экономических соображений всегда хотелось бы сформировать передаваемый сигнал, не содержащий избыточности, однако ставить это главной целью при кодировании допустимо лишь при передаче сигнала в канале без помех. В канале с помехами передаваемый сигнал должен содержать избыточность тем большую, чем выше уровень помех. Именно благодаря этой избыточности удается обеспечить требуемое качество передачи за счет того, что в процессе приема появляется возможность обнаруживать и исправлять большинство ошибок, возникающих в канале.
4.2 Кодирование в канале без помех
Сообщение на выходе любого реального источника информации (текст, речь, изображение и т.п.) обладает избыточностью. Нельзя сказать, что она бесполезна (см. вышеприведенные заметки о роли избыточности), но в подавляющем большинстве случаев введена далеко не самым рациональным образом. Поэтому перед тем, как проводить какие-то преобразования сообщения, лучше от этой избыточности избавиться.
Преобразование цифрового сигнала, направленное на сокращение из-

99
быточности, называется кодированием источника. Раньше тот же процесс называли кодированием в дискретном канале без помех.
Например, при двоичном кодировании алфавита, содержащего s = 5 букв, кодовая таблица может иметь следующий вид (табл. 4.1). Для каждой буквы xj в таблице указана вероятность ее появления p(xj) и соответствующая кодовая комбинация, а также длина lj этой комбинации (в общем случае комбинации могут содержать разное количество символов).
Обычно кодовая таблица используется многократно (для передачи многобуквенного текста), и наиболее объективным показателем экономичности кода является средняя длина кодовой комбинации
s |
|
|
|
L l j |
p(x j |
) 3 0, 2 ... 6 0,1 3, 2 бит / букву. |
(4.14) |
j 1 |
|
|
|
|
|
|
При этом избыточность сигнала на выходе кодера можно определить по формуле (4.13), полагая, что Lmin есть минимально возможное среднее количество m-ичных символов, приходящихся на одну букву текста.
Попытаемся найти ответы на два вопроса:
1)каково численное значение теоретического предела Lmin?
2)как нужно кодировать, чтобы достигнуть этого предела или хотя бы
кнему приблизиться?
Кстати, очевидно, что для алфавита табл. 4.1 существуют лучшие коды, нежели код, указанный в примере.
Таблица 4.1. Пример кодовой таблицы
xj |
p(xj) |
Кодовые |
lj |
|
|
слова |
|
a |
0,2 |
101 |
3 |
б |
0,5 |
010 |
3 |
в |
0,1 |
0 |
1 |
г |
0,1 |
1001 |
4 |
д |
0,1 |
110000 |
6 |
Проведем простые, хотя и не очень строгие, рассуждения, позволяющие ответить на первый вопрос.
Собственная информация буквы xj равна I(xj)=–logp(xj). Столько же информации должно содержать j-e кодовое слово.
С другой стороны, максимальное среднее количество информации, которое может перенести один m-ичный символ на выходе кодера, в соответствии с (4.7) равно Hmax=logm. Тогда количество таких символов, требуемое для размещения имеющейся информации, должно удовлетворять очевидному неравенству
100
l |
|
|
I (x j ) |
|
log p(x j ) |
. |
|
j |
|
|
(4.15) |
||||
|
|
Hmax |
|
log m |
|||
|
|
|
|
||||
Неравенство справедливо и для математических ожиданий обеих частей
s |
|
1 |
|
|
s |
|
|
|
|
|
|
|
|
|
|
|
|
|
|||
l j p(x j ) |
|
|
p(x j |
) log p(x j |
) . |
(4.16) |
||||
|
|
|||||||||
j 1 |
|
log m |
j 1 |
|
|
|
||||
|
|
|
|
|||||||
Тогда на основании определений (4.6) и (4.14) имеем |
|
|||||||||
|
L |
H ( X ) |
L . |
|
|
|||||
|
|
|
|
|||||||
|
|
|
log m |
min |
|
|
(4.17) |
|||
|
|
|
|
|
|
|||||
Таким образом, ответ на первый вопрос получен.
Выясним, при каких условиях неравенство (4.17) может обратиться в равенство, т.е. когда существует безызбыточный код. Для этого необходимо, чтобы каждое слагаемое в (4.16) обратилось в равенство, т.е. обратились в равенства все s выражений (4.15). Левая часть lj – это количество символов в j-й комбинации, т.е. положительное целое число. Поэтому равенство в (4.15) возможно лишь в том случае, когда и правая часть – положительное целое число. В итоге равенство в (4.17) возможно лишь в случае, когда распределение вероятностей букв таково, что каждая из вероятностей может быть представлена в виде отрицательной целочисленной степени основания кода m
p(xj ) m l j . |
(4.18) |
Приведенные соотношения отображают содержание доказанной строго
теоремы Шеннона о кодировании в дискретном канале без помех.
При кодировании алфавита Х с энтропией H(X) средняя длина кодовой комбинации не может быть меньше H(X)/logm. Если вероятности букв не являются отрицательными целочисленными степенями числа m, то точное достижение указанной нижней грани невозможно, но при кодировании достаточно длинными блоками к ней можно сколь угодно приблизиться.
Последнее утверждение теоремы, о кодировании блоками, будет проиллюстрировано позже.
Формула (4.15) дает лишь весьма общее указание о способе кодирования: более вероятным буквам должны соответствовать более короткие кодо-
вые комбинации. Это – принцип статистического кодирования.
Предложено несколько способов кодирования с малой избыточностью. Наилучший из них – код Хафмана. Величина L, получаемая при кодировании этим кодом, не больше, чем при кодировании любым другим кодом.
Процедура кодирования двоичным (m = 2) кодом Хафмана предусматривает (s – 1)-кратное повторение одной и той же операции, включающей следующие действия:
1)буквы алфавита, полученного на предыдущем шаге, располагаются в порядке убывания их вероятностей;
2)проводится сокращение алфавита на одну единицу, т.е. две наименее вероятные буквы объединяются и заменяются одной новой буквой, для кото-