Материал: DO178 Учебное пособие_в183
Цикломатическая сложность была введена Мак-Кейбом (Thomas J. McCabe) [18]; она является мерой топологической сложности схемы программы, рассматриваемой как граф передач управления в ней (control flow graph). Цикломатическое число λ(G) для графа G с n вершинами, m дугами и p компонентами связности вычисляется по формуле λ(G) = m – n + 2×p.
Число компонентов связности графа можно рассматривать как минимальное количество дуг, которые необходимо добавить для преобразования графа в сильно связный (сильно связным называется граф, любые две вершины которого взаимно достижимы). Для графов корректных программ; т.е., графов, не имеющих недостижимых от точки входа участков и "висячих" точек входа и выхода, сильно связный граф, как правило, получается путем замыкания дугой вершины, обозначающей конец программы, на вершину, обозначающую точку входа в эту программу. Таким образом, для односвязного графа управления с n вершинами и m дугами его цикломатическая сложность определяется как λ(G) = m – n + 2.
По сути λ(G) определяет число линейно независимых контуров в сильно связном графе. Иначе говоря, цикломатическое число Мак-Кейба показывает требуемое количество проходов для покрытия всех контуров сильно связного графа или количество тестовых прогонов программы, необходимых для исчерпывающего тестирования по критерию "работает каждая ветвь". Цикломатическое число зависит только от количества предикатов в программе (т.е, условий ветвления), для которых не учитывается их сложность и уровень вложенности операторов, в котором они находятся. На практике это означает, что цикломатическая сложность равна числу разветвлений в программе (суммарному числу операторов IF, CASE и LOOP) плюс единица, что позволяет вычислять ее без построения управляющего графа простым подсчетом числа этих операторов (для оператора CASE берется число ветвей в нем без единицы).
К недостаткам этой метрики можно отнести ее нечувствительность к размеру программы, отсутствие корреляции со структурированностью программы, нечувствительность к вложенности циклов. Отмеченные недостатки цикломатической меры привели к появлению ряда ее модификаций, а также принципиально иных мер топологической сложности. Например, Майерс (Glenford J. Myers) предложил интервальную меру – интервал [λ1, λ2], где λ1 – цикломатическая мера по Мак-Кейбу, а λ2 – число отдельных условий (предикатов) плюс единица. При этом оператор DO считается за одно условие, а CASE c N исходами за N–1 условий.
В то же время метрика цикломатической сложности удобна для ранжирования программных решений и для быстрого отнесения их к одному из указанных выше трех классов сложности: малая, средняя и большая.
Все перечисленные метрики не связаны со сложностью алгоритма, реализуемого в программе, для которого есть точное математическое определение. В последнее время они редко используются в промышленной разработке программных продуктов; при оценке сложности программы разработчики предпочитают ориентироваться только на ее размер в KLOC или KAELOC.
Характеристики программного проекта
Программный проект – это ряд деятельностей по разработке программного продукта, характерной особенностью которого является наличие следующих атрибутов (характеристик):
Цель – для чего (с какой целью) разрабатывается данный программный продукт и заказчик тратит на эту разработку средства и время;
Важность для заказчика – в чем важность достижения указанной цели, почему ее достижение столь важно, что запускается данный программный проект;
Уникальность – почему необходима новая разработка, а нельзя использовать какой-либо уже известный программный продукт для достижения тех же целей;
|
|
|
|
Атрибуты: цель, важность, уникальность |
Ограничения: качество, время, ресурсы |
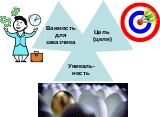
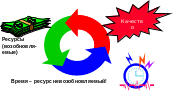
Рис. 1. Атрибуты и ограничения программного проекта
и следующих ограничений:
Качество, которое должен иметь конечный продукт;
Время – проект должен закончиться к заданному сроку;
Ресурсы – исполнение проекта должно уложиться в заданный бюджет.
Четко заданная цель проекта позволяет сформулировать критерии его завершения; т.е., определить момент, когда цель достигнута, и проект может быть завершен. Обычно цель программного проекта – это создание программного продукта, с помощью которого улучшается некоторая важная для заказчика характеристика его производственного процесса (как правило, за счет его автоматизации или иного усовершенствования). Примеры:
За счет системы АПТФ (автоматического поиска тематических фактов) снизить на 90% трудоемкость поиска информации в сети Интернет и повысить релевантность поиска минимум на 50%, по сравнению с поиском, проводимым вручную. |
Важность для заказчика – это объяснение того, почему улучшение данной характеристики так важно для заказчика, что он желает потратить средства и время на данный проект, к тому же с риском не достичь заявленной цели. Примеры:
Продукт позволяет целенаправленно клонировать задание экспериментов, накапли-вать данные и результаты экспериментов и проводить последующее автоматизиро-ванное «раскапывание данных» для вскрытия неочевидных зависимостей в данных, обеспечивая тем самым конкурентное преимущество пользователю продукта. |
Сокращение времени обработки каждого запроса в данной системе на 50%, по сравнению, с применяемым в настоящее время решением, позволит заказчику обеспечить массовое обслуживание своих клиентов в данном секторе рынка. |
Уникальность – это инновационное отличие будущего программного продукта от его ближайших аналогов, в той или иной степени достигающих ту же цель. Если элемента новизны (инновационности) в данном продукте нет, или разработчики не могут его четко сформулировать, то встает вопрос, а нужно ли вообще разрабатывать данных продукт, поскольку всякая новая разработка связана с затратами средств и времени и риском, тем не менее, не получить того, что нужно. Примеры:
Впервые термостат и ультразвук сочетаются в одном медицинском приборе, что повышает его функциональность. |
Применение трехмерной графики и звукового сопровождения для отображения тактической информации на оперативной карте. |
Предполагаемые к реализации элементы новизны должны быть предварительно проанализированы на возможность и необходимость их патентования или иных способов защиты этих объектов интеллектуальной собственности, прежде их реализации и включения в поставляемый продукт. Любая публикация объекта интеллектуальной собственности, к которой относится, в частности, и включение его в продукт, выпускаемый на рынок, делает невозможным его последующее патентование.
Качество программного продукта
Понятие качества программного продукта (software product quality) тесно связано с понятиями дефекта (defect) и ошибки (error, bug).
Дефект программного продукта (defect) – это любое наблюдаемое несоответствие его фактического поведения в допустимых условиях эксплуатации, ожидаемому поведению, как оно определено в спецификации требований.
Ошибка (error) – это причина наблюдаемого дефекта, как правило, присутствующая в коде, но коренящаяся либо в коде, либо в проекте, либо в спецификации требований, либо в аппаратуре.
В англоязычной литературе под ошибкой часто понимается «любая проблема, обнаруженная на той же фазе ЖЦ, где она возникла», а под дефектом – «проблема, обнаруженная на какой-либо из последующих фаз ЖЦ после ее возникновения». Термин fault, используемый наряду с error и defect, означает одновременно и ошибку, и дефект в указанном выше смысле; т.е., любую проблему в программном продукте, независимо от фазы ЖЦ, на которой она была обнаружена.
Таким образом, дефект лишь обнаруживает наличие ошибки в реализации продукта; причем бывает, что один дефект является следствием нескольких различных ошибок и, наоборот, одна и та же ошибка является причиной нескольких разных дефектов. Чем дальше по линии ЖЦ разработки отстоит место обнаружения дефекта в программном продукте от места совершения ошибки, его вызвавшей, тем более высока для исполнителя стоимость выявления места этой ошибки, ее исправления и проверки того, что исправление действительно устранило обнаруженный дефект и не привнесло в продукт новых дефектов. Эти затраты образуют так называемую стоимость плохого программирования (Cost Of Poor Quality – COPQ), снижение которой является важным резервом исполнителя в повышении эффективности своей работы. Эти затраты никак не оплачиваются заказчиком, а лишь повышают себестоимость разработки, снижая тем самым остающуюся у разработчиков прибыль от разработки.
С выявлением дефектов связано понятие «дублирования», когда разные в своем наблюдаемом проявлении дефекты являются по существу одним и тем же дефектом; т.е., сводятся к общей проблеме и, соответственно, к общей ошибке или группе ошибок в коде как своей причине. Устранение этой причины устраняет все эти дефекты.
На основании обследования огромного числа (свыше 3000) реальных программных проектов еще в начале 1980-х годов Боэм (Barry Boehm) установил экспоненциальный рост этих затрат (кривая Боэма – Рис. 2), который с тех пор только постоянно подтверждался дальнейшими исследованиями. Практический вывод из этого наблюдения – стараться не позволять совершаемым в процессе разработки ошибкам «перерастать» в дефекты, а находить их и устранять как можно раньше, сразу же по мере их возникновения, используя различные методы и практики предотвращения дефектов (defect prevention).
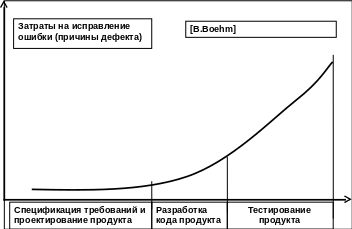
Рис. 2. Кривая Боэма – рост затрат на поиск и устранение причин дефектов
Качество программного продукта – это оценка числа оставшихся в нем дефектов, которые могут проявиться при его эксплуатации. Эти оставшиеся дефекты могут быть как известные разработчикам (с поправкой на дублирование), но по разным причинам еще не исправленные, так и еще не выявленные. Для оценки числа оставшихся в коде дефектов, принимаются следующие предположения:
а) каждая ошибка является причиной ровно одного дефекта, а каждый дефект является следствием только одной ошибки; т.е. суммарное число дефектов в продукте (уже известных и еще не выявленных) равно числу ошибок в его коде (это не всегда так, но позволяет упростить ход рассуждений);
б) плотность ошибок (среднее число совершаемых разработчиком ошибок на 1000 строк кода) в создаваемом документе (например, в тексте программы) постоянна и не зависит от его размера (для программ это число «содержательных» строк кода без комментариев и пустых строк);
в) ошибки не зависят друг от друга.
Тогда, если обозначить плотность ошибок через R, а размер кода – через S, то оценка числа ошибок M в этом коде очевидна: M=R×S. Именно столько ошибок (причин дефектов) и следует искать (и устранять!) в данном коде, чтобы рассчитывать на бездефектный (defect-free) продукт.
В процессе разработки продукта ошибки в коде постепенно обнаруживаются и, как правило, устраняются. Если фиксировать (заносить в БД проекта) все наблюдаемые дефекты и находимые по ним ошибки, устраняя дублирование и «ложные тревоги» (обозначив их общее число через N), то текущее качество программного продукта Q определяется как (M-N)/S в предположении, что M≥N. Если это значение устраивает заказчика, то процесс разработки можно заканчивать, в противном случае надо продолжать искать дефекты, выявляя и устраняя их причины – ошибки. Если же в какой-то момент оказалось, что M<N, то это говорит о неточности в определении M, которая, скорее всего, проистекает из-за заниженной оценки для плотности совершения ошибок R. В этом случае надо понять причины такой неточности и устранить ее.
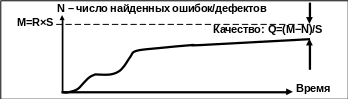
Рис. 3. Измерение качества программного продукта
Этот процесс нахождения и устранения ошибок отображается S-кривой на графике, показывающим зависимость числа найденных (и исправленных!) ошибок от времени (Рис. 3). На графике хорошо видны два характерных «скачка»; обычно первый связан с синтаксическими ошибками, выявляемыми транслятором, а второй – с логическими ошибками, обнаруживаемыми при прогоне тестов. При дальнейшем тестировании новые ошибки обнаруживаются все реже и реже, так что S-кривая становится практически пологой, что говорит о «насыщении» процесса поиска ошибок данными средствами. Если текущее качество продукта не устраивает заказчика, то надо создавать дополнительные тесты или применять какие-либо другие методы верификации и валидации программного обеспечения.
На практике качество поставляемого программного продукта принято оценивать по плотности поставленных дефектов, известных и неизвестных, в пересчете на размер программного кода в 1000 KAELOC.
Можно предположить, что дефекты, содержащиеся в программном коде, являются случайными независимыми событиями и вызывающие их ошибки могут встречаться в каждой строке. При таком условии число случайных событий-дефектов может быть более одного миллиона. Тогда можно предположить, что распределение вероятности присутствия ошибок на строках кода подчиняется нормальному закону.
График плотности вероятности такого распределения показан на Рис. 4. Считают, что качество программного продукта имеет уровень i сигма (сигма – это среднеквадратическое отклонение случайных событий – присутствия дефектов на строках кода), если количество строк кода, не содержащих дефектов, попадает в интервал ±i сигма относительно его математического ожидания m (Рис. 4). Оставшиеся за пределами этого интервала строки кода, содержащие дефекты, определяют плотность дефектов в поставляемом продукте.
В действительности распределение вероятности того, что строка кода, содержит ошибки, часто отклоняется от нормального. По этой причине и по некоторым другим аналогиям из промышленного производства сложных промышленных изделий, на практике для оценки качества программного продукта используются несколько увеличенные плотности дефектов, приведенные в Табл. 3.
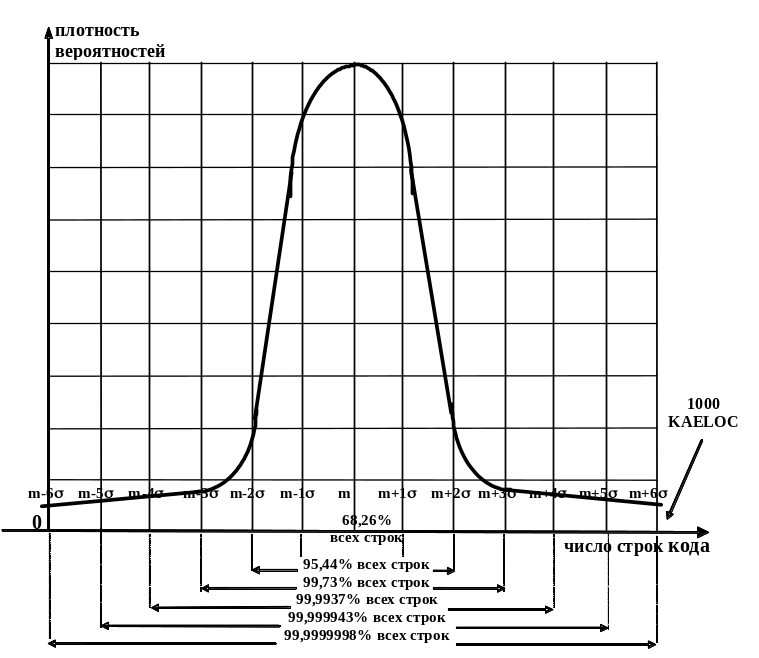
Рис. 4. Распределение вероятности присутствия дефектов на строках кода
Как видно из приведенных цифр, программный продукт с уровнем качества 6 сигма может содержать в своем программном коде лишь 3,4 дефекта на один миллион строк на языке ассемблера; т.е., только 3,4 строки из 1 миллиона являются дефектными – содержат ошибку. Этот уровень качества является очень высоким, но реально достижимым при наличии очень высокой дисциплины труда и с соблюдением всех директив стандартного процесса.