Материал: Эконометрика. методические указания для студентов, обучающихся по направлению подготовки 38.03.02 «Менеджмент». Баркалов С.А., Курочка П.Н
стические данные на координатную плоскость. Причем необходимо очень тщательно выбрать масштаб представления имеющихся данных, так как неудачно выбранный масштаб может скрыть изучаемую тенденцию: на графике просто не увидишь имеющуюся тенденцию. Поэтому график должен быть наиболее крупным. Но даже это обстоятельство далеко не всего позволяет разглядеть имеющуюся тенденцию. В этом случае приходится прибегать к специальным способам выравнивания временных рядов
В курсе «Статистка 1 часть» изучалось четыре приема выравнивания: а) увеличение интервалов; б) вычисление средних уровней для увеличенных интервалах;
в) определение скользящей (подвижной) средней; г) аналитическое выравнивание.
Первые три изучались подробно, а последний, аналитическое выравнивание, относился к курсу «Эконометрики». Необходимо повторить особенности первых трех приемов выравнивания временны рядов (рядов динамики).
Следует иметь в виду, что приемы увеличение интервалов; вычисление средних уровней для увеличенных интервалах и определение скользящей (подвижной) средней, позволяют описать только качественно выявленную тенденции. Никаких количественных параметров в данном случае получить нельзя. Поэтому данные методы выравнивания дополняются методом аналитического выравнивания временного ряда, который позволяет получить аналитическое выражение, описывающее изучаемое явление.
Метод аналитического выравнивания по сути дела является парной корреляционной моделью, в которой в качестве факторного признака принимается время. В этом случае имеется возможность использовать алгоритм построения парной корреляционной модели.
Единственной особенностью в данном случае является способ задания времени. Принято, что нецелесообразно задаваться абсолютными значениями времени: датами или числом дней, часов или секунд, прошедших с момента события принятого за точку отсчета, гораздо разумнее обозначать временные интервалы или моменты времени, числами натурального ряда. В этом случае временной параметр ti будет во всех моделях принимать одни и те же значе-
ния: ti=1, 2, 3,….,Т.
Кроме того, следует обратить внимание на тот факт, что при изучении данных, упорядоченных во времени, наиболее часто встречается автокорреляция случайных отклонений (возмущений), поэтому исследования на выявлении этого явления все-таки являются обязательными,
Так же, как и при построении обычной корреляционной модели, следует проводит исследование на адекватность построенной модели с использованием t-критерия Стьюдента и F-критерия Фишера
Последующее изучение временного ряда осуществляется путем выяснения вопроса о наличии в ряду сезонной составляющей и ее измерении. Сделать это можно следующими способами:
16
а) метод абсолютных разностей; б) метод относительных разностей;
в) построение индексов сезонности; г) построение аналитической модели.
Так же, как и при выявлении тренда, первые три метода позволяют только установить наличие сезонных колебаний, но полное исследование модели в этом случае невозможно. Как правило, эти методы достаточно просты и их использование обычно затруднений не вызывает. А вот метод построения аналитической модели позволяет провести полное исследование модели сезонных колебаний, но он и достаточно сложен, хотя и представляет собой построение обычной парной корреляционной модели, в которой за факторный признак принимается время. Второй особенностью в этом случае является тот факт, что вид уравнения регрессии в этом случае практически задан: зависимость изучаемой переменной от времени задается рядом Фурье. В этом случае уравнение регрессии будет иметь следующий вид
Yt = a0 + ∑k (ak coskt + bk sin kt)
i =1
где a0, ak, bk – параметры, которые подлежат определению; k – количество членов ряда Фурье. В литературе имеются формулы, согласно которым рассчитываются эти коэффициенты.
В данном случае основная сложность заключается в том, что ряд Фурье является бесконечным рядом, что для практического использования является препятствием. Возникает задач ограничить число членов ряда разумными пределами. Практика показывает, что обычно хватает 2 – 4 членов ряда. Для определения количества удерживаемых членов ряда Фурье задачу приходится решать несколько раз.
Первая итерация заключается в том, что в ряде Фурье удерживается только один член. Производят расчет и определяют суммарную ошибку аппроксимации в данном случае. Если эта ошибка будет незначительно, то на этом процесс вычисления останавливается. Если же ошибка будет значительной, то переходят к следующей итерации.
Вторая итерация. В ряде Фурье удерживается уже два члена ряда. Строят модель для этой аппроксимации и определяют ошибку. Сравниваю эту ошибку с ошибкой, полученной на предыдущей итерации. В том случае если точность решения повысилась незначительно, то есть смысл прекратить процесс вычисления. Если же полученная точность решения не устраивает, то переходят к следующей итерации, на которой уже рассматривают ряд Фурье, содержащий три члена.
Подобная процедура продолжается до тех пор, пока не будет достигнута точность необходимая для решаемой задачи.
Полученная модель позволяет выполнять прогнозирование социальноэкономических явлений во времени. И здесь очень важно иметь представле-
ние об интерполяции и экстраполяции.
17
Интерполяция – это нахождение отсутствующих промежуточных уровней временного ряда. Зная уравнение тренда для вычисления теоретических уровней и подставляя в него промежуточные значения t между заданными, можно определить отвечающий им теоретический уровень результативного фактора.
Экстраполяция используется при прогнозировании социальноэкономических явлений в будущем с предположением, что выявленная тен-
денция будет сохраняться и в дальнейшем за пределами исследуемого вре-
менного ряда. При этом значения t вне пределов динамического ряда подставляют в трендовое уравнение и получают точечное прогнозное значение уровня тренда Yпр будущем.
Практическая ценность точечного прогноза невелика. В целях повышения практической ценности полученных результатов необходимо на базе точечного прогноза определить доверительный интервал полученного прогностического значения, то есть определить интервал значений, в который прогнозируемая величина будет попадать с заданной вероятностью. Это выполняется по следующей формуле
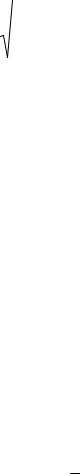
Yt - tg σε ≤ Yпр ≤ Yt + tg σε
где tg – коэффициент доверия t-распределения Стьюдента, для вероятности
95% равен 1,96; σg = |
∑(y -Yt )2 |
|
(n - m) |
– остаточное среднее квадратическое от- |
|
клонение; n – количество уровней рассматриваемого временного ряда; m – количество параметров теоретической зависимости тренда; (n – m) — число степеней свободы; Yt – дискретное (точечное) значение прогнозного уровня.
Следует отметить одно важное обстоятельство: использование формулы для определения доверительного прогноза будет справедливо только в том случае, если исходная совокупность данных распределена по нормальному закону распределения. В большинстве случаев это все-таки соблюдается, но возможны отклонения, которые обесценивают приведенные здесь результаты.
Важным вопросом при моделировании временных рядов является вопрос о глубине прогнозирования, то есть на сколько периодов времени вперед возможен прогноз. В данном случае в этом вопросе так же имеется фундаментальное соотношение.
Если обозначить: T = t + τ – общий временной горизонт, где t – период наблюдений (предпрогнозный интервал), τ – период прогноза (интервала упреждения) собственно глубина прогнозирования. Тогда математическая статистика рекомендует, чтобы глубина прогнозирования определялась исходя из следующего соотношения
τt ≥ 3 t ≥ 3τ.
Таким образом:
18
–если желаемый период прогноза τ=1 год, то величина периода наблюдений должна составить t ≥ 3 года, соответственно T ≥ 4 – общий временной горизонт;
–если желаемый период прогноза τ=2 года, то величина периода на-
блюдений должна составить t ≥ 6 лет, соответственно T ≥ 8 – общий временной горизонт;
– если желаемый период прогноза τ=3 года, то величина периода наблюдений должна составить t ≥ 9 лет, соответственно T ≥ 12 – общий временной горизонт, и т.д.
Вопросы для самоконтроля
1.Из каких компонентов состоит набор статистических данных по которому строится эконометрическая модель?
2.Аналитическое выравнивание временного ряда.
3.Линейный и нелинейные тренды.
4.Расчет параметров тренда.
5.Моделирование сезонных колебаний.
6.Аддитивная и мультипликативная модели временного ряда.
7.Выравнивание ряда методом скользящей средней.
8.Расчет сезонной компоненты. Выделение тренда.
9.Методы определения сезонности.
10.Какие методы изучения и измерения сезонных колебаний Вы знаете?
Тема №9 «Адаптивные модели прогнозирования»
Тема рассматривается как факультативная, то есть необязательная. Выявление и анализ тенденции временного ряда часто производится с
помощью его выравнивания или сглаживания. Экспоненциальное сглаживание – один из простейших и распространенных приемов выравнивания ряда, с помощью которого осуществляется краткосрочное прогнозирование временных рядов.
Экспоненциальное сглаживание ряда осуществляется по рекуррентной формуле:
St=αxt+(1 – α)St-1
где xt – уровень временного ряда; St – экспоненциальная средняя, вычисленная для момента времени t; α – постоянная сглаживания.
Естественно, при использовании этой формулы возникает вопрос о том, как выбрать начальное приближение S0, которое появляется в формуле при t=1. Если к моменту начала вычислений нам известны более ранние данные, то в качестве начального значения S0 можно использовать арифметическую среднюю всех имеющихся данных или какой-то их части. Но такая ситуация достаточно редка, поэтому вопрос остается открытым: что же принимать за значение S0?
19
Достаточно часто в качестве начального значения S0 принимается средняя арифметическая первых нескольких членов ряда, например, 5 – 7. Таким образом, в данном случае уверенности в правильности выбора этого значения нет. Обычно в таких случаях используют более высокое значение постоянной сглаживания α, что обеспечивает быстрое уменьшение влияния этого начального значения на результаты прогнозирования.
Постоянная сглаживания α, определяет, что же будет в большей степени влиять на прогноз: последние данные или отдаленные. Если α = 1, то пр е- дыдущие наблюдения полностью игнорируются, а е сли α = 0, то игнорир у- ются текущие наблюдения. Значениям α между 0, 1 будут соответствовать промежуточные результаты.
Эмпирические исследования показали, что весьма часто простое экспоненциальное сглаживание дает достаточно точный прогноз.
На практике обычно рекомендуется брать α меньше 0,3. Однако α больше 0,3 часто дает лучший прогноз.
Из всего этого можно сделать вывод: лучше оценивать оптимально α по данным, чем просто гадать или использовать искусственные рекомендации.
Эмпирический анализ модели простого экспоненциального сглаживания позволяет сделать вывод о том, что с ее помощью нельзя осуществлять прогноз для данных, имеющих ярко выраженную тенденцию, то есть тренд.
Модель Хольта предполагает модификацию алгоритма для случая линейного тренда.
В этом случае эффект достигается за счет введения еще одного параметра сглаживания где α1, α2 – параметры экспоненциального сглаживания
(α1> 0; α2 <1).
Недостатком модели Хольта является невозможность учета сезонности. Модель Хольта-Уинтерса является развитием модели Хольта, в ней появляется сезонная составляющая, в результате чего получается система урав-
нений с тремя постоянными сглаживания
Вопросы для самоконтроля
1.В чем сущность экспоненциального сглаживания?
2.Когда применяется метод экспоненциального сглаживания
3.В чем недостаток метода экспоненциального сглаживания?
4.Как выбирается постоянная сглаживания α?
5.Как выбирается начальное приближение S0?
6.Для чего используется модель Хольта?
7.В чем недостаток модели Хольта?
20