Контрольная работа: Функции принадлежности. Нечеткие деревья решений
Графическая иллюстрация дерева решений
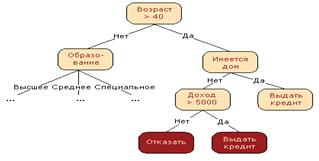
Область применения деревья решений в настоящее время широка, но все задачи, решаемые этим аппаратом могут быть объединены в следующие три класса:
Описание данных: Деревья решений позволяют хранить информацию о данных в компактной форме, вместо них мы можем хранить дерево решений, которое содержит точное описание объектов.
Классификация: Деревья решений отлично справляются с задачами классификации, т.е. отнесения объектов к одному из заранее известных классов.
Целевая переменная должна иметь дискретные значения.
Регрессия: Если целевая переменная имеет непрерывные значения, деревья решений позволяют установить зависимость целевой переменной от независимых(входных) переменных. Например, к этому классу относятся задачи численного прогнозирования(предсказания значений целевой переменной).
. Алгоритм построения нечеткого дерева решений
Главной идеей в таком подходе является сочетание возможностей деревьев решений и нечеткой логики,. Отличительной чертой деревьев решений является то, что каждый пример определенно принадлежит конкретному узлу. В нечетком случае это не так. Для каждого атрибута необходимо выделить несколько его лингвистических значений и определить степени принадлежности примеров к ним. Вместо количества примеров конкретного узла нечеткое дерево решений группирует их степень принадлежности. Коэффициент - это соотношение примеров узла N для целевого значения i, вычисляемый как:, где μN(Dj) - степень принадлежности примера Dj к узлу N, μi(Dj) - степень принадлежности примера относительно целевого значения i, S N - множество всех примеров узла N. Затем находим коэффициент, обозначающий общие характеристики примеров узла N. В стандартном алгоритме дерева решений определяется отношение числа примеров, принадлежащих конкретному атрибуту, к общему числу примеров. Для нечетких деревьев используется отношение, для расчета которого учитывается степень принадлежности.
Выражение даѐт оценку среднего количества информации для определения класса объекта из множества P N. На следующем шаге построения нечеткого дерева решений алгоритм вычисляет энтропию для разбиения по атрибуту A со значениями aj: , где узел N|j - дочерний для узла N. Алгоритм выбирает атрибут с максимальным приростом информации.
Узел N разбивается на несколько подузлов N|j. Степень принадлежности примера Dk узла N|j вычисляется пошагово из узла N как, где μi(Dk,aj) показывает степень принадлежности Dk к атрибуту aj. Подузел N|j удаляется, если все примеры в нем имеют степень принадлежности, равную нулю. Алгоритм повторяется до тех пор, пока все примеры узла не будут классифицированы либо пока не будут использованы для разбиения все атрибуты.
Принадлежность к целевому классу для новой записи находится по формуле, где - коэффициент соотношения примеров листа дерева l для значения целевого класса k, μl(Dj) - степень принадлежности примера к узлу l, χk - принадлежность значения целевого класса k к положительному значению исхода классификации.
. Пример: построение дерева решений о выдаче кредита
В таблице 1 представлены данные о семи клиентах
банка: проживание в регионе (в годах), доход (в денежных единицах) и рейтинг
выдачи ему кредита. Необходимо построить нечеткое дерево решений, с помощью
которого определить рейтинг выдачи кредита для клиента, который проживает в
регионе 25 лет, и доход его составляет 32 000 (будет решаться задача регрессии).
Таблица - Обучающие примеры для построения нечеткого дерева решений
|
№ |
Проживание в регионе |
Доход |
Рейтинг |
|
D1 |
0 |
10 000 |
0.0 |
|
D2 |
10 |
15 000 |
0.0 |
|
D3 |
15 |
20 000 |
0.1 |
|
D4 |
20 |
30 000 |
0.3 |
|
D5 |
30 |
25 000 |
0.7 |
|
D6 |
40 |
35 000 |
0.9 |
|
D7 |
40 |
50 000 |
1.0 |
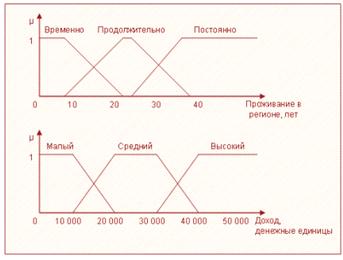
Предположим, что атрибут "проживание в
регионе" может принимать значения "временно",
"продолжительно", "постоянно", а атрибут "доход"
- "малый", "средний" и "высокий". Степень
принадлежности каждого примера к значениям атрибутов представлена в таблице
ниже. Общий вид функции для атрибутов показан на графики функций принадлежности
Степень принадлежности примеров к атрибутам
|
№ |
Проживание в регионе |
Доход |
||||
|
|
Временно |
Продолжительно |
Постоянно |
Малый |
Средний |
Высокий |
|
D1 |
1 |
0 |
1 |
0 |
0 |
|
|
D2 |
0,8 |
0,2 |
0 |
0,6 |
0,4 |
0 |
|
D3 |
0,5 |
0,5 |
0 |
0,1 |
0,9 |
0 |
|
D4 |
0,2 |
0,8 |
0 |
0 |
1 |
0 |
|
D5 |
0 |
0,5 |
0,5 |
0 |
1 |
0 |
|
D6 |
0 |
0 |
1 |
0 |
0,6 |
0,4 |
|
D7 |
0 |
0 |
1 |
0 |
0 |
1 |
В начале необходимо найти значение - общая энтропия.да = 0 + 0 + 0,1 + 0,3 + 0,7 + 0,9 + 1,0 = 3, Pнет = 1 + 1 + 0,9 + 0,7 + 0,3 + 0,1 + 0 = 4,
= Pда + Pнет = 3 + 4 = 7, бит.
Теперь рассчитаем E(SN, проживание в регионе). P
да временно = min(0;1) + min(0;0,8) + min(0,1;0,5) + min (0,3;0,2) + min(0,7;0)
+ min(0,9;0) + min(1;0) = 0 + 0 + 0,1 + 0,2 + 0 + 0 + 0 = 0,3P нет временно =
min(1;1) + min(1;0,8) + min(0,9;0,5) + min (0,7;0,2) + min(0,3;0) +min(0,1;0) +
min(0;0) = 1 + 0,8 + 0,5 + 0,2 + 0 + 0 + 0 = 2,5 P временно = 0,3 + 2,5 = 2,8
E(проживание в регионе, временно)= бит. Для продолжительного и постоянного
проживания в регионе проводятся аналогичные вычисления. Результат сведем в итог
расчетов для атрибута "проживание в регионе"
|
|
Временно |
Продолжительно |
Постоянно |
|
Рда |
0,3 |
0,9 |
2,4 |
|
Рнет |
2,5 |
1,7 |
0,4 |
|
Е в битах |
0,491 |
0,931 |
0,592 |
Отсюда находим энтропию: E(SN, проживание в
регионе) = 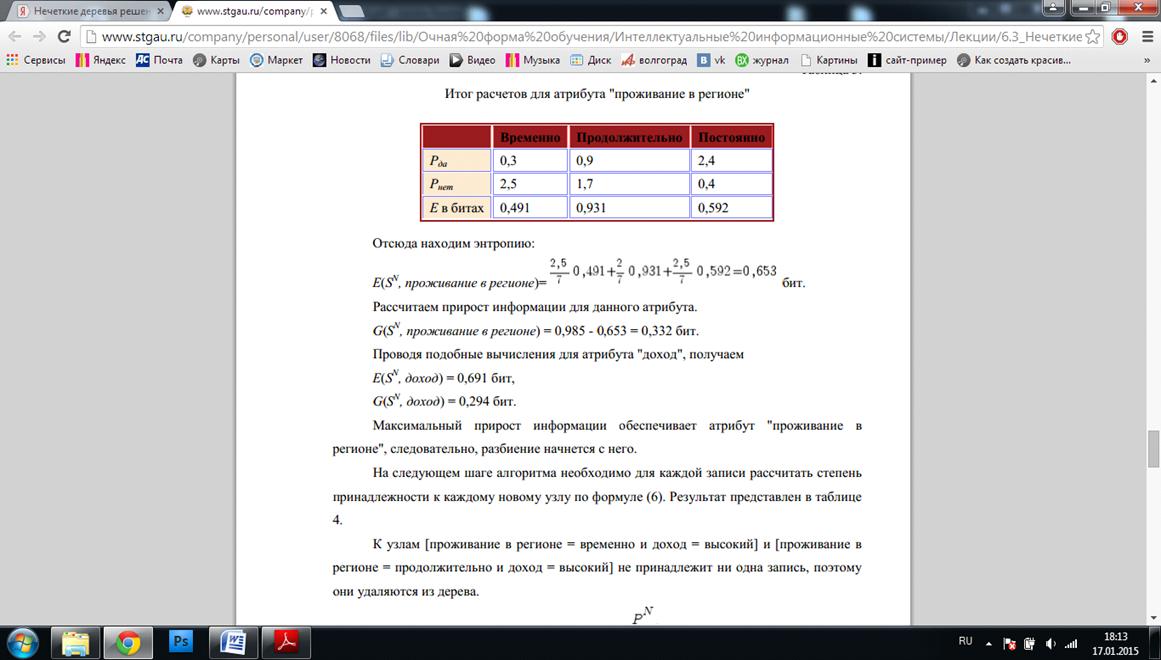 бит. Рассчитаем
прирост информации для данного атрибута. G(SN, проживание в регионе) = 0,985 -
0,653 = 0,332 бит. Проводя подобные вычисления для атрибута "доход",
получаем E(SN, доход) = 0,691 бит, G(SN, доход) = 0,294 бит. Максимальный
прирост информации обеспечивает атрибут "проживание в регионе",
следовательно, разбиение начнется с него. На следующем шаге алгоритма
необходимо для каждой записи рассчитать степень принадлежности к каждому новому
узлу по формуле. Пример в таблице ниже.
К узлам [проживание в регионе = временно и доход
= высокий] и [проживание врегионе = продолжительно и доход = высокий] не
принадлежит ни одна запись, поэтому они удаляются из дерева. Для каждого узла
находятся коэффициенты PNi. Полученное дерево представленона рисунке ниже после
таблицы.
Принадлежность записей новым узлам дерева
|
Проживание в регионе |
Временно |
продолжительно |
Постоянно |
Малый |
Средний |
Высокий |
Малый |
Средний |
Высокий |
Малый |
Средний |
Высокий |
||||||
|
D1 |
1 |
0 |
0 |
0 |
0 |
0 |
0 |
0 |
0 |
|||||||||
|
D2 |
0.6 |
0.4 |
0 |
0.2 |
0.2 |
0 |
0 |
0 |
0 |
|||||||||
|
D3 |
0.1 |
0.5 |
0 |
0.1 |
0.5 |
0 |
0 |
0 |
0 |
|||||||||
|
D4 |
0 |
0.2 |
0 |
0 |
0.8 |
0 |
0 |
0 |
0 |
|||||||||
|
D5 |
0 |
0 |
0 |
0 |
0.5 |
0 |
0 |
0.5 |
0 |
|||||||||
|
D6 |
0 |
0 |
0 |
0 |
0 |
0 |
0 |
0.6 |
0.4 |
|||||||||
|
D7 |
0 |
0 |
0 |
0 |
0 |
0 |
0 |
1 |
||||||||||
Графическая иллюстрация полученного нечеткого дерева решений
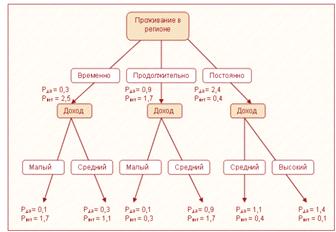
Теперь определим кредитный рейтинг для клиента,
проживающего в регионе 25 лет, и с доходом 30 000.За положительный исход в
данной задаче принято одобрение в выдаче кредита, поэтому χ
да
= 1,0, χнет
= 0,0. Новый клиент принадлежит к двум узлам: [проживание в регионе =
продолжительно и доход = средний] и [проживание в регионе = постоянно и доход =
средний], со степенями 0,8 и 0,2 соответственно. Подставляя полученные значения
в формулу, рассчитываем кредитный рейтинг
. 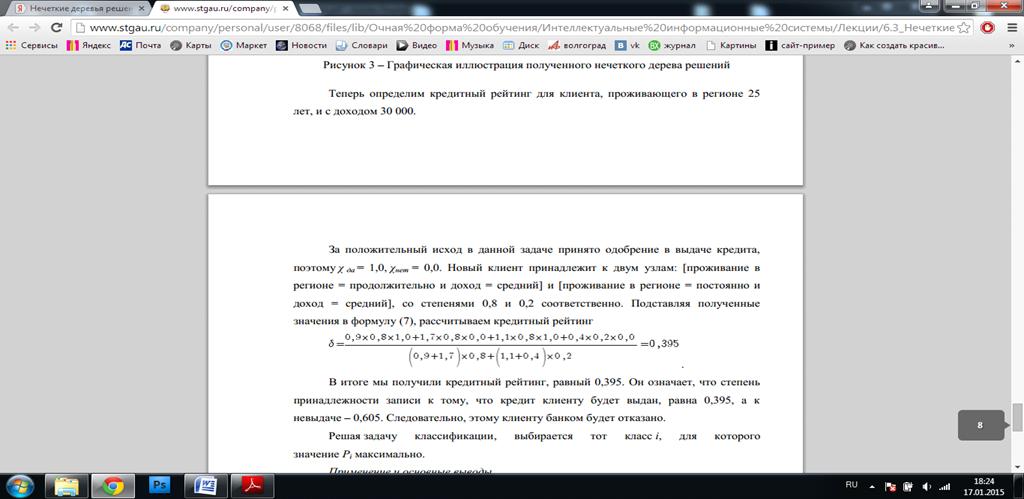
В итоге мы получили кредитный рейтинг, равный 0,395. Он означает, что степень принадлежности записи к тому, что кредит клиенту будет выдан, равна 0,395, а к невыдаче - 0,605. Следовательно, этому клиенту банком будет отказано.
Решая задачу классификации, выбирается тот класс i, для которого значение Pi максимально.
Применение и основные выводы.
Нечеткие деревья решений применяются в Data Mining как для решения задач классификации, так и для решения задачи регрессии, когда необходимо знать степени принадлежности к тому или иному исходу. Они могут быть использованы в различных областях: в банковском деле для решения задачи скоринга, в медицине для диагностики различных заболеваний, в промышленности для контроля качества продукции и так далее.
Безусловным достоинством данного подхода является высокая точность классификации, достигаемая за счет сочетания достоинств нечеткой логики и деревьев решений. Процесс обучения происходит быстро, а результат прост для интерпретации. Так как алгоритм способен выдавать для нового объекта не только класс, но и степень принадлежности к нему, это позволяет управлять порогом для классификации.
Однако для этого необходим репрезентативный
набор обучающих примеров, в противном случае сгенерированное алгоритмом дерево
решений будет слабо отражать действительность и, как следствие, выдавать
ошибочные результаты.
ЧАСТЬ 3
Описать cовременное практическое применение
механизмов анализа нечеткой информации
Различные типы интеллектуальных систем имеет свои особенности, например, по возможностям обучения, обобщения и выработки результатов, что делает их наиболее пригодными для решения одних классов задач и менее пригодными - для других.
Различные нейропакеты помогают успешно решать такие задачи, как оценка рейтинга ценных бумаг (нейропакет S&PCBRS); контроль валютных операций в двадцати трех странах мира (Inspector); анализ займов, кредитное планирование и прогноз экономической активности (Nexpert Object); формирование портфеля ценных бумаг (Open Interface); оценка кредитных займов, прогноз курсов валют, анализ биржевой и рыночной активности, прогноз экономических и биржевых индексов (BrainMaker); биржевые прогнозы, проверка подлинности кредитных карт (HNC). Помимо анализа финансовой деятельности нейросети успешно справляются с идентификацией непривычных для людей образов, распознаванием речи (Avalanche), синтезом речи и текста (Back propagation), управлением роботом (Cerebellatron), идентификация написанных от руки символов (Неокогнитрон, Япония) нечеткий решение функция принадлежность
Нечеткие деревья решений применяются в Data Mining <http://www.basegroup.ru/glossary_ajax/definitions/data_mining> как для решения задач классификации, так и для решения задачи регрессии, когда необходимо знать степени принадлежности к тому или иному исходу. Они могут быть использованы в различных областях: в банковском деле для решения задачи скоринга <http://www.basegroup.ru/glossary_ajax/definitions/scoring>, в медицине для диагностики различных заболеваний, в промышленности для контроля качества продукции и так далее.
Безусловным достоинством данного подхода является высокая точность <http://www.basegroup.ru/glossary_ajax/definitions/precision> классификации, достигаемая за счет сочетания достоинств нечеткой логики и деревьев решений. Процесс обучения происходит быстро, а результат прост для интерпретации. Так как алгоритм способен выдавать для нового объекта не только класс, но и степень принадлежности к нему, это позволяет управлять порогом для классификации.
Однако для этого необходим
репрезентативный набор обучающих примеров, в противном случае сгенерированное
алгоритмом дерево решений будет слабо отражать действительность и, как
следствие, выдавать ошибочные результаты.
СПИСОК ИСПОЛЬЗУЕМОЙ ЛИТЕРАТУРЫ
http://www.stgau.ru/company/personal/user/8068/files/lib.pdf://stu.scask.ru/book_ins.php?id=26://www.pcweek.ru/themes/detail.php?ID=43833
Обработка нечеткой информации в системах принятия решений А.Н.Борисов, 1989
Лекции по принятию решений в условиях нечеткой информации Губко М.В. 2004