Курсовая работа (т): Исследование механизмов безопасности в Linux подобных ОС
Зачем это нужно? Например, необходимо рассмотреть данные устройства, выводящего звук:-l /dev/dsp
После чего в терминале отобразится следующее:
crw-rw----+ 1 root audio 14, 3 2010-06-10 11:59 /dev/dsp
То есть считать данные может только пользователь root и все, кто входит в группу audio. Следовательно, если у пользователя не проигрывается звук и система выдает, что не может получить доступ, необходимо просто проверить права. Справедливости ради нужно отметить, что права доступа имеет не пользователь, а процесс, запущенный им. Каждый пользователь, зарегистрировавшись в системе, получает свою копию текущего процесса shell, который имеет установленные идентификаторы RID и RGID - реальные идентификаторы пользователя и первичной группы пользователя. А все процессы, запущенные пользователем (дочерние), наследуют все переменные, в том числе RID и RGID.
Остались нерассмотренными три режима файла: бит сохранения задачи (stisky bit), а также флаги SUID и SGID. Со stisky bit все просто, этот бит указывает на необходимость сохранения копии выполняющейся программы в памяти после завершения выполнения. Данный режим позволяет сэкономить время на запуске программы при частом использовании, но в современных системах применение этого режима встречается редко.
Флаги SUID и SGID позволяют изменить (расширить) права пользователя (группы), запустившего программу, на время ее выполнения. Как уже говорилось, запущенное приложение имеет такие же права доступа к системным ресурсам, как и пользователь, запустивший программу. А установки этих флагов позволяют назначить права доступа исходя из прав доступа владельца файла. Следовательно, если владельцем запущенного приложения является root, то любой, независимо от того, кто запустил данное приложение, будет иметь права суперпользователя. Вместе с тем при установке флага SUID наследуются права владельца файла, a SGID - группы-владельца.
Буква s в выводе команды ls -l означает, что установлен флаг SUID, а владельцем файла является - root, и теперь, кто бы ни запустил утилиту на выполнение, на время работы программы он временно получает права суперпользователя, то есть право произвести запись в защищенный системный файл. Естественно, утилита должна (и делает это) производить изменение учетной записи только запустившего ее пользователя.
Для установки битов SUID/SGID в символьной форме используется буква s, sticky bit устанавливается буквой - t , а с помощью буквы l можно установить блокировку файла для устранения возможных конфликтов, когда несколько процессов попытаются работать с одним и тем же файлом.
Обычно sticky bit установлен в каталоге /tmp.
Это сделано для того, чтобы удалить файл мог только пользователь, создавший
его. При установке бита SGID для каталога все вновь созданные файлы будут
теперь наследовать группу не по пользователю, создавшему его, а по группе -
владельцу каталога.
.4 Файловая система
Под файловой системой понимается физический способ организации данных на дисковом разделе, то есть возможность хранения, нахождения и манипулирования (запись, перезапись и удаление).
Еще один момент, с которым придется столкнуться во время установки Linux Mint, - выбор файловой системы. В отличие от Windows, которая предлагает отформатировать диск в NTFS или FAT32, а в последних версиях - только в NTFS, в Linux Mint выбор гораздо больше. Современное ядро поддерживает следующие файловые системы, на которых можно установить Linux, - ext2, ext3, ext4, ReiserFS, XFS и JFS. А список всех файловых систем, разделы которых может монтировать Linux Mint, еще больше, в том числе в этом списке находятся и файловые системы, считающиеся родными для других операционных систем, в частности Windows. В данном случае была выбрана файловая система ext4.
Файловая система ext3 заслужила репутацию надежной, ей доверяют свои данные многие пользователи и корпорации. Но наиболее существенным ограничением является максимальный размер хранилища 16 Тбайт. Чтобы снять это ограничение, в середине 2006 г. была выпущена серия заплаток (patch), которые, в свою очередь, нарушали обратную совместимость. Поэтому было принято решение на основе заплаток создать новую файловую систему, которая получила название ext4.
Главная задача разработчиков - не просто повысить производительность и улучшить характеристики, но и предоставить простой путь перехода пользователей, работавших с ext2 или ext3, на новую версию файловой системы. В результате ext4 получила следующие особенности:
Совместимость. Любая имеющаяся файловая система типа Ext3 может быть конвертирована в Ext4 путём простой процедуры, состоящей из запуска пары команд в режиме «только чтение». Это означает, что можно повысить производительность и вместимость и улучшить возможности имеющейся файловой системы без переформатирования и без переустановки ОС и программ.будет использовать новые структуры только для новых данных, а старые при этом останутся неизменными. При необходимости их можно будет читать и изменять. Это безусловно означает, что, единожды сменив файловую систему на Ext4, вернуть Ext3 будет уже невозможно.
Также имеется возможность смонтировать файловую систему Ext3 как Ext4 без использования нового формата данных, что позволит впоследствии смонтировать её опять как Ext3. При этом, само собой, не можно воспользоваться многочисленными преимуществами Ext4.
. Больший размер файлов и файловой системы. На сегодняшний день максимальный размер файловой системы Ext3 равен 16 терабайтам, а размер файла ограничен 2 терабайтами. В Ext4 добавлена 48-битная адресация блоков, что означает, что максимальный размер этой файловой системы равен одному экзабайту, и файлы могут быть размером до 16 терабайт. 1 EB (экзабайт) = 1,048,576 TB (терабайт), 1 EB = 1024 PB (петабайт), 1 PB = 1024 TB, 1 TB = 1024 GB. Почему 48-битная, а не 64-битная? Имелся ряд ограничений, которые необходимо было бы снять, чтобы сделать Ext4 полностью 64-битной, и такой задачи перед Ext4 не ставилось. Структуры данных в Ext4 проектировались с учётом требуемых изменений, поэтому однажды в будущем поддержка 64 бит в Ext4 появится. Пока же придётся довольствоваться одним экзабайтом.
. Масштабируемость подкаталогов. В настоящий момент один каталог Ext3 не может содержать более чем 32000 подкаталогов. Ext4 снимает это ограничение и позволяет создавать неограниченное количество подкаталогов.
. Экстенты. Традиционные файловые системы, произошедшие от Unix, такие как Ext3, используют схему непрямого отображения блоков для отслеживания каждого блока, отвечающего за хранение данных файла. Такой подход неэффективен для больших файлов, особенно при операциях удаления и усечения таких файлов, поскольку карта соответствия содержит по одной записи на каждый отдельный блок. В больших файлах блоков много, их карты соответствия большие, и обрабатываются они медленно.
В современных файловых системах применяется иной подход, основанный на так называемых экстентах. Экстент - это в общем-то набор последовательных физических блоков. Он как бы говорит: «Эти данные находятся в следующих n блоках». Например, файл размером в 100 мегабайт может храниться в единственном экстенте такого же размера, вместо того, чтобы быть разбитым на 25600 4-килобайтных блоков, адресуемых путём непрямого отображения. Огромные файлы можно разделить на несколько экстентов.
Благодаря применению экстентов улучшается производительность, а также уменьшается фрагментированность, поскольку экстенты способствуют непрерывному размещению данных.
. Многоблочное распределение. Если в Ext3 нужно записать на диск новые данные, специальный механизм распределения блоков определяет, какие блоки из числа свободных будут для этого использованы. Проблема в том, что в Ext3 этот механизм распределяет в один присест только один блок (4 килобайта). Это означает, что, если нужно записать, скажем, ранее упомянутые 100 мегабайт данных, нужно будет обратиться к механизму распределения 25600 раз. Мало того, что это неэффективно, это к тому же не позволяет оптимизировать политику распределения, поскольку соответствующий механизм не имеет понятия о реальном объёме данных, подлежащем записи, а знает только об одном-единственном блоке.использует механизм многоблочного распределения (multiblock allocator, mballoc) который позволяет распределить любое количество блоков с помощью единственного вызова и избежать огромных накладных расходов. Благодаря этому производительность существенно вырастает, что особенно заметно при отложенном распределении с использованием экстентов. Эта возможность никак не влияет на формат данных.
. Отложенное распределение. Отложенное распределение представляет собой способ повышения производительности, не влияющий на формат данных и представленный в современных файловых системах, таких как XFS, ZFS, btrfs и Reiser 4.
Суть этого метода состоит в отсрочке выделения блоков насколько это возможно - по контрасту с подходом, применяемым в традиционных файловых системах (таких как Ext3, reiser3 и т. д.): распределять блоки сразу, при первой возможности. Например, если процесс осуществляет запись вызовом write(), файловая система распределит блоки под запись немедленно - даже если данные пока не будут записываться на диск, а будут находиться какое-то время в кэше. Недостатки такого подхода, например, в том, что, если процесс непрерывно осуществляет запись в растущий файл, последовательные вызовы write() постоянно распределяют блоки данных, и при этом неизвестно, будет ли файл расти далее.
При использовании отложенного распределения блоки сразу не выделяются при обращении к write(). Вместо этого распределение откладывается до момента, когда файл будет записан из кэша на диск. Благодаря этому механизм получает возможность оптимизировать процесс распределения. Наибольший выигрыш получается при использовании двух ранее упомянутых возможностей - экстентов и многоблочного распределения, поскольку часто встречается ситуация, когда окончательный файл пишется на диск в виде экстентов, распределённых с помощью mballoc. Это даёт существенный прирост производительности, и иногда сильно снижает фрагментированность данных.
. Контрольные суммы журнала. Журнал является наиболее часто используемой частью диска, вследствие чего блоки, из которых он состоит, становятся особенно чувствительными к отказам оборудования. Более того, попытка восстановления при повреждённом журнале может привести к ещё более массовым повреждениям в данных. Ext4 подсчитывает контрольные суммы журнальных данных, что позволяет определить факт их повреждения. У этого есть и ещё одно преимущество: благодаря контрольным суммам можно превратить систему двухфазной фиксации журнала Ext3 в однофазную, что ускоряет файловые операции в отдельных случаях до 20 %, таким образом, улучшаются одновременно и надёжность, и производительность.
. Режим без журналирования. Журналирование обеспечивает целостность файловой системы путём протоколирования всех происходящих на диске изменений. Но оно также вводит дополнительные накладные расходы на дисковые операции. В некоторых особых ситуациях журналирование и предоставляемые им преимущества могут оказаться излишними. Ext4 позволяет отключить журналирование, что приводит к небольшому приросту производительности.
. Устойчивое перераспределение. Эта возможность, доступная уже в Ext3 в последних версиях ядра и эмулируемая glibc в файловых системах, которые её не поддерживают, позволяет приложениям заранее распределять дисковое пространство, сообщая о своих потребностях файловой системе. Та, в свою очередь, выделяет необходимое количество блоков и структур данных, но они пусты до тех пор, пока приложение в реальности не осуществит в них запись.
Это именно то, что делают, например, P2P-приложения, выделяя место для данных, которые появятся там только спустя часы или дни. Однако реализовано это намного более эффективно - на уровне файловой системы и с универсальным API.
Применений этому несколько: во-первых, чтобы предотвратить выполнение того же самого приложениями (такими как P2P), неэффективно заполняющими файлы нулями - нужные блоки будут выделены разом.
Во-вторых, чтобы снизить фрагментацию - опять же потому, что блоки выделяются однократно, настолько непрерывно, насколько это возможно.
В-третьих, чтобы гарантировать, что приложение будет иметь столько места, сколько ему требуется, что особенно важно для приложений, работающих в реальном времени, поскольку файловая система может вдруг переполниться в процессе выполнения важной операции.
. Механизм «шлагбаумов» по умолчанию включен. Это опция, обеспечивающая целостность файловой системы ценой некоторой потери производительности (её можно отключить с помощью «mount -o barrier=0», рекомендуется сделать это при замерах производительности).
Выдержка из статьи LWN: «Код файловой системы
обязан перед созданием записи фиксации [журнала] быть абсолютно уверенным, что
вся информация о транзакции помещена в журнал. Просто делать запись в
правильном порядке недостаточно; современные диски имеют кэш большого объёма и
меняют порядок записи для оптимизации производительности. Поэтому файловая
система обязана явно сообщить диску о необходимости записать все журнальные
данные на носитель перед созданием записи фиксации; если сначала будет создана
запись фиксации, журнал может быть повреждён. Блокирующая система ввода-вывода
ядра предоставляет такую возможность благодаря использованию механизма
«шлагбаумов» (barriers); проще говоря, «шлагбаум» запрещает запись любых
блоков, посланных после него, до того момента, как всё, что было прислано перед
«шлагбаумом», будет перенесено на носитель. При использовании «шлагбаумов»
файловая система может гарантировать, что всё, что находится на диске, целостно
в любой момент времени».
2.5 Резервное копирование данных
Резервное копирование данных - процесс создание копий важной информации, которые хранятся на других хранилищах данных (флешка, жесткий диск, DVD-диск, облачный сервис и т.д.). Резервное копирование данных очень важная операция, которую должен производить любой пользователь, через определенный промежуток времени.
Для начала рассмотрим резервное копирование
файлов через графический интерфейс.
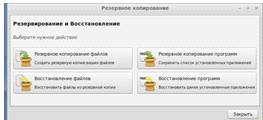
Рисунок 2.6 - Резервное копирование
Для начала необходимо выбрать в качестве источника данных домашний каталог. Далее выбрать, где вы хотите разместить резервную копию файлов. В дополнительных параметрах следует выбрать следующее:
Описание.
Переписать (можно игнорировать этот параметр, он вступает в силу, если пользователь планирует обновить уже существующие резервные копии).
Проверить целостность: замедляет процесс, но делает его более надёжным, он проверяет подпись каждого файла после его резервного копирования.
Сохранить права доступа и временные метки.
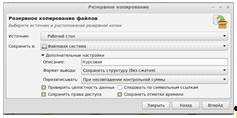
Рисунок 2.7 - Резервное копирование файлов
Для экономии места и времени, можно исключить те директории в которых пользователь не нуждается.
Для резервного копирования программного
обеспечения необходимо нажать на кнопку «Резервное копирование программ». Далее
необходимо выбрать место для хранения создаваемой резервной копии.
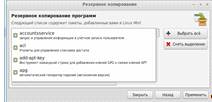
Рисунок 2.8 - Резервное копирование программ
Для восстановления данных и программ следует
запустить «Восстановление файлов» и «Восстановление программ» соответственно.