Материал: Методические указания к лабораторным работам № 6–9 по дисциплинам «Основы построения защищенных СУБД», «Безопасность систем баз данных». Плотников Д.Г

Кластерные и некластерные индексы
Как уже упоминалось, для каждой таблицы может существовать только один кластерный индекс. Ниже перечислены случаи, в которых применять кластерные индексы целесообразно:
Столбцы используются в широком диапазоне запросов
Столбцы используются в директивах ORDER BY и GROUP BY запросов
Столбцы используются для объединения таблиц Используются запросы, возвращающие большой результирующий набор данных
Некластерные индексы целесообразно применять в ситуациях, перечисленных ниже:
Столбцы используются в функциях суммирования и группирования
Столбцы имеют внешние ключи
Используются запросы, возвращающие небольшие результирующие наборы данных Доступ к информации часто осуществляется с помощью
некоторого столбца, используемого в условиях объединения таблиц или в директивах ORDER BY и GROUP BY запросов
Контрольн ые вопросы
1.Что такое кластерный индекс? В чем его отличие от некластерного?
2.Можно ли создать неуникальный кластерный
индекс?
3.В чем отличие первичного ключа и уникального
индекса?
4.В каких случаях имеет смысл создавать индексы? Какие колонки следует включать в индекс и почему?
5.Какие существуют способы внутренней организации индексов?
54
6.Рассказать о проблеме фрагментации индексов. Как бороться с фрагментацией?
7.Имеет ли значение порядок указания колонок при создании индекса?
8.В чем разница между Index Scan и Index Seek?
Дополнительные вопросы
1.Исправить ошибки в подготовленных выборках.
2.Могут ли индексы ухудшить производительность? Если да, то продемонстрировать это.
3.На что влияет порядок сортировки (ASC\DESC) при создании индекса? Продемонстрировать это.
4.Объяснить и продемонстрировать разницу в скорости выполнения запросов в зависимости от того, входят ли все колонки из списка выборки в некластерный индекс.
55
БИБЛИОГРАФИЧЕСКИЙ СПИСОК
1. Кузнецов, С. Д. Основы баз данных [Текст] / С. Д. Кузнецов. – М.: Бином. Лаборатория знаний, Интернетуниверситет информационных технологий, 2007.
2. Microsoft SQL Server 2005 Books Online. [Электронный ресурс] – Режим доступа: http://msdn.microsoft.com/en-us/library/ms130214%28v=sql.90%29.aspx
3.Гарсиа-Молина, Г. Системы баз данных. Полный курс [Текст] / Г. Гарсиа-Молина, Дж. Ульман, Д. Уидом. – М.: Вильямс, 2004.
4.Ульман, Дж. Основы реляционных баз данных [Текст] / Дж. Ульман, Д. Уидом. – М.: Лори, 2006.
5.Коннолли, Т. Базы данных: проектирование, реализация и сопровождение. Теория и практика [Текст] / Т. Коннолли, К. Бегг. – М.: Вильямс, 2003.
6.Станек У. Р. Microsoft SQL Server 2005. Справочник администратора [Текст] / У. Р. Станек. – М.: Русская редакция, 2008.
7.Нильсен, П. SQL Server 2005. Библия пользователя [Текст] /П. Нильсен. – М.: Вильямс, 2008.
.
56
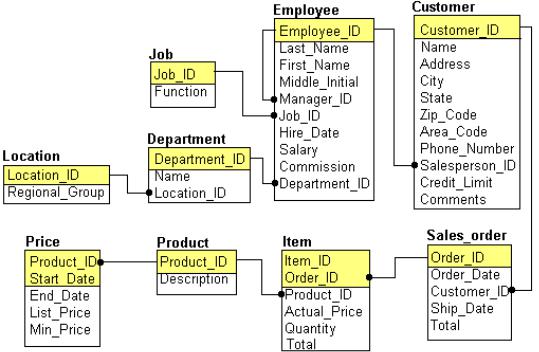
ПРИЛОЖЕНИЕ 1
Концептуальная схема учебной базы данных
57
ПРИЛОЖЕНИЕ 2
Таблицы базы данных
|
N |
|
|
Имя столбца |
|
|
Тип данных |
|
Тип данных |
|
Комментарий |
|
|
|
|
|
|||||||
|
пп |
|
|
|
|
Oracle |
|
DB2(MSSQL) |
|
||
|
|
|
|
|
|
|
|
|
|||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||||
|
Таблица EMPLOYEE - сотрудники фирмы |
|
|
||||||||
|
|
|
|
|
|
|
|
|
|
||
|
1 |
|
employee_id |
|
NUMBER(4,0) |
|
SMALLINT |
|
Код сотрудника |
||
|
|
|
|
|
|
|
|
|
|
||
|
2 |
|
last_name |
|
VARCHAR2(15) |
|
VARCHAR(15) |
|
Фамилия |
||
|
|
|
|
|
|
|
|
|
|
||
|
3 |
|
first_name |
|
VARCHAR2(15) |
|
VARCHAR(15) |
|
Имя |
||
|
|
|
|
|
|
|
|
|
|
||
|
4 |
|
middle_initial |
|
VARCHAR2(1) |
|
VARCHAR(1) |
|
Средний инициал |
||
|
|
|
|
|
|
|
|
|
|
||
|
5 |
|
manager_id |
|
NUMBER(4,0) |
|
SMALLINT |
|
Код начальника |
||
|
|
|
|
|
|
|
|
|
|
||
|
6 |
|
job_id |
|
NUMBER(3,0) |
|
SMALLINT |
|
Код должности |
||
|
|
|
|
|
|
|
|
|
|
||
|
7 |
|
hire_date |
|
DATE |
|
DATE(DATETIME) |
|
Дата поступления в фирму |
||
|
|
|
|
|
|
|
|
|
|
||
|
8 |
|
salary |
|
NUMBER(7,2) |
|
NUMERIC(7,2) |
|
Зарплата |
||
|
|
|
|
|
|
|
|
|
|
||
|
9 |
|
commission |
|
NUMBER(7,2) |
|
NUMERIC(7,2) |
|
Комиссионные |
||
|
|
|
|
|
|
|
|
|
|
||
|
10 |
|
department_id |
|
NUMBER(2,0) |
|
SMALLINT |
|
Код отдела |
||
|
|
|
|
|
|
|
|
|
|
|
|
CREATE TABLE EMPLOYEE (
employee_id SMALLINT NOT NULL PRIMARY KEY,
58