Материал: Методы статистического и интеллектуального анализа данных. Минаева Ю.В
которых значения атрибута удовлетворяют или не удовлетворяют правилу в родительском узле.
Деревья решений строятся на основе обучающей выборки, в которой известна принадлежность объектов к конкретным классам, и в дальнейшем используются для классификации новых объектов.
Классический алгоритм построения дерева решений заключается в следующем. В корневом узле происходит разделение объектов обучающей выборки на два или более подмножества на основе значений атрибута, выбранного в соответствии с критерием разделения. Для каждого из полученных подмножеств создается дочерний узел. Затем процесс ветвления повторяется для каждого дочернего узла до тех пор, пока не будет выполнено одно из условий остановки алгоритма.
В настоящее время разработано большое количество алгоритмов построения деревьев решений. Они отличаются способом отбора атрибутов для разбиения в каждом узле, условиями остановки и методикой упрощения построенного дерева.
Упрощение дерева (отсечение ветвей) заключается в том, что после его построения удаляются те узлы, правила в которых имеют низкую ценность, поскольку относятся к небольшому числу примеров.
4.4.4. Искусственные нейронные сети
Такие инструменты Data Mining, как регрессионный анализ и деревья решений, довольно успешно применяются для решения задач классификации и прогнозирования. Однако они не являются универсальными и не всегда позволяют разделить исходное множество элементов на классы с приемлемой точностью, особенно, если зависимости между признаками нелинейные. В таком случае применяются более сложные модели – нейронные сети.
76
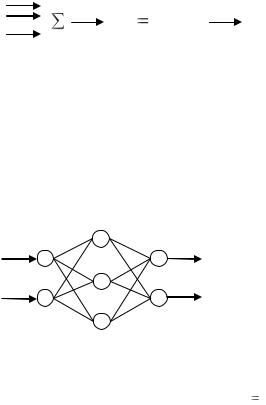
Нейронные сети, или искусственные нейронные сети, представляют собой модели, которые в процессе функционирования имитируют работу головного мозга. Нейронная сеть состоит из простейших вычислительных элементов – искусственных нейронов, связанных между собой. Каждый нейрон имеет несколько входных и одну выходную связь. Каждая входная связь обладает весом, на который умножается сигнал, поступающий по ней с выхода другого нейрона. Каждый нейрон выполняет простейшее преобразование взвешенное суммирование своих входов (рис.
16).
x |
1 |
w 1 |
|
S |
|
|
y |
|
|
|
|
y |
f (S) |
||||
x |
2 |
|
|
|
|
|
||
x n |
w |
|
|
|
|
|
|
|
|
|
|
|
|
|
|||
n |
|
|
|
|
|
|||
|
|
|
|
|
|
|
|
|
Рис. 16. Искусственный нейрон
В нейронных сетях нейроны объединяются в слои, при этом выходы нейронов предыдущего слоя являются входами нейронов следующего слоя. В каждом слое нейроны выполняют параллельную обработку данных. Пример нейронной сети представлен на рис. 17.
x1 |
y1 |
|
x |
2 |
y 2 |
|
|
|
Рис. 17. Пример простейшей нейронной сети
Первый слой называется входным, его нейроны обеспечивают ввод в сеть входного вектора X {x1, x 2 } и
77
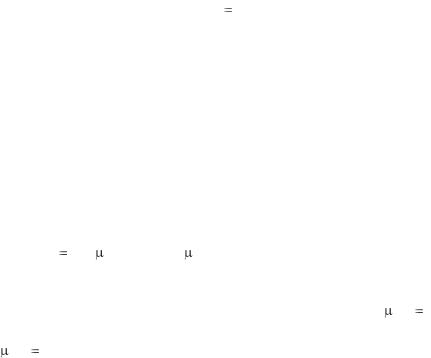
распределяют его по нейронам следующего слоя. Нейроны последнего слоя, обеспечивающие вывод результатов, называются выходными и образуют выходной слой. Между входным и выходным нейронами расположены один или несколько промежуточных слоев, называемых скрытыми. Именно в скрытых слоях производится основная обработка данных.
В процессе работы нейронной сети значения входных переменных x i передаются по межнейронным связям и
умножаются на весовые коэффициенты w i , полученные
значения суммируются в нейроне. Также в каждом нейроне выполняется простое преобразование с помощью активационной функции f (S) , обычно нелинейной.
В результате преобразования значений входного вектора всеми нейронами сети на ее выходе формируется вектор результата (выходной вектор) Y {y1, y2} .
4.4.5. Нечеткая логика
Математическая теория нечеткой логики появилась в результате наличия нечетких и приближенных рассуждений при описании человеком процессов, систем и объектов.
В основе нечеткой логики лежит возможность работы с нечеткими множествами, с помощью которых можно формально определить неточные и многозначные понятия («средний возраст», «высокий доход», «неблагонадежный заемщик» и т.д.).
Нечеткое множество – множество упорядоченных пар вида X {x, (x)} , где (x) – функция принадлежности,
обозначающая степень принадлежности элемента x к нечеткому множеству X. Функция принадлежности может принимать значения в интервале [0, 1] , при этом (x) 0 означает отсутствие принадлежности элемента x множеству, а
(x) 1 означает полную принадлежность.
78
Совокупность нечетких множеств, относящихся к одному объекту, образует лингвистическую переменную.
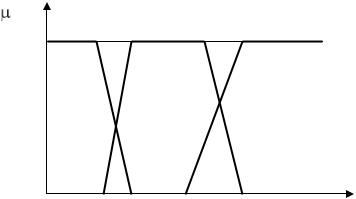
Например, лингвистическая переменная Доход может принимать значения {Низкий, Средний, Высокий}. Пусть функции принадлежности для каждого нечеткого множества заданы четверкой чисел: Низкий = {0, 0, 20, 30}, Средний =
{20, 30, 60, 70}, Высокий = {50, 70, 100, 100}. Графическая иллюстрация лингвистической переменной Доход приведена на рис. 18.
(x)
Низкий |
Средний |
Высокий |
1
0
20 |
40 |
60 |
80 |
100 X |
Рис. 18. Графическая иллюстрация лингвистической переменной
Математический аппарат нечеткой логики успешно включается в состав практически всех алrоритмов Data Mining; так появились нечеткие нейронные сети, нечеткие деревья решений, нечеткие ассоциативные правила. Объединение технологии баз данных и нечетких запросов позволяет аналитикам получать нечеткие срезы и т.д.
79

4.4.6. Генетический алгоритм
Генетический алгоритм является методом случайного управляемого поиска оптимального решения с использованием набора эвристических правил, основанных на процессах эволюционного развития биологических популяций – естественного отбора, скрещивания, замещении и мутации. Потенциальные решения в генетическом алгоритме представляются в виде популяции хромосом, каждая из которых имеет в своем составе набор генов.
Основными этапами генетического алгоритма являются:
–выбор наиболее перспективных на данный момент решений (хромосом);
–скрещивание (кроссовер) выбранных хромосом;
–включение полученных в результате скрещивания хромосом в популяцию с замещением наихудших хромосом;
–мутация хромосом.
К настоящему времени разработано несколько способов
представления решений в виде хромосом. |
|
||
Самым |
распространенным |
является |
бинарное |
кодирование, когда каждая хромосома представляется в виде последовательности 0 и 1. Такой способ, как правило, используется при решении целочисленных задач оптимизации. Однако для отдельных типов задач удобней использовать хромосомы, в которых каждый ген кодируется численным значением или некой константой (строковой или числовой).
Пусть |
популяция |
состоит |
из |
множества |
хромосом X |
x1,...xn , где n – размер популяции. В качестве |
|||
методов селекции родительских хромосом из множества X используются следующие наиболее часто используется метод рулетки, согласно которому вероятность выбора i–й хромосомы ( i 1,..., n ) пропорциональна удельному весу
соответствующего ей значения целевой функции F(xi ) в суммарной функциональной оценке всей популяции, т.е.
80