Материал: Методы статистического и интеллектуального анализа данных. Минаева Ю.В
–статистическое наблюдение – включает в себя сбор первичной статистической информации;
–обработка первичной информации;
–анализ первичной информации и интерпретация полученных результатов.
1.2. Методы предварительной обработки результатов наблюдений
Перед тем, как перейти к детальному анализу полученных в результате наблюдений данных, их приводят к одному из следующих видов:
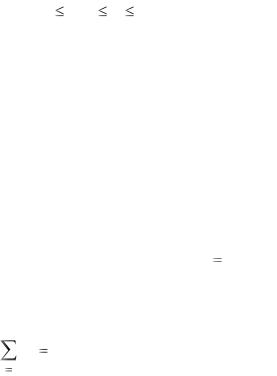
1. Вариационный ряд – элементы выборки располагаются в порядке возрастания (неубывания):
x (1) , x(2) ,..., x(n) ,
где x(1) x (2) ... x (n) , .
Переход от случайной выборки к ее вариационному ряду не приводит к потере информации, поскольку функции распределения остается такой же, однако происходит искажение исходных данных, поскольку элементы упорядоченной выборки уже не являются взаимно независимыми.
Данные, приведенные к вариационному ряду,
называются негруппированными.
2. Статистический ряд – преобразование выборки с повторяющимися элементами в таблицу. Данные, представленные в виде статистического ряда, являются
группированными.
Пусть |
выборка |
X n |
x1, x2 ,..., xn |
содержит m |
|
различных элементов z(1) , z(2) ,..., z(m) , каждый из |
которых |
||||
повторяется, |
соответственно, |
n1, n2 ,..., nm |
раз, |
причем |
|
m |
|
|
|
|
|
ni n . |
|
|
|
|
|
i 1 |
|
|
|
|
|
6
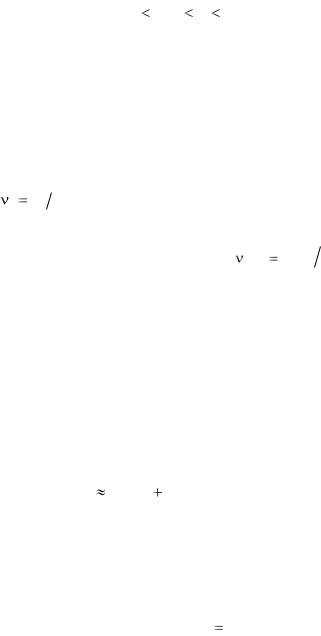
Врезультате группировки исходная выборка
преобразуется в таблицу, где z(1) |
z(2) |
... z(m) (табл. 1). |
|||||
|
|
|
|
|
|
Таблица 1 |
|
|
|
|
|
|
|
|
|
|
z(1) |
z (2) |
|
… |
|
z(m) |
|
|
n1 |
n2 |
|
… |
|
nm |
|
Числа ni , показывающие, сколько раз элемент z(i) встречается в выборке, называются частотами значения z(i) , а
величины |
i ni n |
– относительными |
|
частотами. |
||
Накопленной |
частотой |
nнак |
называется число |
элементов |
||
|
|
i |
|
|
|
|
выборки, меньших значения z |
(i) , отношение |
нак |
нак |
n – |
||
i |
ni |
|||||
относительной накопленной частотой.
Статистический ряд, как правило, применяется для группировки небольших выборок с дискретными элементами. Для выборок большого объема из непрерывных генеральных совокупностей используется интервальный статистический ряд. В этом случае область задания выборки X разбивается на m интервалов, а числа ni указывают количество элементов
выборки, попавших в i–й интервал.
Число интервалов m может быть задано природой исследуемого явления, условиями проведения наблюдений или определяться по формуле Старджеса:
m log 2 n 1.
При подсчете частот ni для однозначности считают, что
каждый интервал включает свою левую границу и не включает правую, за исключением последнего интервала, включающего и левую, и правую границы.
Пример. При тестировании СУБД проводились измерения времени выполнения запросов к базе данных. Получилась следующая выборка объемом n 20 элементов:
7
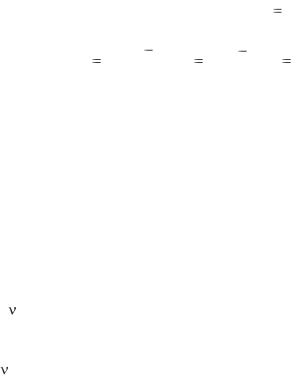
2.92 |
6.28 |
3.12 |
5.46 |
5.02 |
3.54 |
4.64 |
3.54 |
5.30 |
4.08 |
|
|
|||||||||||||||||
4.08 |
4.52 |
4.64 |
5.02 |
3.12 |
5.02 |
4.08 |
2.92 |
5.30 |
6.28 |
|
||||||||||||||||||
|
|
|
Вариационный ряд для данной выборки имеет вид: |
|||||||||||||||||||||||||
2.92 |
2.92 |
3.12 |
3.12 |
3.54 |
3.54 |
4.08 |
4.08 |
4.08 |
4.52 |
|
||||||||||||||||||
4.64 |
4.64 |
5.02 |
5.02 |
5.02 |
5.30 |
5.30 |
5.46 |
6.28 |
6.28 |
|
||||||||||||||||||
|
|
|
Сформируем статистический ряд для выборки (табл. 2). |
|||||||||||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Таблица 2 |
|||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||
|
|
z(i) |
|
2.92 |
|
3.12 |
3.54 |
4.08 |
4.52 |
|
4.64 |
5.02 |
5.30 |
5.46 |
6.28 |
|
|
|||||||||||
|
|
ni |
|
2 |
|
2 |
2 |
3 |
|
1 |
|
|
2 |
|
3 |
|
2 |
|
1 |
2 |
|
|
||||||
|
|
|
Далее построим интервальный статистический ряд. Для |
|||||||||||||||||||||||||
наглядности число интервалов примем m |
6 . |
|
|
|
|
|
|
|||||||||||||||||||||
|
|
|
Определим длину интервала: |
|
|
|
|
|
|
|
|
|
|
|||||||||||||||
|
|
|
|
|
|
L |
|
|
xmax xmin |
|
6.28 |
2.92 |
0.56. |
|
|
|
|
|
|
|||||||||
|
|
|
|
|
|
|
|
|
m |
|
|
|
|
|
6 |
|
|
|
|
|
|
|
|
|||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|||
где xmax |
|
и xmin – максимальный и минимальный элементы |
||||||||||||||||||||||||||
выборки, соответственно. |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||||||||
|
|
|
С учетом значения L определим границы интервалов |
|||||||||||||||||||||||||
Li , найдем их середины |
z(i) |
|
и |
вычислим |
для |
каждого |
||||||||||||||||||||||
интервала частотные характеристики (табл. 3). |
|
|
|
|
|
|
||||||||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Таблица 3 |
|||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Li |
|
[2.92, 3.48) |
|
[3.48, 4.04) |
[4.04, 4.60) |
|
[4.60, 5.16) |
[5.16, 5.72) |
|
[5.72, 6.28] |
|
||||||||||||||||
|
|
|
|
|
|
|
|
|||||||||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||||
|
z(i) |
|
|
3.20 |
|
|
3.76 |
4.32 |
|
|
|
4.88 |
|
5.44 |
|
|
|
6.00 |
|
|
||||||||
|
ni |
|
|
4 |
|
|
|
|
2 |
4 |
|
|
|
|
5 |
|
|
3 |
|
|
|
2 |
|
|
||||
|
|
i |
|
|
0.2 |
|
|
0.1 |
0.2 |
|
|
|
0.25 |
|
0.15 |
|
|
|
0.1 |
|
|
|||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
нак |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
ni |
|
|
4 |
|
|
|
|
6 |
10 |
|
|
|
|
15 |
|
18 |
|
|
|
20 |
|
|
|||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
нак |
|
|
0.2 |
|
|
0.3 |
0.5 |
|
|
|
0.75 |
|
0.90 |
|
|
|
1.00 |
|
|
||||||||
|
i |
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||||||||||
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
8
1.3. Графическое |
изображение |
статистических |
||
данных |
|
|
|
|
Для |
визуализации |
статистической |
информации |
|
используются следующие виды графиков:
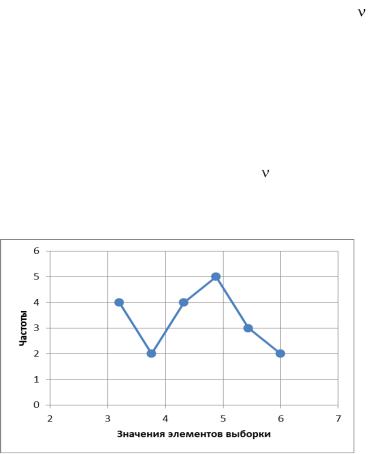
1. Полигон частот представляет собой ломаную линию, вершинами которой являются точки с координатами (xi , i ) , и
применяется, в основном, для наглядного изображения выборки из дискретной генеральной совокупности.
|
2. |
Гистограмма – диаграмма, состоящая из |
|||
прямоугольников с шириной, равной интервалу L, и высотой |
|||||
ni , |
применяется |
для |
визуализации |
интервального |
|
статистического ряда. |
|
|
|
||
|
3. |
Кривая накопленных частот (кумулятивная кривая) |
|||
|
|
|
|
нак |
|
– ломаная линия с вершинами в точках (xi , i |
) . |
||||
Пример. Построим графики для выборки из табл. 3 (рис.
1–3).
Рис. 1. Полигон частот для случайной выборки
9
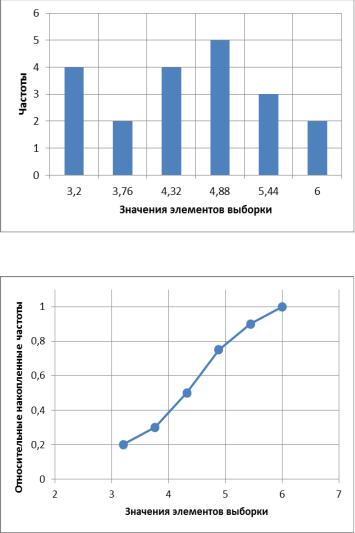
Рис. 2. Гистограмма частот для случайной выборки
Рис. 3. Кривая накопленных частот для случайной выборки
10