Материал: Модели и алгоритмы проектирования и разработки систем поддержки принятия инвестиционных решений. Морозов В.П., Баркалов С.А
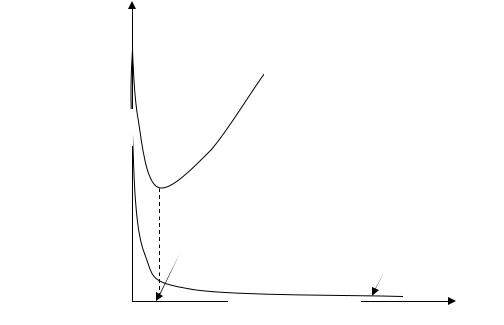
Кривая для подмножества
тестирования
Среднеквадрати-
ческая ошибка
Точка раннего останова Кривая для обучающей
выборки
Количество эпох
Рис. 2.32. Процесс обучения с ранним остановом на основе перекрестной оценки
показывает их различное поведение. Функция обучения на подмножестве оценивания монотонно убывает с увеличением количества эпох, в то время как кривая обучения на проверочном подмножестве монотонно убывает до некоторого минимума, после чего при продолжении обучения начинает возрастать. Если учитывать только кривую, построенную на подмножестве оценивания, то возникает соблазн продолжать обучение и после прохождения точки минимума на кривой, построенной на проверочном подмножестве. Однако на практике оказалось, что после прохождения этой точки сеть обучалась только посторонним шумам, содержащимся в обучающей выборке. Поэтому было принято решение об использовании точки минимума кривой тестирования в качестве критерия останова сеанса обучения. Когда ошибки на подмножествах оценивания и проверки не одинаково стремились к нулю (что характерно для данных, не содержащих шума), емкости сети оказывалось не достаточно для точного функционирования модели. В этом случае минимизировалась интегрированная квадратичная ошибка, что (приблизительно) эквивалентно минимизации обычной глобальной среднеквадратической ошибки при равномерном распределении входного сигнала.
Для повышения эффективности обучения ИНС использовалось комбинирование последовательного и пакетного режимов обучения. В рамках последовательного режима обучения корректировка весов проводилась после подачи каждого примера. Для примера рассмотрим эпоху, состоящую из N обучающих примеров, упорядоченных следующим образом: ((x1),d(1)),.., (x(N),d(N)). Сети предъявлялся первый пример (x(l),d(l)) этой эпохи, после чего выполнялись описанные выше прямые и обратные вычисления. В результате проводилась
121
корректировка синаптических весов и уровней порогов в сети. После этого сети предъявлялась вторая пара (x(2),d(2)) в эпохе, повторялись прямой и обратный проходы, приводящие к поледующей коррекции синаптических весов и уровня порога. Этот процесс повторялся, пока сеть не завершала обработку последнего примера (пары) данной эпохи - (x(N), d(N)). В пакетном режиме обучения корректировка весов проводилась после подачи в сеть всех примеров обучения (всей эпохи). Для каждой эпохи функция стоимости определялась как среднеквадратическая ошибка, представленная в составной форме:
Eav (n) |
1 |
N |
e2j (n), |
(2.65) |
|
||||
|
2N n 1 |
j C |
|
|
где сигнал ошибки ej (n) соответствует нейрону j для примера обучения n. Ошибка ej (n) равна разности между dj(n) и уj(n) для j-гo элемента вектора желаемых откликов d(n) и соответствующего выходного нейрона сети. В выражении (2.65) внутреннее суммирование по j выполняется по всем нейронам выходного слоя сети, в то время как внешнее суммирование по п выполняется по всем образам данной эпохи. При заданном параметре скорости обучения
корректировка, применяемая к синаптическому весу wji ,связывающему нейроны i и j, определялась следующим дельта-правилом:
|
Eav |
|
|
N |
ej (n) |
|
|
wji (n) |
wji |
|
N |
n 1 ej (n) |
|
. |
(2.66) |
wji |
Согласно (2.66), в пакетном режиме корректировка веса wji (n) выпол-
няется только после прохождения по сети всего множества примеров. Процесс комбинирования данных режимов обучения состоял в следую-
щем. В случае наличия избыточных данных использовался последовательный режим обучения. Его применение позволяло использовать меньший объем внутреннего хранилища для каждой синаптической связи. Более того, путем предъявления обучающих примеров в случайном порядке (в процессе последовательной корректировки весов) достигался стохастический поиск в пространстве весов. Это, в свою очередь, сокращало до минимума возможность остановки алгоритма в точках локальных минимумов. Во всех остальных случаях использовался пакетный режим обучения. Он обеспечивал более точную оценку вектора градиента при «обедненных» данных и позволял распараллелить вычисления.
Для обоснования критерия прекращения (останова) обучения рассматривались уникальные свойства локального и глобального минимумов поверхности ошибок. Обозначим символом w вектор весов, обеспечивающий минимум, будь то локальный или глобальный. Необходимым условием минимума является достижение вектора градиента g(w) (т.е. вектора частных производных первого порядка) для поверхности ошибок в точке нулевых значений. На практике это означает, что алгоритм обратного распространения ошибок сошелся, если
122
Евклидова норма вектора градиента достигла достаточно малых значений. Недостатком этого критерия сходимости является то, что для сходимости обучения может потребоваться довольно много времени. Кроме того, необходимо постоянно вычислять вектор градиента g(w). Другим уникальным свойством минимума является то, что функция стоимости (или мера ошибки) Eav (w) в точке w = w* стабилизируется. Отсюда можно вывести еще один критерий сходимости. Критерием сходимости алгоритма обратного распространения ошибок является достаточно малая абсолютная интенсивность изменений среднеквадратической ошибки в течение эпохи. Практические результаты показали, что интенсивность изменения среднеквадратической ошибки можно считать достаточно малой, если она лежит в пределах от 0,1-1 % за эпоху. В процессе функционирования алгоритма обратного распространения ошибок использовался еще один критерий сходимости. После каждой итерации обучения сеть тестировалась на эффективность обобщения. Процесс обучения останавливался, когда эффективность обобщения становилась удовлетворительной или когда оказывалось, что пик эффективности уже пройден.
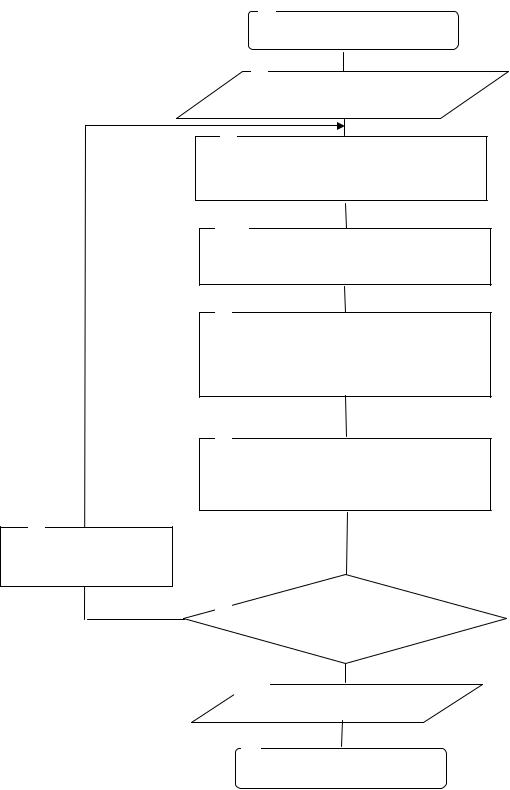
Блок-схема алгоритма обратного распространения ошибок представлена на рис. 2.33.
Блоки 1,10 используются для пуска и остановки алгоритма обратного распространения ошибок.
В блоке 2 реализован ввод исходных данных, таких как:
-элементы обучающей выборки (как правило они должны быть нормализованы);
-значения весов (начальные значения весов могут быть случайными или детерминированными);
-вектор выходных значений сигналов.
Блок 3 обеспечивает расчет выходного сигнала.
В блоке 4 рассчитывается значение среднеквадратичной ошибки.
Блок 5 реализует определение производных сложной функции (сигнала и функции активации).
В блоке 6 фиксируется значение производной.
Блок 7 обеспечивает проверку изменения знака производной. Если он не изменился, то управление передается в блок 9. В противном случае управление передается в блок 8.
Блок 9 вывод результатов. В качестве результатов выступает набор весовых коэффициентов при которых достигается значение минимума функции ошибки.
Ниже приведен фрагмент программного кода, реализующий алгоритм обратного распространения ошибок:
procedure TNSet.MTeach; var
i, //слой
123
1
Начало
2
Ввод исходных данных
3
Определение
выходного
сигнала
4
Определение функционала квадра-
тичной ошибки
5
Определение производных сигналов ошибок обратного распространения
6
Фиксация знака производной
8
Генерация прира-
щений весов
Нет
7Определениеизме-
нения знака производной
Да
9
Вывод результатов
10
Конец
Рис. 2.33. Блок-схема алгоритма обратного распространения ошибок
124
j, //нейрон k:Integer; // вход xsum:Double; begin
//формирование массива ошибок // расчет фактических ошибок нейронов выходного слоя
for j:=1 to fConfig[LayerCount-1] do Osh[LayerCount-1,j]:=(outputm[LayerCount-1,j]-
inputm[LayerCount,j])*Posh[LayerCount-1,j]; //расчет суммарной ошибки
xsum:=0;
for j:=1 to fConfig[LayerCount-1] do xsum:=xsum+Osh[LayerCount-1,j]; Sosh:=xsum/fConfig[LayerCount-1];
//расчет фактических ошибок нейронов скрытых слоев приращений весов и новых весов
//начинаем от предпоследнего (последний скрытый) до 1-го for i:=LayerCount-2 downto 1 do
for j:=1 to fConfig[i] do begin
xsum:=0;
for k:=0 to fConfig[i+1] do xsum:=xsum+Osh[i+1,j]*w[i,j,k]; Osh[i,j]:=xsum*Posh[i,j];
//Osh[i,j]:=xsum*outputm[i,j]*(1-outputm[i,j]);
//находим приращение веса и новое значение веса
for k:=0 to fConfig[i+1] do begin
//WT[i,j,k]:=-Osh[i+1,j]*fMiu*outputm[i,j]; WT[i,j,k]:=-Osh[i+1,j]*fTS*outputm[i,j]+fMiu*WT[i,j,k];
w[i,j,k]:=w[i,j,k]+WT[i,j,k];
end;
end;
end;
Модуль «Алгоритм имитации отжига» реализует одноименный алгоритм в интересах оптимизации поиска глобального экстремума целевой функции. Метод имитации отжига представляет собой алгоритмический аналог физического процесса управляемого охлаждения. Предложенный Н. Метрополисом в 1953 г. [57] и доработанный многочисленными последователями, он в настоящее время считается одним из немногих алгоритмов, позволяющих оперативно находить глобальный минимум функции нескольких переменных. Метод ими-
125