Материал: Модели и алгоритмы проектирования и разработки систем поддержки принятия инвестиционных решений. Морозов В.П., Баркалов С.А
Блоки 1,12 используются для пуска и остановки процесса распределения финансовых инвестиций.
Вблоке 2 реализован ввод исходных данных, таких как: количество инвестируемых проектов, общий объем инвестиций; диапазон изменений инвестиций для различных проектов.
Вблоке 3 формируются множества начальных популяций, каждая из которых состоит из N индивидуумов (по количеству проектов). Данные популяции формируются случайным образом.
С помощью блока 4 производится расчет приспособленности каждого индивидуума (доходность каждого варианта) и популяции в целом (доходность всех вариантов).
Вблоке 5 реализован выбор индивидуумов для скрещивания. Важную роль в организации данного процесса играет модель отбора индивидуумов. Она определяет, каким образом следует строить популяцию следующего поколения. От качества такой модели зависит эффективность (точность и оперативность) генетического алгоритма. В данном алгоритме использована элитарная модель отбора [59]. Использование данной модели позволило ускорить сходимость генетического алгоритма (более оперативно достигнуть экстремума).
Вблоках 6,7 реализованы процедуры скрещивания, мутации и инверсии. Блок 8 реализует формирование новой популяции путем циклического
добавления новых индивидуумов (вариантов инвестирования) в имеющуюся популяцию.
Блок 9 обеспечивает определение максимального значения целевой функции. В случае достижения глобального максимума (максимальной прибыли инвестора) управление передается блоку 10. В противном случае управление передается в блок 4 и осуществляется дальнейшее последовательное выполнение процедур, реализуемых блоками 5,6,7,8.
В блоке 10 раскрывается описание реквизитов лучшего индивидуума во всей популяции.
Блок 11 обеспечивает вывод полученных результатов (рациональный вариант распределения инвестиций по проектам и соответствующее значение прибыли инвестора).
Результаты апробации ГА для настройки ИНС приведены в разделе 2.4.2. Анализ полученных результатов показал его более высокую точность по сравнению с алгоритмом имитации отжига, но более низкую оперативность. Для повышения оперативности ГА подвергся 2-этапной процедуре модификации.
Суть первого этапа модификации ранее уже апробировалась [123] и заключалась вследующем.
Рассмотрим постановку решаемой задачи (оптимизацию портфеля инвестиционных проектов) в свете классической задачи о рюкзаке [183].
Имеется рюкзак, который способен выдержать вес, ограниченный некоторой константой P. Существует N предметов, каждый из которых имеет опре-
156
деленный вес pi и стоимость si. Необходимо в рюкзак положить такую совокупностьпредметов m, m N, чтобы их суммарный вес Pm не превысилконстанту
P (Pm P ), а суммарная стоимость этих предметов Sm была максимальной
Sm max.
Обычно данную задачу решают методами прямого перебора и ветвей и границ. Эти методы просты и практически всегда дают точное решение. Их основными недостатками является экспоненциальная сложность заложенных алгоритмов и, соответственно, высокая ресурсоемкость, предъявляемая к вычислительным средствам.
Специфика модифицированного генетического алгоритма (МГА), реализующего данную задачу, состояла в следующем.
Кодирование решений реализовывалось следующим образом. Значение j-го гена хромосомы, где j = 1, 2 .. k, равно единице, если i-й предмет положили в рюкзак, и равно нулю, если предмет не положили.
Учитывалось, что ввиду существующего ограничения P (вместимости рюкзака) не всякая комбинация нулей и единиц в векторе длины n можетдавать допустимое решение. Комбинация предметов, соответствующая произвольно заданной хромосоме, может превысить допустимый вес. Решалась данная проблема следующим образом. Сначала использовались стандартные операторы одноточечного или равномерного кроссовера, а затем полученная хромосома преобразовывалась в допустимую путем замены в ней некоторых случайно выбранных единиц нулями.
Функция пригодности определяла степень выживаемости индивидуума в популяции. Чем больше значение функции пригодности индивидуума, тем ближе соответствующее ей решение к точному решению задачи о рюкзаке. В качестве функции пригодности конкретного индивидуума использовалась суммарная стоимость предметов, положенных в рюкзак.
Классический метод ветвей и границ, лежащий в основе построения деревьев и оценки перспективности их вершин, нашел своё развитие. Развитие заключалось в том, что строилось не всё дерево решений, а лишь его перспективные поддеревья (первое отличие). Отправной точкой построения поддерева являлась вершина, соответствующая решению, полученному в результате работы ГА. Далее достраивались вышестоящие вершины, которые после проведения соответствующих оценок в свою очередь становились корневыми вершинами для новых поддеревьев. Другими словами, использовалась стратегия «снизувверх», в отличие от стратегии классического метода ветвей и границ «сверху - вниз» (второе отличие). Полученная высота построенного дерева (совокупности поддеревьев) получила название «уровень приближения» и была принята в качестве числового параметра разработанного ГА. Данный параметр определяет протяженность области определения целевой функции, координаты центра которой (области) определены с использованием ГА. В результате проведенных
157
экспериментов было установлено, что точность ГА прямо пропорционально зависит от заданного значения уровня приближения, а зависимость быстродействия носит обратный характер.
Для апробации разработанного ГА и сравнения его характеристик с параметрами существующих ГА была реализована клиент-серверная программная система, предоставляющая пользователю следующие возможности:
- проводить загрузку пяти ГА (canonical, simple, genitor, island, МГА)
[164];
-устанавливать параметры ГА (объем популяции, генетические операторы, количество итераций и т.д.), а также изменять эти параметры в ходе работы программы;
-хронометрировать временные режимы работы ГА;
-выводить результаты сравнения ГА в табличной и графической формах. Генетическими алгоритмами обрабатывались популяции размерами 50,
100, 500, 1000, 5000 и 10000 индивидуумов. Для сравнения точности ( ,%) ра-
боты ГА на начальном этапе данная задача решалась классическим методом ветвей и границ. Результат её решения использовался в качестве эталонного (100 %). Результаты сравнительного анализа точности и оперативности (T,c) работы пяти ГА и модифицированногоГА приведены в табл. 2.15.
Таблица 2.15 Результаты сравнительного анализа функционирования ГА
N |
Вид ГА |
|
|
|
Число индивидуумов в популяции |
|
|
|
|||||
50 |
|
100 |
|
500 |
|
1000 |
|
5000 |
|
10000 |
|||
п/ |
|
,% |
T,c ,% T,c |
,% T,c |
,% T,c |
,% T,c |
,% T,c |
||||||
п |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
1 |
Сanonical |
88 |
0,01 |
90 |
0,09 |
92 |
0,11 |
94 |
0,15 |
97 |
0,2 |
99 |
0,25 |
2 |
Simple |
70 |
0,31 |
78 |
0,33 |
82 |
0,38 |
86 |
0,41 |
93 |
0,5 |
95 |
0,58 |
3 |
Genitor |
72 |
0,001575 |
0,001977 |
0,002581 |
0,03 |
88 |
0,12 |
90 |
0,28 |
|||
4 |
Island |
80 |
0,29 |
84 |
0,33 |
88 |
0,47 |
91 |
0,77 |
94 |
0,89 |
96 |
1,65 |
5 |
МГА |
95 |
0,23 |
99 |
0,29 |
100 |
0,39 |
100 |
0,69 |
100 |
0,82 |
100 |
1,04 |
Результаты вычислительных экспериментов показали, что наиболее оперативными оказались алгоритмы Genitor и Canonical, им уступают Island и Simple. МГА по быстродействию занимает промежуточное положение. По точности исследованные алгоритмы распределились следующим образом: МГА –
99 %; Canonical – 93 %; Island – 89 %; Simple – 84 %; Genitor – 81 %. Наиболее точным оказался МГА.
Установлено, что с увеличением количества индивидуумов в популяциях точность решения задачи увеличивается, а оперативность проведения расчетов падает. Проведенные эксперименты позволили выделить МГА как наиболее рациональный по скорости и точности.
Второй этап модификации МГА состоял в применении островной модели параллельных вычислений.
158
2.6.1. Островная модель параллельных вычислений
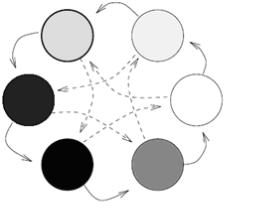
Выбор данной модели обусловлен ее распространенностью и простотой реализации. Ее суть заключается в том, что популяция разбивается на одинаковые по размеру подпопуляции. Каждая подпопуляция обрабатывается отдельным процессором с помощью одной из разновидностей непараллельного ГА. Периодически, через пять поколений, подпопуляции обмениваются несколькими особями. Подобные миграции позволяют подпопуляциям совместно использовать генетический материал. В схематичном виде данный процесс представ-
лен нарис. 2.59 [139].
Рис. 2.59. Схема работы островного генетического алгоритма
Особенности механизма функционирования данной модели рассмотрим на следующем примере. Пусть выполняются 16 независимых генетических алгоритмов с использованием подпопуляции из 1000 особей на каждом процессоре. Если миграций нет, то происходит 16 независимых поисков решения. Все поиски ведутся на различных начальных популяциях и сходятся к определенным особям. Исследования подтверждают, что генетический дрейф склонен приводить подпопуляции к различным доминирующим особям. Это связано с тем, что, вопервых, количество островов, принимающих доминирующих «эмигрантов» с острова, ограничено (2-5 островов). Во-вторых, обмен особями односторонен. Поэтому в большой популяции появятся группы островов с различными доминирующими особями. Если популяция небольшого размера, то возможно быстрое мигрирование ложных доминирующих особей. Например, истинное решение находится только на одном острове, а несколько ложных доминант – на других островах. Тогда при миграции количество ложных особей на островах возрастет (на каждый остров миграции происходят с не менее 2 островов), генетическим алгоритмом верное решение будет разрушено. Тем самым в маленькой популяции при генетическом дрейфе возможно появление ошибочных доминирующих особей и схождение алгоритма к ложномуоптимуму.
Введение миграций в островной модели позволяет находить различные
159
особи - доминанты в подпопуляциях, что способствует поддержанию многообразия в популяции. Каждую подпопуляцию можно принять за остров. Во время миграции подпопуляции обмениваются своим доминирующим генетическим материалом. При частом мигрировании большого количества особей происходит перемешивание генетического материала. Тем самым устраняются локальные различия между островами. Очень редкие миграции не позволяют предотвратить преждевременную сходимость алгоритма в маленьких подпопуляциях. В рассматриваемой модели с каждого острова миграции могут происходить лишь на определенное расстояние: 2-5 острова в зависимости от количества подпопуляции. Таким образом, каждый остров оказывается почти изолированным. Количество островов, на которые могут мигрировать особи одной подпопуляции, называют расстоянием изоляции. Следует заметить, что взаимомиграции исключены. Все приведенные варианты ГА в работе моделировались для различных значений параметров ГА.
Данная модель генетического алгоритма обладает следующими свойст-
вами:
-наличие нескольких популяций фиксированного размера;
-фиксированная разрядность генов;
-комбинирование стратегий отбора и формирования следующего поколения в каждой популяции;
-отсутствие ограничений на тип кроссовера и мутации;
-реализация обмена особями между "островами" случайным образом. Блок–схема ГА оптимизации инвестиций, реализующего островную мо-
дель параллельных вычислений, приведена на рис. 2.60. Функциональное назначение его блоков аналогично алгоритму, представленному на рис. 2.58. Особенность данного алгоритма состояла в том, что каждая подпопуляция обрабатывалась (блоки 3,4,5,6,7,8,9) на отдельном процессоре (данные блоки в приведенном алгоритме выделены двойными линиями). Между подпопуляциями осуществлялся обмен (1 раз в итерацию общего цикла) индивидуумами посредством миграции. В результате отыскивается лучший индивидуум во всей популяции [34].
В процессе обработки информации выделялись две группы операций:
-локальные операции, независимо выполняемые на каждом процессоре, в частности: расчет значений функций приспособленности для каждого индивидуума; выбор индивидуумов; скрещивание; мутации; формирование родительских пар;
-глобальные операции – обмен индивидуумами между процессорами, в частности операции коммуникации и синхронизации.
С целью апробации данного алгоритма в среде Delphi была разработана
специальная программа, реализующая интерфейс пользователя, комплекс процедур, описанных выше, и набор инструментальных средств, используемых в интересах получения и анализа его (алгоритма) динамических свойств.
160