Материал: Нейронные модели обнаружения вторжений и атак на компьютерные сети. Остапенко Г.А., Радько Н.М
3.4.3. Обучающий алгоритм обратного распространения
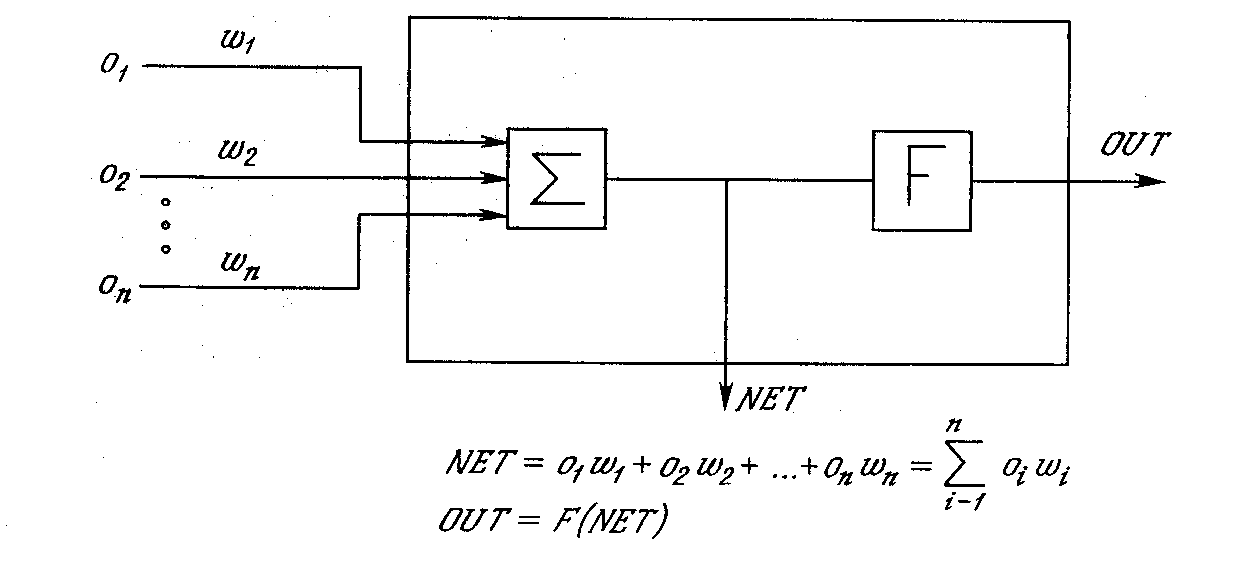
Рис. 3.13. Искусственный нейрон с активационнной функцией
На рис. 3.13 показан нейрон, используемый в качестве основного строительного блока в сетях обратного распространения. Подается множество входов, идущих либо извне, либо от предшествующего слоя. Каждый из них умножается на вес, и произведения суммируются. Эта сумма, обозначаемая NET, должна быть вычислена для каждого нейрона сети. После того, как величина NET вычислена, она модифицируется с помощью активационной функции и получается сигнал OUT [85].
На рис. 3.14 показана активационная функция, обычно используемая для обратного распространения
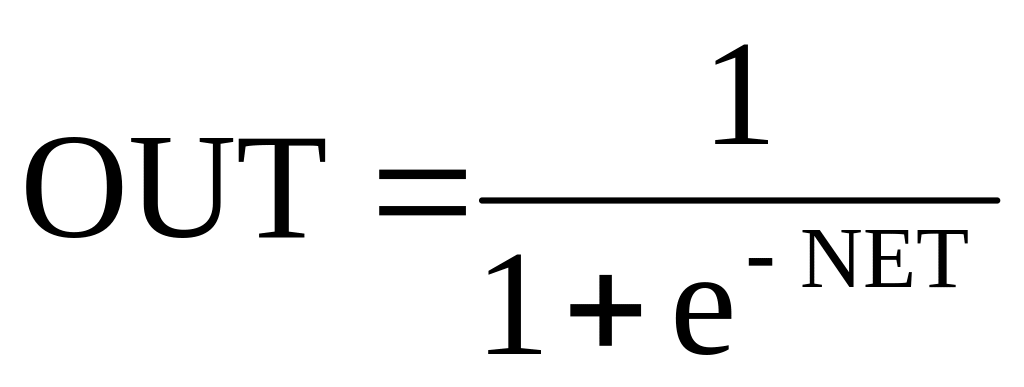 .
(3.5)
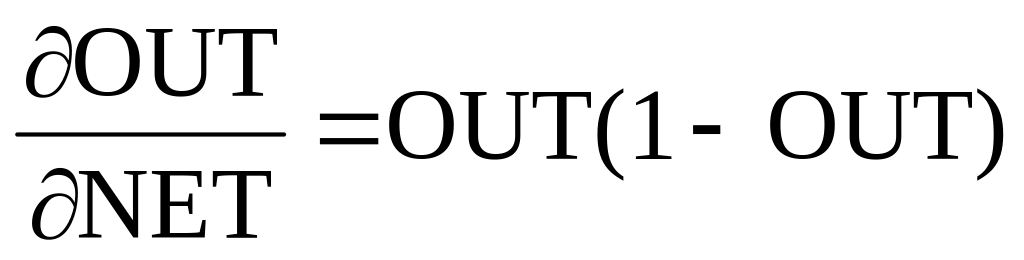 .
(3.6)
Как показывает уравнение (3.6), эта функция, называемая сигмоидом, весьма удобна, так как имеет простую производную, что используется при реализации алгоритма обратного распространения [75].
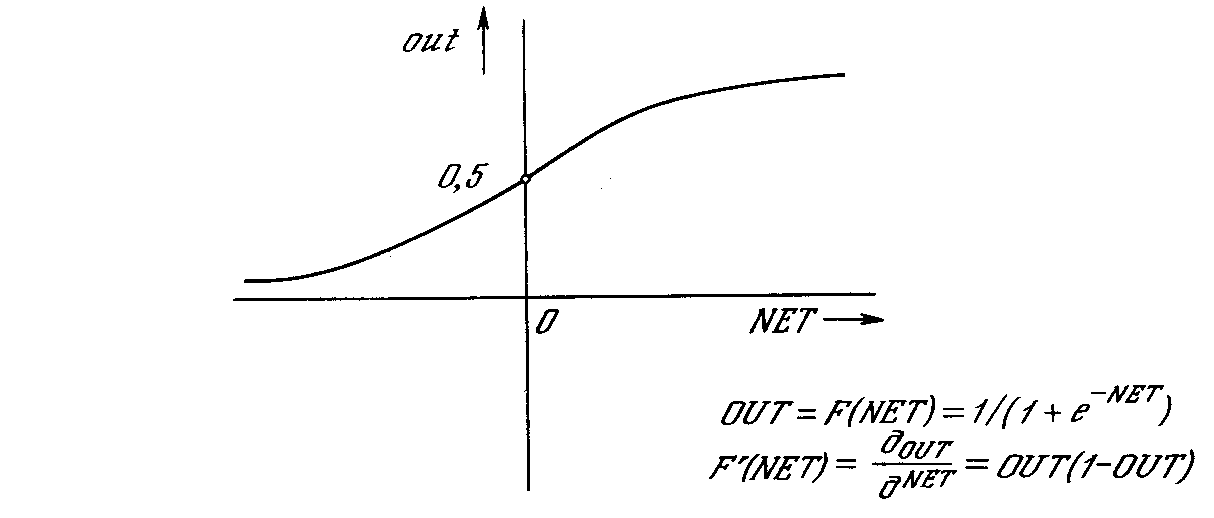
Рис. 3.14. Сигмоидальная активационная функция
Сигмоид, который иногда называется также логистической, или сжимающей функцией, сужает диапазон изменения NET так, что значение OUT лежит между нулем и единицей. Как указывалось выше, многослойные нейронные сети обладают большей представляющей мощностью, чем однослойные, только в случае присутствия нелинейности. Сжимающая функция обеспечивает требуемую нелинейность [76].
В действительности имеется множество функций, которые могли бы быть использованы. Для алгоритма обратного распространения требуется лишь, чтобы функция была всюду дифференцируема [78]. Сигмоид удовлетворяет этому требованию. Его дополнительное преимущество состоит в автоматическом контроле усиления. Для слабых сигналов (величина NET близка к нулю) кривая вход-выход имеет сильный наклон, дающий большое усиление. Когда величина сигнала становится больше, усиление падает. Таким образом, большие сигналы воспринимаются сетью без насыщения, а слабые сигналы проходят по сети без чрезмерного ослабления.
На рис. 3.15 изображена многослойная сеть, которая может обучаться с помощью процедуры обратного распространения. (Для ясности рисунок упрощен.) Первый слой нейронов (соединенный с входами) служит лишь в качестве распределительных точек, суммирования входов здесь не производится. Входной сигнал просто проходит через них к весам на их выходах. А каждый нейрон последующих слоев выдает сигналы NET и OUT, как описано выше.
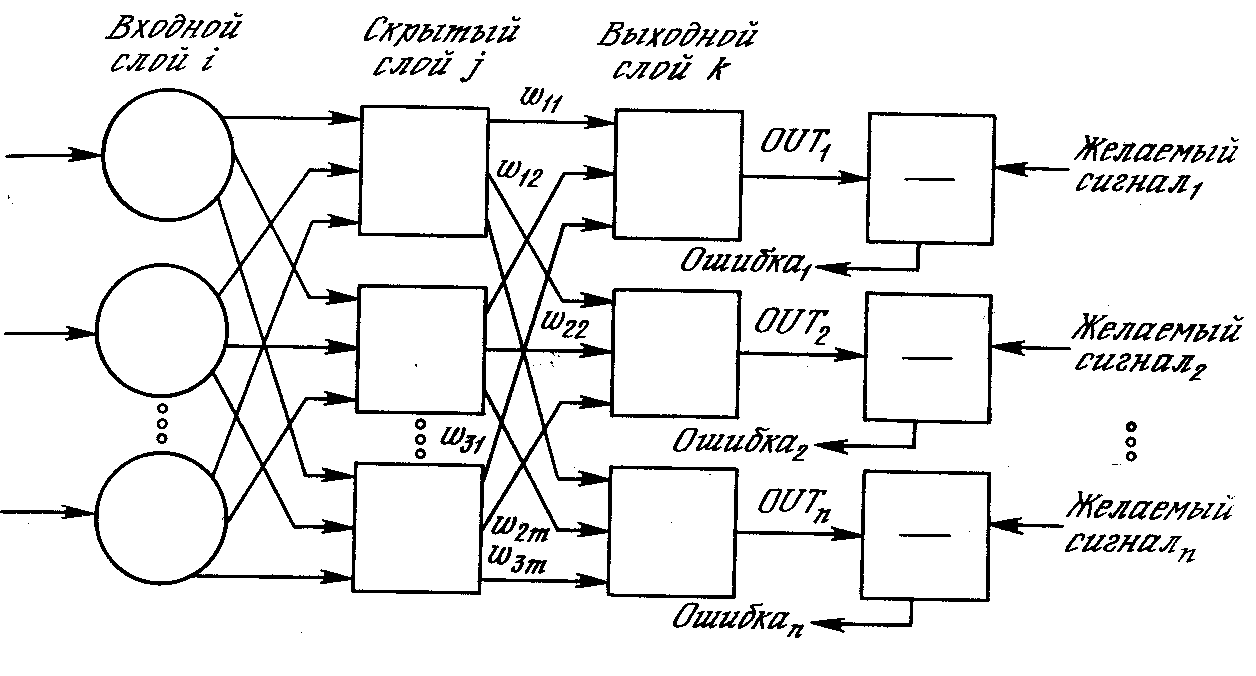
Рис. 3.15. Двухслойная сеть обратного распространения ( – желаемый сигнал)
Процедура обратного распространения применима к сетям с любым числом слоев [81]. Однако для того, чтобы продемонстрировать алгоритм, достаточно двух слоев. Сейчас будут рассматриваться лишь сети прямого действия, хотя обратное распространение применимо и к сетям с обратными связями.
3.4.4. Алгоритм обучения искусственной нейронной сети
Целью обучения сети является такая подстройка ее весов, чтобы приложение некоторого множества входов приводило к требуемому множеству выходов. Для краткости эти множества входов и выходов будут называться векторами. При обучении предполагается, что для каждого входного вектора существует парный ему целевой вектор, задающий требуемый выход [79]. Вместе они называются обучающей парой. Как правило, сеть обучается на многих парах.
Алгоритм обратного распространения ошибок опирается на обобщение дельта-правила [82]. Представим производную ошибки в виде:
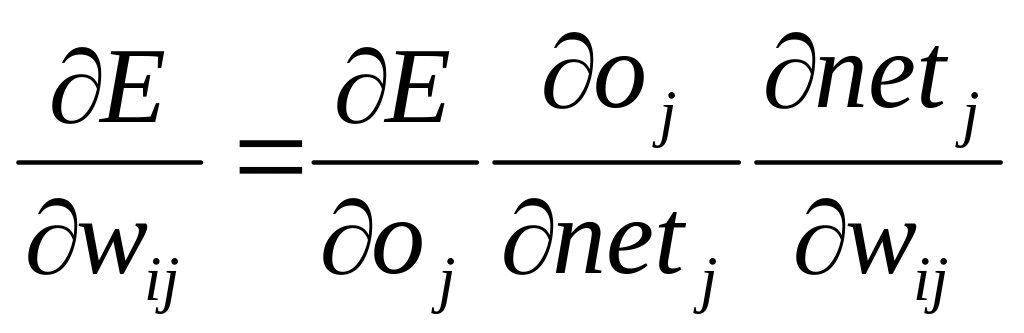 ,
где E – сумма квадратов ошибок для сети, - наблюдаемый выход элемента.
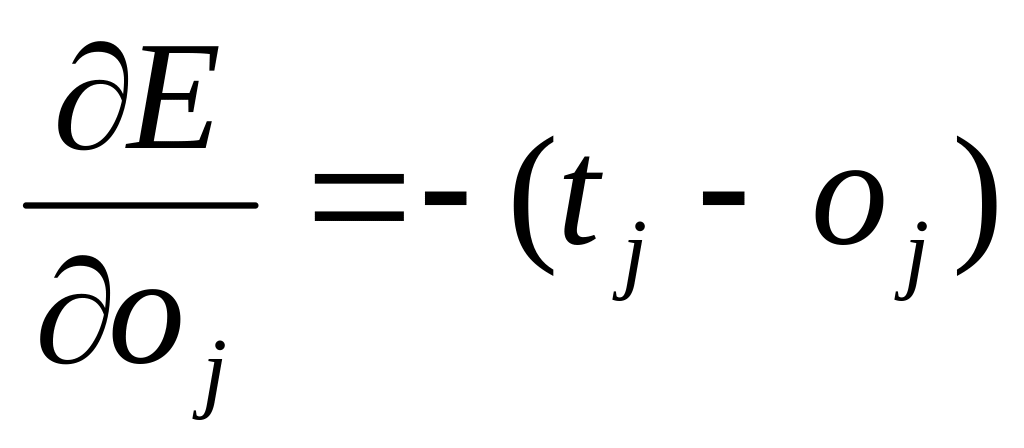 ,
следует из 3.1 .
Для функции активности выходом является то есть:
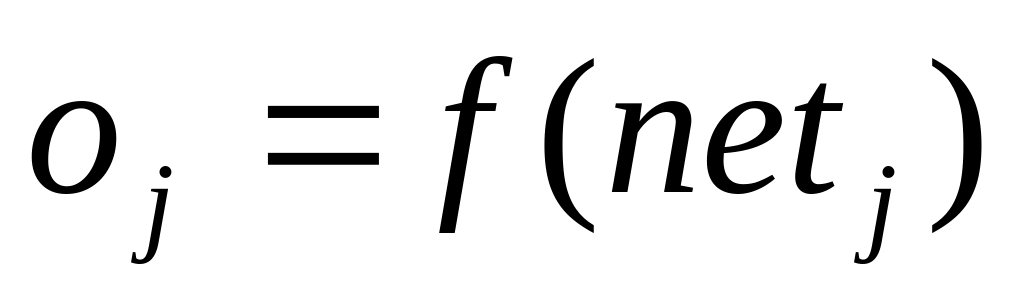 ,
а для производной f получим:
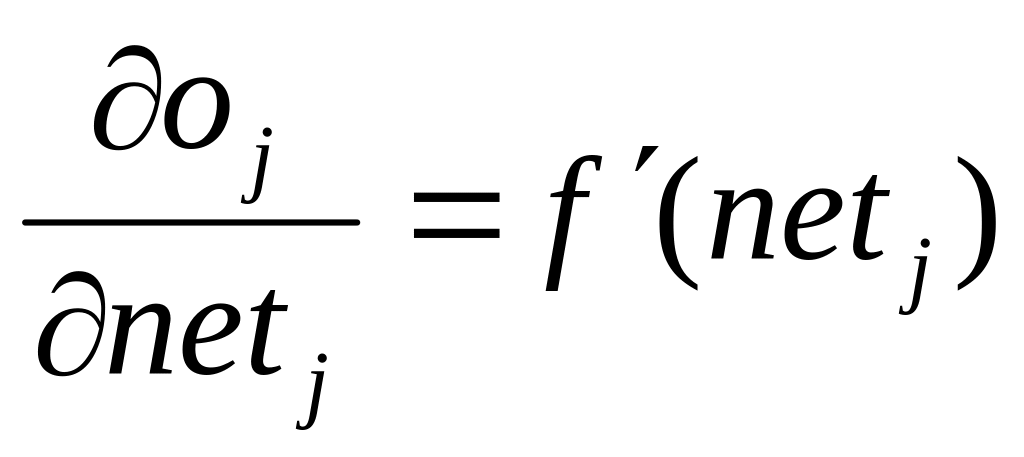 .
Исходя из этого, и принимая во внимание, что
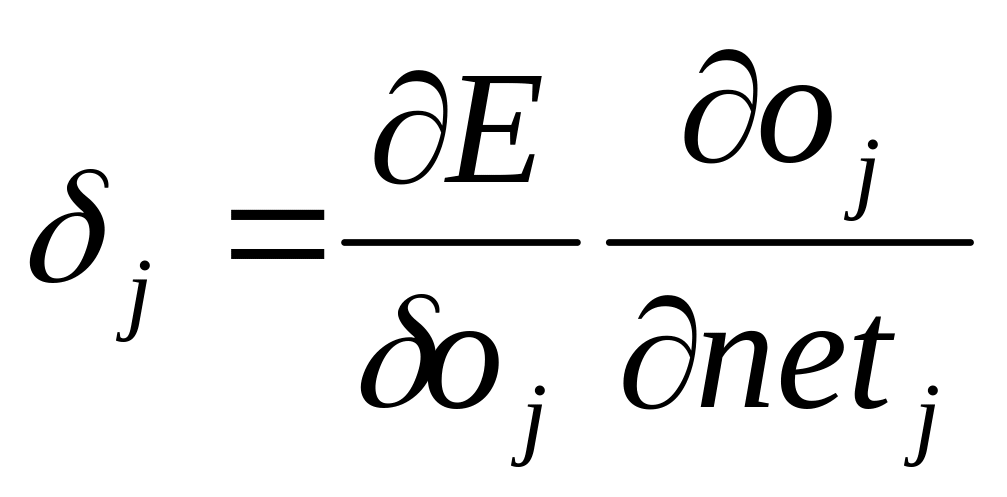 ,
получим:
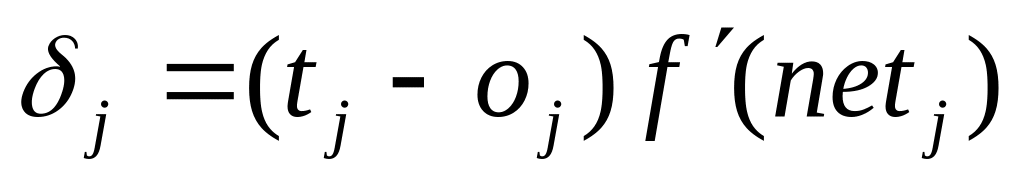 .
Указанная ошибка
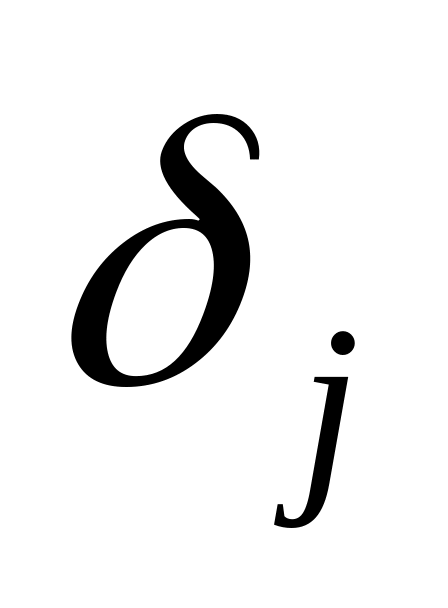 соответствует
ошибке выходного элемента, но ошибка
скрытого элемента не связана с целевым
выходным значением непосредственно
[77]. Поэтому весовые значения скрытого
элемента следует скорректировать
пропорционально его «вкладу» в величину
ошибки следующего слоя. Для скрытого
элемента величина ошибки вычисляется
по формуле:
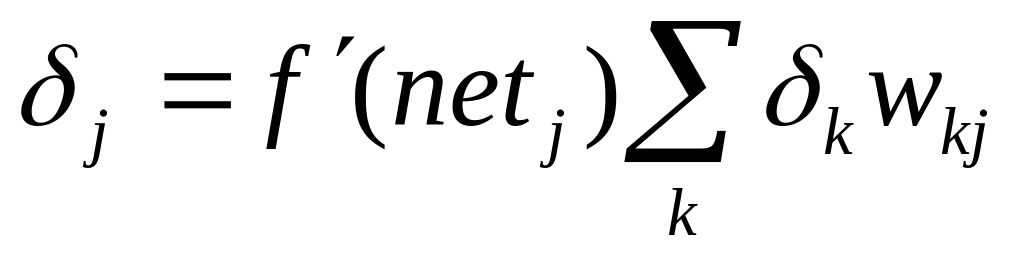 ,
где индекс k соответствует слою, посылающему ошибку обратно.
На первой стадии происходит инициализация весов малыми значениями, например, из диапазона -0,3 и +0,3. Обучение предполагается управляемым, поскольку с каждым входным образцом связывается целевой выходной образец. Обучение продолжается до тех пор, пока изменение усредненной квадратичной ошибки не окажется меньше некоторого допустимого значения при переходе от одной эпохи к следующей [32]. Если в процессе обучения наступает момент, когда ошибка в сети попадает в рамки допустимого изменения, говорят, что наблюдается сходимость. Другим критерием окончания обучения можно считать наступление момента, когда выход каждого учебного образца оказывается в рамках допустимого отклонения от соответствующего целевого выходного образца.
Чтобы уменьшить вероятность того, что
изменения весов приобретут осциллирующий
характер, вводится инерционный член
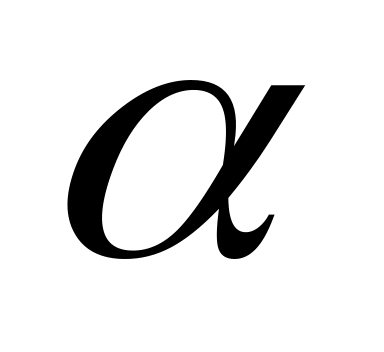 ,
добавляемый в пропорции, соответствующей
предыдущему изменению веса:
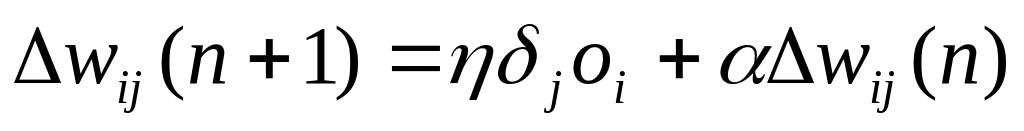 .
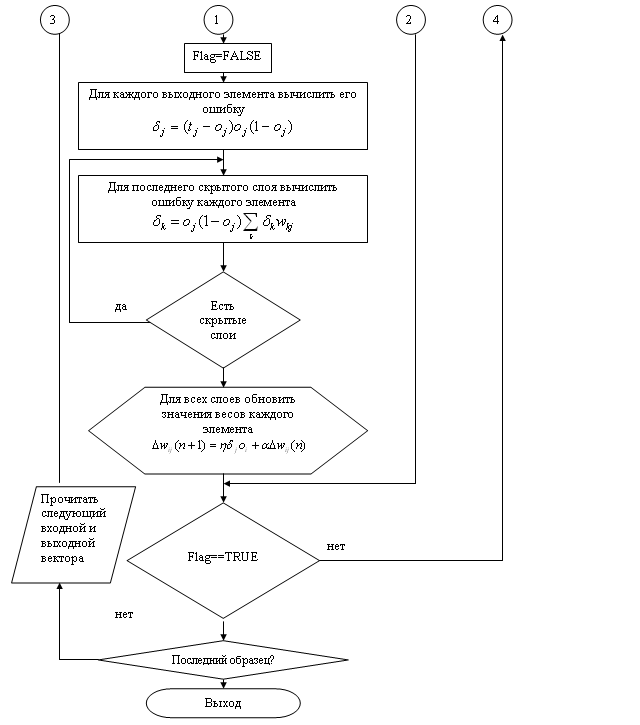
Таким образом, изменение веса на шаге n+1 оказывается зависящим от изменения веса на шаге n. Алгоритм обратного распространения в целом представлен на блок схеме (рис. 3.16).
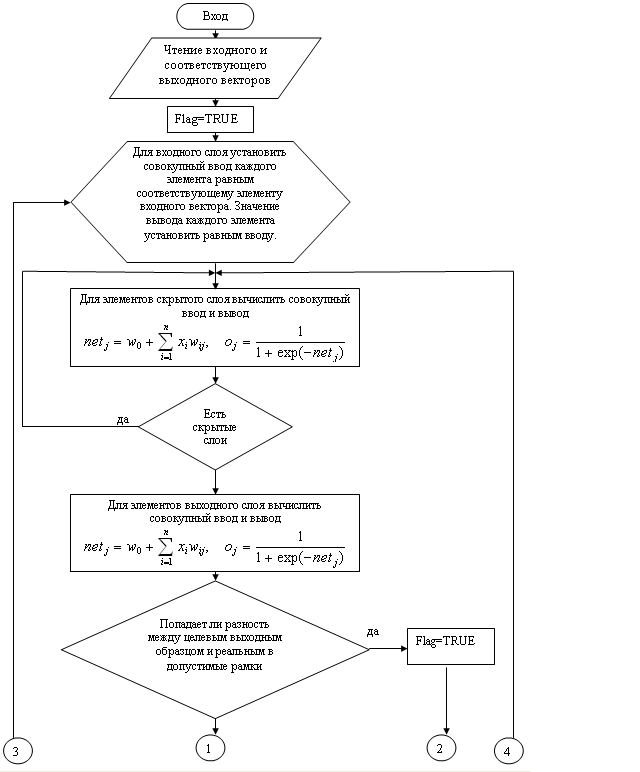
Рис. 3.16. Структурная схема алгоритма
обратного распространения ошибки
да
Flag=TRUE



Р


 ис.
3.16. Продолжение
3.5. Выбор тестового множества
На всех предыдущих этапах существенно использовалось одно предположение. А именно, обучающее, контрольное и тестовое множества должны быть репрезентативными (представительными) с точки зрения существа задачи (более того, эти множества должны быть репрезентативными каждое в отдельности). Известное изречение программистов "garbage in, garbage out" ("мусор на входе - мусор на выходе") нигде не справедливо в такой степени, как при нейросетевом моделировании. Если обучающие данные не репрезентативны, то модель, как минимум, будет не очень хорошей, а в худшем случае - бесполезной. Обычно в качестве обучающих, берутся эталонные данные [45].
В нашем исследовании, для обучения сети был взят трафик содержащий "обычные" сетевые события и несколько событий со смоделированной атакой. В качестве модели атаки, нами была использована атака на основе отказа в обслуживании (сгенерированная с помощью программы SATAN, SYNFlood ).
Репрезентативное множество, используемое для обучения сети, представлено в приложении Б.
3.6. Оценка возможности модели по обнаружению вторжения и атак
Для оценки эффективности и расчета оптимального порога срабатывания ИНС найдем функцию плотности распределения выходного значения ИНС при нормальной и аномальной активности. Для расчетов являются приемлемыми следующие предположения о том, что входное значение NET для каждого формального нейрона (ФН) имеет нормальный закон распределения. В доказательство этого утверждения входное множество было подвергнуто критерию Пирсона, для проверки гипотезы о подчинении нормальному закону распределения [87].
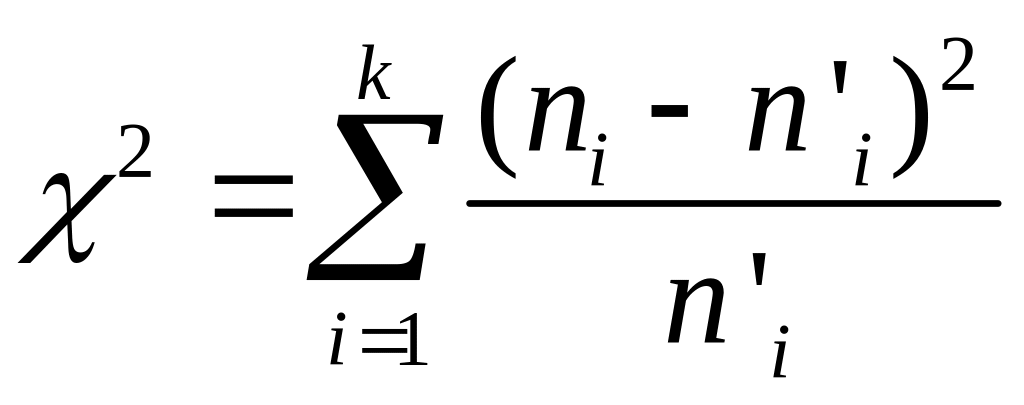 ,
где k - это число разрядов наблюдаемых значений, а n’- теоретические частоты соответствующих значений.
Далее в результате расчетов получим функцию плотности распределения выходного значения ФН выходного слоя.
Рассмотрим нейроны первого слоя ИНС.
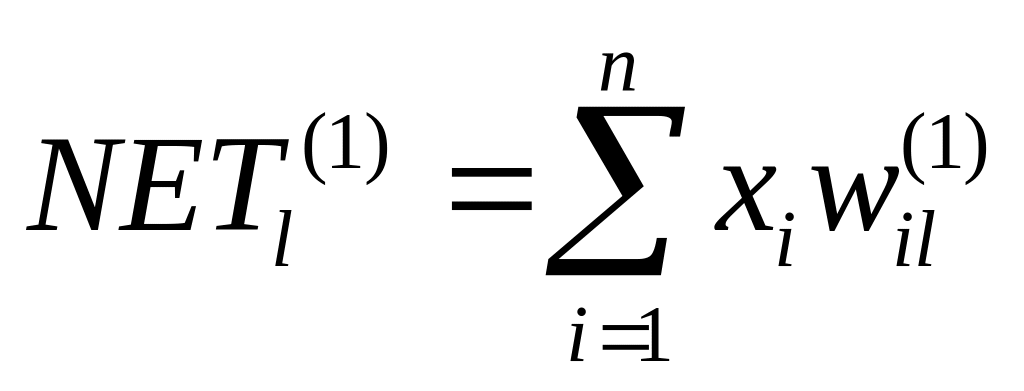 ,
где
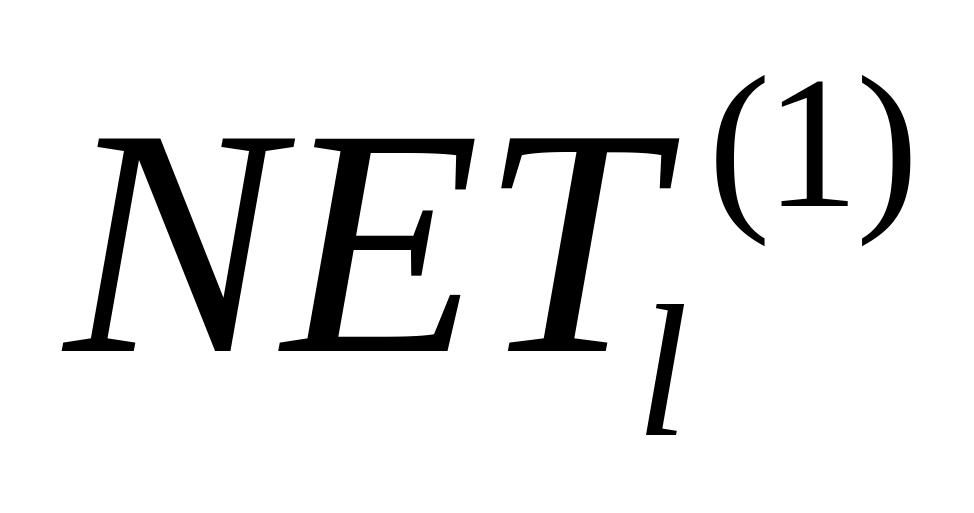 - взвешенная сумма входных сигналов для
1-ого ФН первого слоя;
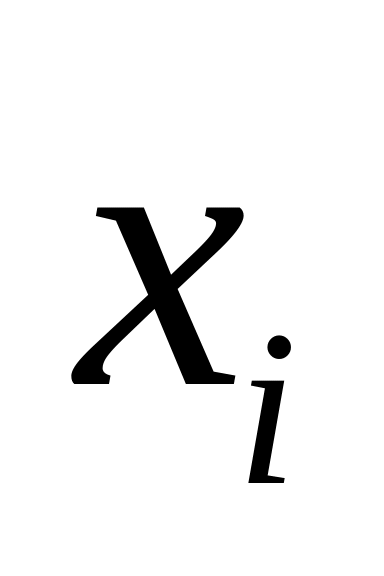 - i-я компонента входного
вектора;
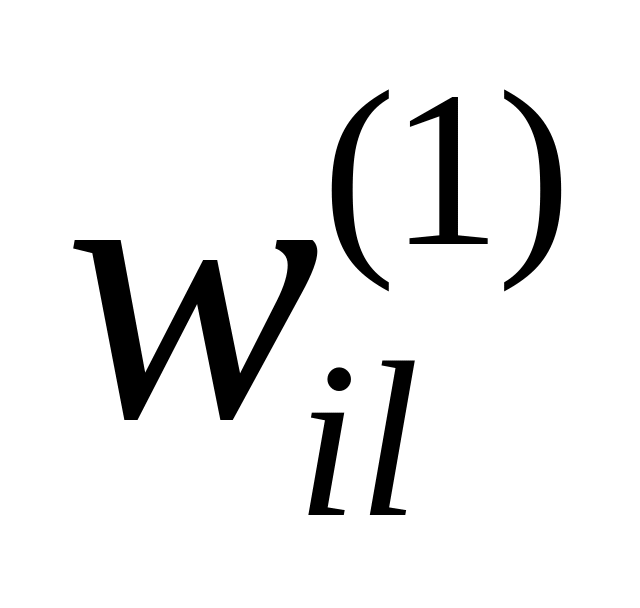 - весовой коэффициент, соответствующей
связи i-ого ФН нулевого
слоя l-ого ФН 1-ого
слоя.
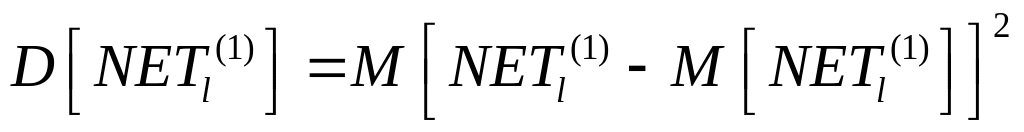
Рассчитаем математическое ожидание и дисперсию взвешенной суммы :
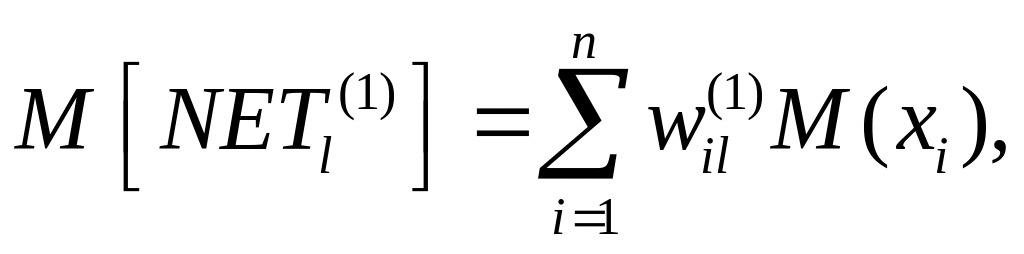
 =
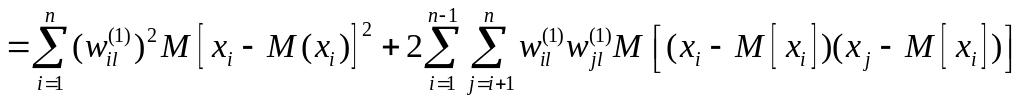 .
При этом функция распределения величины близка к нормальной как сумма большого числа достаточно слабо зависимых величин [87], то есть:
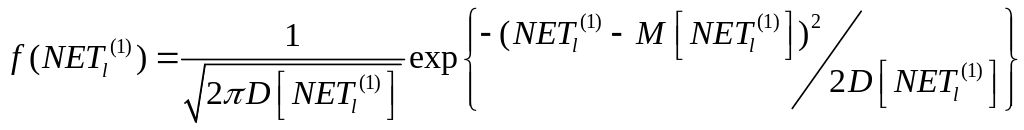
Пусть ФН имеет функцию активации
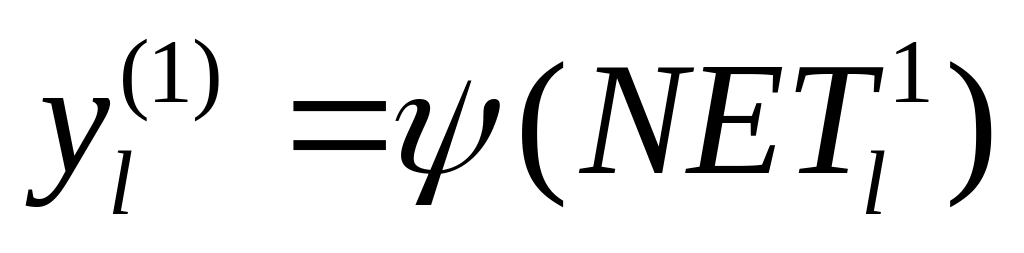 ,
где
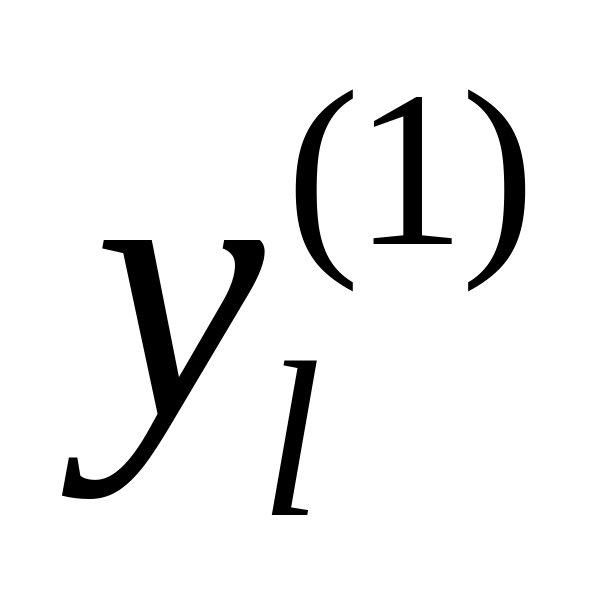 - выходное значение l-ого
ФН 1-ого слоя;
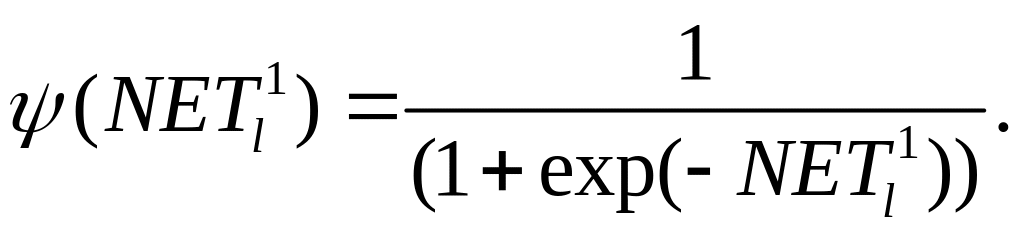
Рассчитаем математическое ожидание и дисперсию :
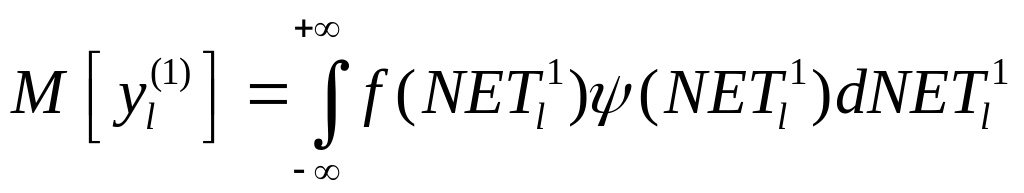 ,
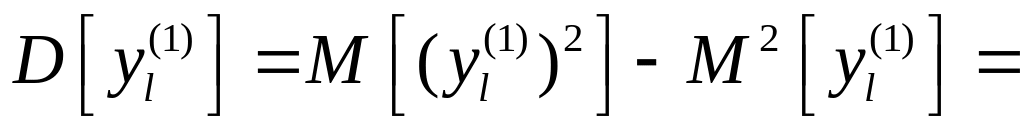
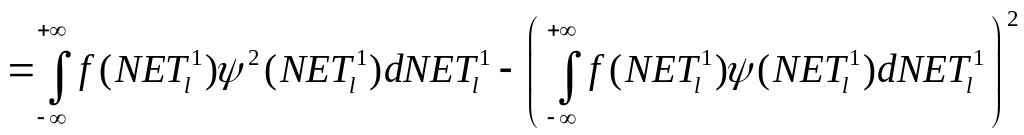 .
Величины , i=1…k, образуют входной вектор второго слоя ИНС, для которого:
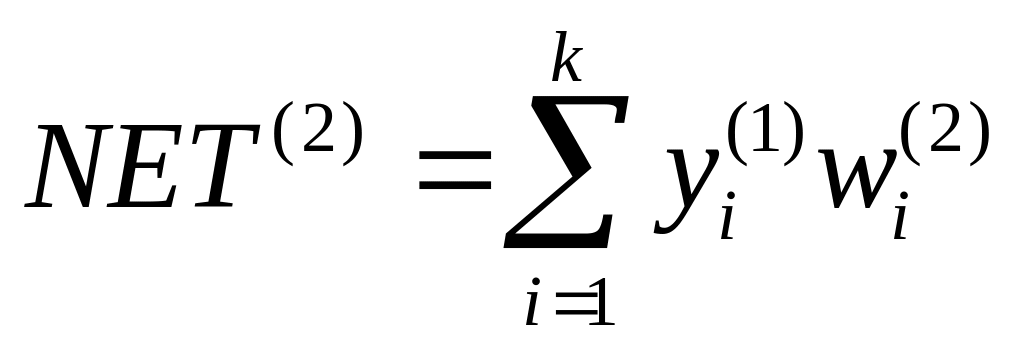 ,
где
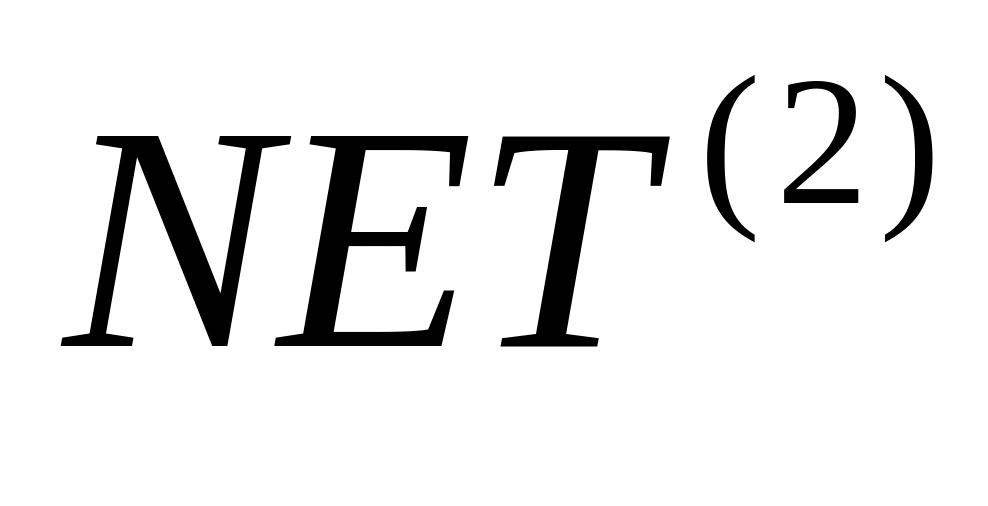 - взвешенная сумма входных ФН второго
слоя;
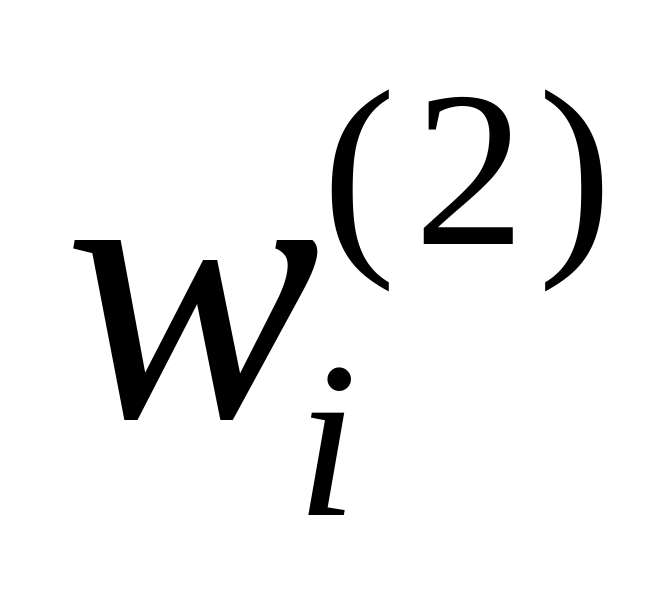 - весовой коэффициент, соответствующей
связи i-ого ФН первого
слоя и единственного ФН выходного слоя.
k – количество ФН
внутреннего слоя.
Рассчитаем математическое ожидание и дисперсию взвешенной суммы :
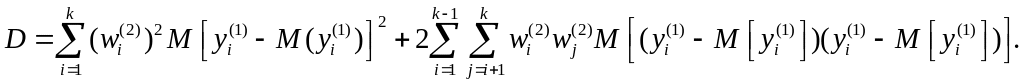
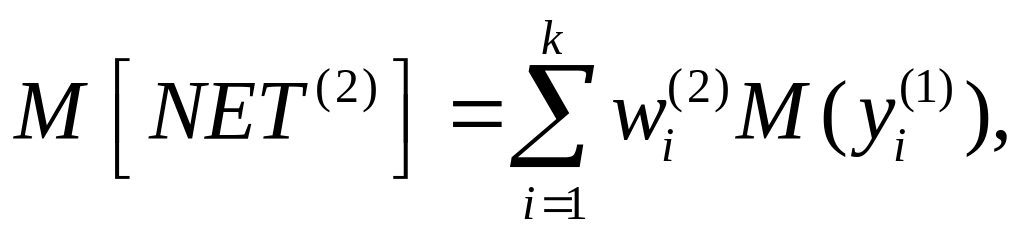
В силу слабой зависимости значений выходов внутреннего слоя ИНС, второе слагаемое в выражении для дисперсии дает малый вклад в значение дисперсии и его можно не учитывать [81], то есть получим:
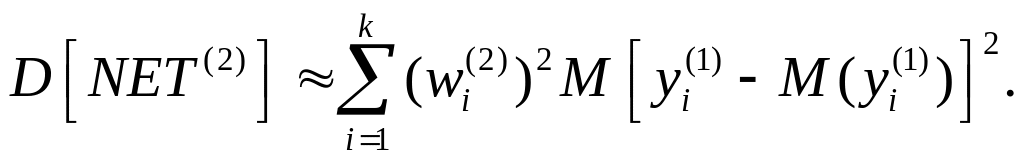
А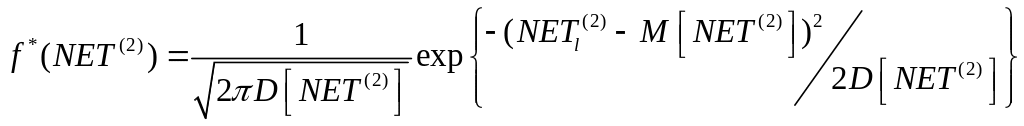 налогично
внутреннему слою:
С учетом приведенных формул можно рассчитать функцию плотности распределения выходного значения ФН выходного слоя ИНС:
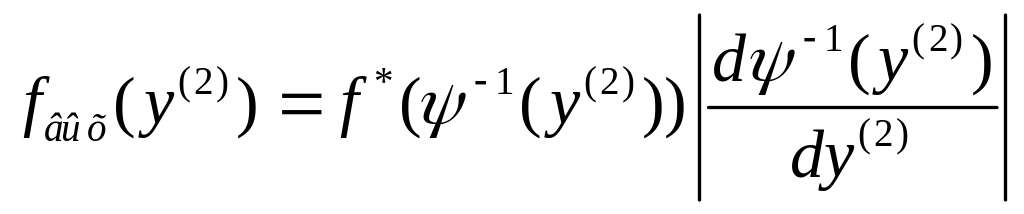 ,