Материал: Оптимизация и моделирование в автоматизированных системах
УДК 681.3
Ю.А. Асанов, С.Ю. Белецкая
АДАПТАЦИЯ RKELM ДЛЯ ПРИМЕНЕНИЯ
В НЕ ПЕРСОНИФИЦИРОВАННЫХ ПРОГРАММНО-АППАРАТНЫХ КОМПЛЕКСАХ УЧЕТА ФИЗИЧЕСКОЙ АКТИВНОСТИ
В статье предложен новый подход к использованию модели RKELM, требующий значительно меньше ресурсов при обучении и работе, и значительно превосходящий оригинальный подход при использовании пользователями, на которых модель не была натренирована.
Автоматическое распознавание движений очень важно при построении персональных рекомендаций физической активности. В ходе изучения текущих разработок в данной области, было выявлено несколько подходов, в которых используются аппаратные устройства специального назначения или системы нательных сенсоров [1]. Хотя использование многочисленных датчиков может улучшить производительность алгоритма распознавания, их использование возможно только в специальных учреждениях, обладающих соответствующим оборудованием. Целью же данной работы является разработка метода, который может применяться в повседневной жизни, соответственно возможно использование только тех устройств, которые уже вошли в жизнь каждого человека. Устройством с наиболее подходящим набором датчиков является смартфон. Данный подход имеет и недостатки, главный из которых – невозможность обучения модели под каждого пользователя, вместо этого предлагается обучение на большой выборке данных с последующим дообучением под конкретного пользователя. Именно это и является основной задачей разработанного в рамках данной работы метода.
Модель с экстремальным обучением Хуанга (RKELM Хуанга) [2] привлекла большое внимание исследователей в области DS&ML. Основное ее преимущество это выдающееся результаты в задачах обобщения, превосходящие даже результаты SVM (Support Vector Machine) [3, 4]. Но эта модель непригодна для использования на мобильных устройствах, т.к., во-первых, весовая матрица является чрезмерно объемной, особенно когда размер выборок резко увеличивается, и во-вторых, модель сложно обновить в фазе дообучения, поскольку новая обучающая выборка приводит к существенным по объему и вычислениям изменениям на всех слоях. Чтобы преодолеть эти ограничения мы предложили следующий алгоритм.
10
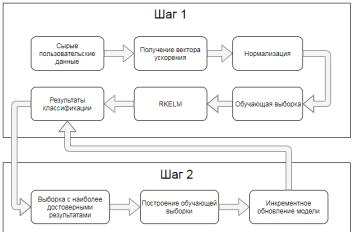
Рис. 1. Схема предложенного алгоритма
Как показано на рис. 1, алгоритм состоит из двух основных этапов: основное построение модели классификации и адаптация под нового пользователя (процесс дообучения).
На первом шаге происходит основное построение модели классификации. При построении модели классификации, в начале, полученные от датчиков скалярные данные по трем осям собираются в векторы, для того, чтобы исключить ориентационную зависимость. После чего, формируется обучающая выборка, которая подается RKELM классификатору.
На втором шаге происходит обновление модели. На основании результатов классификации получаем степень «правильности» произведенной классификации. Результаты, степень «правильности» которых превышают пороговое значение g, используются при генерации обучающих выборок. После чего модель RKELM обновляется. Таким образом, после каждой новой порции доверенных данных, происходит новая итерация обучения.
Для того, чтобы адаптироваться к новым пользователям, модель обновляется с помощью следующего алгоритма.
1.Во время распознавания, результаты, достоверность классификации которых превышает пороговое значение g, будут зарезервированы и использованы в качестве новых обучающих выборок.
2.Когда число новых обучающих выборок превышает предопределенный порог, начинается постепенное обновление модели распознавания на основе полученного набора обучающих данных.
|
Алгоритм адаптации модели распознавания можно обобщить следующим |
||||||||||||||||
борка { |
1 |
n |
α |
1 X′ |
H |
n },H |
= (∂ |
+ Q0 Q0) |
|
||||||||
образом: |
−= {xi}i=1 |
, K |
= {ki}i=1 |
|
0 |
−1 |
K |
|
|
−1 и новая обучающая вы- |
|||||||
|
|
X |
|
|
|
||||||||||||
|
Дана модель |
|
0, |
|
, |
|
0, где |
|
|
|
|||||||
|
|
0 |
|
|
|
|
|
|
|
|
где |
|
0 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||
|
|
|
|
веса натренированные на выборку |
|
; |
|
− выборка произведенная |
|||||||||
случайным образом; |
|
0 |
– |
временная матрица, |
необходимая для подсчета весов; |
||||||||||||
|
α |
|
|
|
|
|
|
X |
|
X′ |
|
||||||
∂ – |
предустановленная положительная константа; |
QK0 – окно сверточной сети. |
|||||||||||||||
|
|
|
|
|
H |
|
|
|
|
|
|
|
|
||||
11
3. |
Рассчитать |
H |
1 |
= H |
0 |
− H |
Q1 |
(1 + Q1H |
Q1 ) |
−1 |
Q1H |
0 |
|
|
|
|||||||
1. |
Вычислить матрицу окна |
|
1 |
|
1 |
|
; |
|
|
|
|
− Q1 |
α ) |
|||||||||
В |
данной работе |
|
|
|
|
α |
|
= α + H Q1 (K |
1 |
|||||||||||||
2. |
Рассчитать |
|
|
|
|
|
Q |
1 |
0 |
1 |
K |
|
|
|
; |
0 |
|
|||||
|
|
|
|
|
|
= Θ(X , X′) |
|
|
|
|
|
|
|
. |
||||||||
|
|
выходные веса |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
||||||
используется набор данных собранный с 30 пользователей в возрасте от 19 до 48 лет, который может быть загружен из репозитория машинного обучения UCI [5]. Каждый человек выполнял шесть действий (ходить, подниматься по лестнице, спускаться по лестнице, сидеть, стоять, лежать), во время этих упражнений каждый пользователь имел при себе смартфон, который регистрировал ускорение и угловую скорость по 3 осям. В наших экспериментах данные случайным образом были разделены на два набора, где 80% использовались для обучения, оставшиеся 20% для тестирования.
Было проведено сравнение производительности RKELM, ELM и SVM по распознаванию физической активности пользователей.
|
При проведении экспериментов были использованы следующие парамет- |
|||||||||
= 1000; SVM - |
15. |
∂ = 2 |
30, |
n |
= 500 (число скрытых узлов); ELM - |
γ = 1 n |
||||
ры: RKELM - σ = 1024, |
|
|
, |
|
||||||
|
|
приведены: время обучения (в секундах), время тестирования (в |
||||||||
|
В табл. 1∂ = 2 |
|
|
|
|
|
|
|
|
|
секундах) и точность тестирования. |
|
|
|
|
||||||
|
|
|
|
|
|
|
|
Таблица 1 |
||
|
|
Сравнение производительности классификаторов |
|
|
||||||
|
|
|
|
RKELM |
ELM |
SVM |
|
|
||
|
Время |
обуче- |
|
0,64 |
|
2,09 |
5,1 |
|
|
|
|
ния (с.) |
|
|
|
|
|
|
|
|
|
|
|
|
|
0,12 |
|
0,18 |
2,83 |
|
|
|
|
Время работы |
|
|
|
|
|||||
|
(с.) |
|
|
|
|
|
|
|
|
|
|
Точность (%) |
|
98,49 |
99,05 |
98,77 |
|
|
|||
Как видно из табл. 1, точность RKELM - 98,49% (конкурентноспособная, хоть и не самая высокая точность). Кроме того, время обучения и работы RKELM намного меньше, чем у SVM и ELM. Среднее время обучения RKELM составляет 0,64 с, в то время как ELM и SVM требуют 2,09 и 5,1 секунду соответственно. Из чего можно сделать вывод, что RKELM намного быстрее, чем
SVM и ELM.
Далее сравним модели по эффективности применения на пользователях, для которых обучение не проводилось.
В качестве примера, случайным образом были выбраны три пользователя из 30 имеющихся, обозначим их как A, B и C. Тогда наборы данных этих поль-
зователей обозначаются как |
|
|
, |
|
и |
|
|
, соответственно. Каждый набор дан- |
||||||||||
ных случайным образом |
разделен на две части (80%: 20%), которые представ- |
|||||||||||||||||
|
|
DA |
|
DB |
|
DC |
|
|
DC2 |
– выборка, которая исполь- |
||||||||
лены как |
DA1 |
и |
DA2 |
, |
DB1 |
и |
DB2 |
, а так же |
DC1 |
и |
||||||||
|
|
|
|
|
|
|
|
. A и B примем за известных |
||||||||||
пользователей, а C - за нового. |
ABобуч |
= DA1 |
+ DB1 |
|||||||||||||||
|
|
|
|
|
|
|
|
|
|
|||||||||
12

зуется для обучения модели RKELM в начальный момент. Данные |
|
|
исполь- |
|||
зуются для адаптации исходной модели к новому пользователю. |
|
|
использу- |
|||
|
DC1 |
|
||||
ется для проверки возможности классификации активности |
новых пользовате- |
|||||
|
DC2 |
|
|
|||
лях. Для исходной модели RKELMадапт и каждой тестовой выборки |
|
|
, приме- |
|||
няется правило − если достоверность классификации g больше |
0,75, она будет |
|||||
|
DC1 |
|
||||
добавлена в новый набор данных |
HC1, благодаря чему, происходит процесс |
|||||
адаптации. |
||||||
В табл. 2 представлены полученные результаты, отражающие точность
классификации моделей ELM, SVM, RKELM и RKELMадапт (предложенного алгоритма) на неизвестных системам пользователях. Для RKELMадапт так же
представлено значение после адаптации.
|
Результаты распознания данных нового пользователя |
Таблица 2 |
||||||||
|
|
|
||||||||
|
|
|
|
До адаптации |
|
|
После адаптации |
|
||
|
Обучающая выборка |
|
|
обуч |
|
|
обуч |
+ |
C1 |
|
|
Тестовая выборка |
|
|
|
|
|
|
|||
|
|
|
|
C2 |
|
|
C2 |
|
|
|
|
|
|
|
|
|
|
|
|||
|
Точность RKELMадапт |
|
|
|
|
|
|
|||
|
(%) |
|
88,41 |
|
92,75 |
|
|
|||
|
|
|
|
|
|
|
|
|
|
|
|
Точность RKELM(%) |
|
84,28 |
|
- |
|
|
|
||
|
Точность SVM(%) |
|
49,4 |
|
- |
|
|
|
||
|
Точность ELM(%) |
|
79,81 |
|
- |
|
|
|
||
Как можно увидеть из приведенной таблицы, точность RKELM (и его модифицированного варианта) изменилась менее всего, при этом после адаптации, значение точности классификации увеличилось на 4,3%, как итог – разница между точностью классификации известных пользователей и неизвестных составляет менее 5,7%.
Принимая во внимание вышесказанное, можно сделать вывод, что предложенный подход превосходит конкурентные в скорости и производительности, при этом, лишь незначительно уступая в точности классификации данных пользователей, для которых было проведено обучение, но оказывается значительно точнее на новых пользователях, благодаря процессу адаптации. Описанные положительные черты дают серьезные преимущества при его применении на мобильных платформах, обладающих ограниченными ресурсами.
Литература
1.Anguita, D., Ghio, A., Oneto, L., Parra, X., & Reyes-Ortiz, J. L. Human activity recognition on smartphones using a multiclass hardware-friendly support vector machine. In Ambient assisted living and home care - Springer, 2012. - pp. 216–223.
2.Huang, G. B., Zhu, Q. Y., & Siew, C. K. Extreme learning machine: theory and applications. - Neurocomputing, 2006. – pp. 489–501.
13
3.Lee, Y. J., & Huang, S. Y. Reduced support vector machines: a statistical theory. - Neural Networks, IEEE Transactions on, 2007. – pp. 1–13.
4.Deng, W., Zheng, Q., & Zhang, K. Reduced Kernel Extreme Learning Machine. - In Proceedings of the 8th international conference on computer recognition systems CORES, 2013. - pp. 63–69.
5.Blake, C.L., & Merz, C.J. UCI Repository of machine learning databases [http://www.ics.uci.edu/mlearn/MLRepository.html ] - Irvine, CA: University of California, Department of Information and Computer Science, 1998. - pp.55.
ФГБОУ ВО «Воронежский государственный технический университет», Россия
УДК 681.3
А.А. Цветков
ГЕНЕТИЧЕСКИЕ АЛГОРИТМЫ КАК СПОСОБ РЕШЕНИЯ ЗАДАЧИ ОПТИМИЗАЦИИ ЗАКУПКИ ПО
Одной из задач интеллектуальных систем является поиск оптимального решения: когда на систему влияет множество внешних и внутренних факторов, интеллектуальное устройство должно учесть их все и выбрать оптимальное поведение с точки зрения своей выгоды.
Генетические алгоритмы – адаптивные методы поиска, которые используются для решения задач функциональной оптимизации. Они основаны на механизмах и моделях эволюции, и генетических процессов биологических алгоритмов.
Генетический алгоритм — это метод перебора решений для тех задач, в которых невозможно найти решение с помощью математических формул. Однако простой перебор решений в сложной многомерной задаче – это бесконечно долго. Поэтому генетический алгоритм перебирает не все решения, а только лучшие. Алгоритм берёт группу решений и ищет среди них наиболее подходящие. Затем немного изменяет их – получает новые решения, среди которых снова отбирает лучшие, а худшие отбрасывает. Таким образом, на каждом шаге работы алгоритм отбирает наиболее подходящие решения (проводит селекцию), считая, что они на следующем шаге дадут ещё более лучшие решения (эволюционируют).
Абсолютно правильный ответ будет получен, только если перебрать все варианты, а их очень много. Поэтому генетический алгоритм ищет не правильное решение, а оптимальное, исходя из условий, которые задаёт пользователь.
Критерий останова – условие, по которому генетический алгоритм останавливает свою работу.
Например, такими критериями могут быть:
14