Материал: Проектирование портала для анализа и оценки стиля научных текстов
Хранение составляющих корпус документов в электронной форме иногда входит в определение корпуса [10]. Кроме этого, важной частью корпуса является его разметка. Разметка или аннотации - множество меток, относящихся к отдельным словам или частям текста и содержащих некоторую информацию. Одним из базовых видов разметки для корпуса является разметка по результатам морфологического анализа. Средство просмотра корпуса в электронном виде должно предоставлять возможность просматривать или редактировать аннотации к элементам текста.
Разметка бывает разных типов. К первичной разметке текстов относятся этапы токенизации (разбиения на орфографические слова), лемматизация (приведение словоформ к словарной форме) и морфологический анализ. Среди лингвистических типов разметки выделяются следующие:
− морфологическая (part-of-speech tagging);
− синтаксическая (parsing);
− семантическая;
− анафорическая;
− просодическая.
Первые три типа являют собой результат проведения соответствующих типов анализа и нанесения определённых меток (тэгов, аннотаций) на слова или словосочетания. Анафорическая разметка текста позволяет указать принадлежность местоимений к заменяемым ими словам. Просодическая разметка применяется в корпусах, где необходима информация об особенностях произношения слов: ударениях, интонации и т.д.
Нанесение разметки вручную требует многих затрат, поэтому разрабатываются программные средства для решения этой задачи. В частности, морфологический и синтаксический анализ успешно автоматизирован и производится тэггерами и парсерами- специальными программными средствами, осуществляющими морфологическую и синтаксическую разметку текста соответственно. Однако системы, позволяющие работать с разметкой текста, допускают возможность пользовательского редактирования меток.
Для решения своих задач могут понадобиться, помимо основных, собственные типы разметки. В этом случае разметку текста, опять же, можно произвести вручную, а можно автоматизировать процесс, написав свою программу или воспользовавшись специализированной средой для работы с документами. Для автоматического аннотирования часто используют регулярные выражения, основанные на лексико-синтаксических шаблонах - структурных образцах языковой конструкции, которые отображают её лексические и поверхностные синтаксические свойства [3]. Шаблоны для каждого вида аннотаций составляются лингвистами с использованием определённого синтаксиса и стандартных элементов [28].
Корпуса используются в различных исследованиях лингвистов, а также при
создании словарей, автоматическом переводе, создании учебных пособий,
тестировании программ автоматического анализа и синтеза речи [7]. Множество
областей применения корпусов и их анализа продолжает пополняться. Одной из
актуальных сфер является проведение стилистического анализа для оценки качества
научных статей - задача, рассматриваемая в данной работе.
1.3. Анализ существующих инструментальных средств для работы с
корпусами текстов
Поскольку использование корпусов тесно связано с информационными технологиями, существуют различные инструментальные средства для просмотра и обработки размеченных коллекций текстов, начиная с библиотек, созданных для упрощения работы программистов, заканчивая полноценными средами, доступными для лингвистов без навыков программирования. Далее рассмотрена возможность применения каких-либо из существующих инструментов при реализации метода анализа стиля академических текстов на основе сравнения с эталонным корпусом. Выделяются следующие требования:
− возможность выбора одного из нескольких корпусов;
− загрузка в систему собственного корпуса;
− редактирование разметки корпуса вручную;
− автоматическое нанесение разметки с помощью специальных расширений или обрабатывающих ресурсов, использующих лексико-синтаксические шаблоны;
− сбор статистики и создание отчётов или возможность разработки соответствующего расширения
− возможность одновременной работы большого количества пользователей.
При анализе инструментальных средств также учитываются аспекты, не касающиеся непосредственно реализуемого метода. На их основе формируются нефункциональные требования к разрабатываемому приложению.
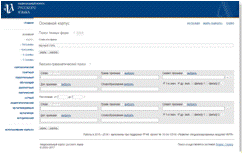
Работа с национальными корпусами в некоммерческих и учебных целях, как правило, осуществляется на специальных сайтах в интернете. В качестве примера можно привести сайт Национального корпуса русского языка (НКРЯ) [10]. Основной и единственной доступной функцией для работы с корпусом является поиск. Есть возможность пользоваться обычным поиском (см. рис. 1.1), просто вводя искомые словосочетания, также доступен лексико-грамматический поиск, учитывающий множество параметров.
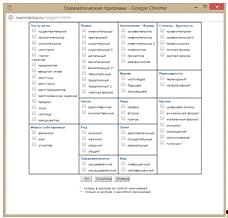
Тексты в НКРЯ содержат синтаксическую разметку, поэтому параметры поиска
весьма разнообразны (см. рис.1.2).
Рисунок
1.1.Поиск по Национальному корпусу русского языка
Рисунок
1.2. Параметры поиска по Национальному корпусу русского языка
Поиск словоупотреблений часто является главной и единственной функцией многих программ для работы с корпусами. Такие программы называются конкордансерами, и они предназначены для использования лингвистами и людьми с более низкой квалификацией. Конкорданс - это список всех употреблений заданного языкового выражения. Специализированные программы позволяют создавать конкордансы, то есть рассматривать контексты употребления тех или иных выражений для дальнейших учебных или исследовательских целей.
Конкордансеры могут быть привязаны к определённому корпусу, как, например, браузерный конкордансер StringNet, который использует для поиска словоупотреблений национальный корпус английского языка (BritishNationalCorpus, BNC) [20]. Бывают и другие программы, которые позволяют загружать пользовательские коллекции текстов и работать с ними в режиме оффлайн. Программы с наиболее широкой функциональностью позволяют, помимо построения конкордансов, составлять списки слов корпуса (wordlists) и списки ключевых слов (для этого может использоваться сравнение с неспециализированным корпусом), выполнять поиск с помощью регулярных выражений, читать и наносить разметку (аннотации).
В качестве примеров продуктов с широкой функциональностью мы рассмотрим две бесплатные программы - конкордансер AntConc и среду для разработки приложений по обработке текстов GATEDeveloper. Оба этих продукта являются универсальными с точки зрения лингвистических задач и не ограничены какой-либо узкой предметной областью.
AntConc - основная из семейства программ, созданных Лоренсом Энтони для работы с корпусами. Помимо AntConc, предназначенной в основном для выделения конкордансов и анализа текстов, существуют и другие продукты, например, AntPConc для анализа параллельных корпусов и AntWordProfiler, в котором слова текста соотносятся с имеющимися списками (wordlists) и разделяются на уровни в зависимости от принадлежности к одному из этих списков (или отсутствия принадлежности к какому-либо из них), а также предоставляется статистическая информация. AntConc содержит в себе семь инструментов[31]:
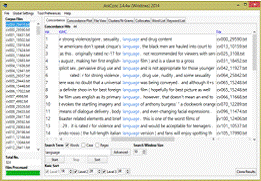
− поиск конкордансов в формате «ключевое слово с контекстом»
(см. рис 1.3) для исследования стандартных случаев употребления слов в корпусе;
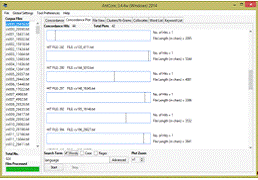
− поиск конкордансов в формате карты («штрих-кода»)для исследования позиций, в которых встречается искомое выражение(см. рис 1.4);
− просмотр текстовых файлов (в том числе с результатами работы других инструментов AntConc);
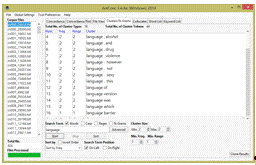
− выделение кластеров (часто встречающихся контекстов на основе искомого выражения) и N-грамм (часто встречающихся выражений размером в Nслов) (см. рис. 1.5);
− выделение устойчивых выражений, содержащих искомый термин;
− создание списка слов на основе всех текстов корпуса (с указанием частотности);
− создание списка ключевых слов (с использованием
неспециализированного корпуса), например, для выделения терминов в корпусе по
определённой предметной области.
Рисунок
1.4. Поиск конкордансов в формате карты в AntConc
Рисунок
1.5. Выделение кластеров в AntConc
AntConc представляет собой настольное приложение для однопользовательской работы, позволяет настраивать некоторые элементы под нужды и предпочтения пользователя. Однако, являясь удобным инструментом для базовых задач - поиска конкордансов, создания списков слов и выделения ключевых слов, - он не предоставляет возможность создания в данном интерфейсе средств для автоматической обработки корпуса и нанесения разметки.
GATEDeveloper [23] также является одним из представителей целого семейства средств для работы с корпусами. В отличие от AntConc, основная функция GATEDeveloper - не использование готового корпуса текстов для исследовательских и учебных целей, а создание приложений, собственных обрабатывающих ресурсов для нанесения разметки и анализа текста. GATEDeveloper - это интегрированная среда для разработки приложений по обработке текстов, включающую в себя встроенную систему извлечения информации и множество плагинов. Существует также фреймворк GATEEmbedded для использования функций GATE Developer при программировании отдельных приложений, GATE Cloud для облачных вычислений и веб-приложение GATETeamware для управления проектами по совместной работе над корпусом.
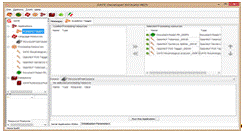
Приложения в GATEDeveloper представляют собой конвейеры (Pipelines) - последовательности применения обрабатывающих ресурсов (ProcessingResources) к корпусу или текстовому файлу. Обрабатывающие ресурсы создаются на основе плагинов, входящих в стандартный набор или созданных программистами (с помощью библиотек GATE на языке Java). Интерфейс создания конвейера показан на рисунке 1.6.
Стандартные плагины GATE
могут использоваться для нанесения разных видов разметки: токенизации
(выделения отдельных элементов текста, чаще всего слов), разбиения на
предложения, синтаксического и морфологического анализа (определения частей
речи и некоторых характеристик слов) и других. Разметка наносится в виде меток
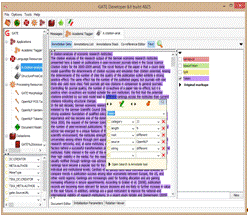
- аннотаций (Annotations), доступна для просмотра и может
быть отредактирована вручную (см. рис 1.7). Пользователь может создавать метки
любого типа (вручную или с помощью приложения), и разные типы аннотаций будут
отмечены в документах корпуса разными цветами.
Рисунок
1.6. Создание конвейера для обработки корпуса в GATEDeveloper
Высокий уровень функциональности и универсальности программы негативно
сказывается на удобстве её интерфейса: создание и сохранение даже ручной
разметки, а тем более создание приложений является трудной задачей для
недостаточно знакомых с программой пользователей. Такое приложение подходит
только для решения задач профессиональными лингвистами с некоторыми навыками
программирования. Кроме того, библиотеки GATE могут быть использованы при создании собственного
отдельного сервиса, что является полезным при необходимости создания
специализированного приложения, которое требует выполнения некоторых основных
функций, например, нанесения базовых видов разметки.
Рисунок
1.7. Ручное редактирование разметки
В целом, рассматривая различные средства анализа корпусов, можно сделать следующие выводы:
. ПО для обработки корпусов может предоставляться в виде подключаемых библиотек, приложений, онлайн-сервисов и специализированных сред разработки.
. Данные виды ПО имеют различные функции, наиболее популярными из которых являются: работа с конкордансами, выделение ключевых слов и словосочетаний, лексический анализ (составление wordlists и др.), составление модели текста, аннотирование текстов (в т.ч. POS-tagging, парсинг и т.п.).
. ПО, используемое в сфере компьютерной лингвистики, в разной степени автоматизировано. Так, одни ресурсы предназначены для ручного использования (конкордансеры, средства ручного аннотирования и др.), в то время как целью других является автоматизация процессов (выделение ключевых слов, автоматическое аннотирование и т.д.).
. Ресурсы работы с корпусами бывают как коммерческими, так и открытыми.