Курсовая работа (т): Прогнозирование изменений валютного курса
Прогнозирование изменений валютного курса
Оглавление
Введение
Глава 1. Теоретические предпосылки исследования
1.1 Актуальность работы
1.2 Методические предпосылки исследования
1.3 Предмет, объект, цель и задачи исследования.
Глава 2. Основные подходы к решению поставленных задач
2.1 Семантический анализ текста
2.2 Лингвистический подход
2.3 Twitter API. Представление данных
2.4 Выбор селекторов
2.5 Наборы данных
2.6 Предобработка данных
2.7 N-грамы. Вектор признаков
2.8 Классификаторы
2.9 Этапы исследования
2.10 Язык анализа R
Глава 3. Результаты
Заключение
Список используемой литературы
Приложения
Введение
Forex является самым крупным и наиболее ликвидным финансовым рынком, с ежедневным оборотов в, примерно, $1 трлн, что вызывает серьезный интерес к этому сектору финансов и ясно дает понять, что по различным причинам любой трейдер на Форекс хотел бы иметь точный прогноз обменного курса. Но прогнозирования финансового рынка привлекает к себе большое внимание не только трейдеров, но и представителей академических кругов, а также в бизнеса. Но можно ли финансовый рынок в действительности предсказать?
На обменный курс влияет множество факторов и событий. Какие-то факторы очень быстро отражаются на курсе национальной валюты, какие-то медленно и не так заметно. Как правило, такие реакции, как изменения обменного курса в целом может быть хорошо объяснено задним числом, но в течение коротких периодов времени их затруднительно предсказать выше случайного уровня.
Условно эти факторы можно поделить на три категории:
· краткосрочные
· среднесрочные
· долгосрочные
Из психологических исследований известно, что эмоции, в дополнение к информации, играют существенную роль в принятии решений человеком [16], [18], [39]. Поведенческие финансы предоставляют еще одно доказательство того, что финансовые решения значительно движимы эмоциями и настроением [19]. Таким образом, новости, настроение (сантимент) инвесторов, информационный шум - это то, что принято считать стимуляторами краткосрочные колебаний курса. Обычно они небольшие - всего несколько копеек в день вверх или вниз. Именно на таких ежедневных колебаниях играют спекулянты на бирже. Но для этого нужно постоянно отслеживать новостные ленты и очень быстро реагировать на появляющиеся в них новости. Кроме того нужно хорошо понимать, какое влияние та или иная новость окажет на рубль, а так же как ее воспримет большинство игроков на рынке. Иногда паника населения, сметающего валюту из обменников, может очень сильно повлиять на курс рубля и даже обрушить его на несколько процентов.
Большинство трейдеров используют традиционными методами прогноза, как технический анализ в сочетанием фундаментальным. Множество исследований по прогнозированию финансового рынка [1], [2], [3] основаны на теории случайных блужданий и гипотезе эффективного рынка (efficient market hypotesis, EMH) [4]. В соответствии с EMH на финансовом рынке цены в значительной степени обусловлены новой информацией, то есть новостями, а не нынешними и прошлыми ценами. Так как новости непредсказуемы, цены на фондовом рынке будут блуждать случайным образом и не могут быть предсказаны с более чем 50-процентной точностью [5].
Существует две проблемы с EMH. Во-первых, многочисленные исследования показывают, что цены на финансовом рынке не блуждают по случайному паттерну и в действительности могут быть предсказаны в некоторой степени [5], [6], [7], [8], тем самым ставя под сомнение основные допущения EMH. Во-вторых, последние исследования показывают, что новости может быть и непредсказуемы, но для прогнозирования изменений различных экономических и коммерческих показателей самые ранние индикаторы могут быть извлечены из социальных медиа платформ (Facebook, блоги, Twitter и т.д.). На самом деле, само существование таких платформ является вызовом для гипотезы эффективного рынка, так как предлагают данные в режиме реального времени с возможной предсказательным потенциалом для валютного и других рынков.
Данная работа основана на анализе данных, извлечённых из Twitter. Будучи глобальным и чувствительным к небольшим изменениям в международной повестке дневных новостей Twitter, кажется, соответствует метафоре барометра кризиса и может быть преобразован в прогностическую модель валютного курс. По-настоящему эффективный валютный рынок будет означать, что обсуждения в Twitter не имеют прогностическое значение для валютных курсов. С одной стороны, данные, почерпнутые из Twitter могут облегчить предсказание интересующих нас переменных. С другой стороны, предсказательные возможности концепций, упомянутых в Твиттере, будут меняться во времени и могут легко подвергаться структурным сдвигам.
В данной работе проведена поведенческая аналитика данных Twitter путём семантического анализа текста и выявления тональности сообщений. Было реализовано две системы: одна система основана на лексическом подходе, вторая - на машинном обучении с учителем. В работе приводиться писание подхода к извлечению данных, способы представления тексов для обучения, различные алгоритмы классификации и метрики оценки эффективности. Производиться сравнение работы алгоритмов машинного обучения классификации сообщений из Twitter при представлении признаков как юинираммы и биграмм.
валютный курс лексический подход
Глава 1. Теоретические предпосылки исследования
1.1 Актуальность работы
Самым крупным финансовым рынком в мире является валютный, но он ненадёжный и переменчивый. Выявление степени зависимости между поведением пользователей Twitter и изменением валютного курса, а также разработка системы анализа данных, позволяющей предсказывать волатильность обменного курса может быть использована в качестве вклада в процесс принятия инвестиционных решений. Основным вкладом данной работы является применение поведенческой аналитики данных Twitter к российском валютному рынку для пары USD/RUB. Исследование является исключительным за счёт того, что подобный анализ не был проведен в таком контексте, не смотря на то, что существует ряд работ по изучению влияния Twitter-настроений на изменения на фондовом рынке и несколько работ, посвящённых другим валютным парам. Одним из преимуществ изучения валютного рынка является то, что из-за его огромного объема, возможность спекуляций с помощью дезинформации в Twitter, предполагается, будет ниже, чем в анализе фондового рынка.
1.2 Методические предпосылки исследования
Несмотря на большое количество работ затрагивающих настроение и фондовые рынки, данный момент существует очень ограниченное количество исследований по изучению способности настроений в микроблогах прогнозировать обменные курсы. Для того, чтобы самое лучшее из наших знаний существующая литература по данной тематике ограничивается только две работы. Papaioannou и др. (2013) разработали авторегрессию и модель искусственной нейронной сети для прогнозирования ежедневного курса доллара к евро, охватывающие период 10 октября 2010 по 05 января 2011. Авторы собирают 20250 сообщения от Twitter и выберают те, которые относятся обменному курсу USD/EUR. В соответствии с доказательствами, представленными при некоторых предположениях модели, которые используют информацию, предоставленную твиты может превзойти модель RW. Второй документ (Janetsko, 2014) собирает сообщения Twitter с 1 января 2013 года по 27 сентября 2013 г. Автор развивает модель ARIMA кормили с тенденциями настроения участников рынка, как извлекается твиты с целью прогнозирования цены дня закрытия EUR / USD ставка. Он приходит к выводу, что модель настроения на основе постоянно превосходит модель RW. Изучение существующей литературы относительно краткосрочного прогнозирования валютных курсов приводит к смешанным результатам, так как нет четкого консенсуса относительно эффективности валютного рынка в ежедневной торговой горизонта (например, см Tabak и Лима (2009) и Краудер (1994)).
При изучении исследований по прогностическому моделированию с помощью данных из социальных медиа, были сформулированы три базовых требования: Во-первых, все моделируемые области должны провоцировать интенсивные общественные обсуждения на социальных медиа-платформах. На самом деле приобретение этих данные может или не может быть тривиальным или дорогостоящим. Однако ясно, что недостатка в данных, доступных для моделирования, не должно быть. Во-вторых, для каждой области является принципиальным смоделировать однозначную числовую меру, внешнею по отношению к Интернету, например, доходы, биржевые ставки или результаты всеобщих выборов. Это требование подчеркивает, что переменная, которую будут предсказывать, является неотъемлемой частью любой установки прогнозирования. В-третьих, социальные медиа обычно генерируют переизбыток данных. Twitter, например, является источником полумиллиарда текстовых сообщений в день (Гоел, 2013). Популярность социальных медиа часто означает, что поиск информации, которая облегчает выбранную задачу моделирования является сложным испытанием. Таким образом, третьим требованием для успешного моделирования с помощью данных социальных медиа является выбор информации с пояснительным или прогнозным потенциалом. Например, Papaioannou и др. (2013) решает проблему выбора с помощью функции поиска Архивариус API для твитов, которые использовали выражение "buy EUR / USD".
Эти три требования, описанные выше, помогают сузить условия, при которых Twitter может быть использован для моделирования обменного курса USD/RUB. Во-первых, Twitter представляет собой глобальную платформу, на которой обмениваются новостями, мнениями, комментариями в беспрецедентных масштабах. Часто этот тип информации варьируется в зависимости от волатильности рынков, включая валютные рынки. Во-вторых, USD/RUB обменный курс, очевидно, является численная мера, поддающейся моделированию. Возможно что данные, добытые из Twitter выполняют третье требование, т.е. возможно отборать информацию с пояснительным или предиктивным потенциалом. Данный вопрос остаётся открытым, и заслуживает более подробного обсуждения.
1.3 Предмет, объект, цель и задачи исследования.
Целью данной работы является выявление, исследование и оценка ценных особенностей и закономерностей в движения обменного курса Доллар США / Российский рубль (USD/RUB) путем анализа соответствующих данных, полученных из Twitter с помощью анализа настроений. Необходимо определить, могут ли сообщения, найденные в Twitter быть использованы в качестве вклада в процесс принятия инвестиционных решений. Более конкретная цель данной работы заключается в решении вопроса о том, какая система и в какой степени может улучшить прогнозирование валютного курса EUR / USD. Таким образом был определен объектом исследования является валютный рынок
Предметом исследования является изменение валютного рынка.
Для достижения цели необходимо решить следующие задачи:
. Сбор всех необходимых данных и их формальное описание для дальнейшего анализа;
2. Выявление теоретических основ проблемы: подходов к анализу тональности, модели представления текста, фунций весов, классифицирующие алгоритмы. Выбрать то сочетание модели языка и весов, которое даст наилучший показатель точности на данной выборке.
. Реализовать 3 метода анализа тональности:
) лингвистический метод, основанный на сравнении с готовым тональным словарём;
) метод машинного обучения "с учителем", использующий в качестве признаков юниграмы.
) метод машинного обучения, использующий биграммы.
4. Для подходов, основанных на машинном обучении,
сравнить результаты работы различных классифицирующих алгоритмов (наивный
Байесовский алгоритм, k-ближайших соседей, алгоритм "случайный
лес", метод опорных векторов). Выбрать алгоритм, дающий наибольший уровень
точности на конкретной обучающей выборке.
Глава 2. Основные подходы к решению поставленных задач
2.1 Семантический анализ текста
Главной задачей sentiment analysis (анализа тональности) является выявление эмоционального отношения (или мнения) автора высказывания к некоторому объекту, выраженное в тексте.
Мнения бывают двух типов:
. непосредственное мнение;
2. сравнение.
Разрабатываемые системы основываются на анализе непосредственных мнений. Таким мнением называется кортеж из пяти элементов (e, f, op, h, t), где:
(entity, feature) - объект тональности e (сущность, о которой высказывается автор) или его свойства f (атрибуты, части объекта);
orientation или polarity - тональная оценка (эмоциональная позиция автора относительно упомянутой темы);
holder - субъект тональности (автор, то есть кому принадлежит это мнение);
time - врем, когда было оставлено мнение.
Так как мнения извлекаются с помощью Twitter API не случайным образом, а по определенным условиям, объект тональности известен. Twitter API также предоставляет информацию об авторе и времени.
Примеры тональных оценок [4]:
· позитивная;
· негативная;
· нейтральная.
Под "нейтральной" подразумевается, что текст не содержит эмоциональной окраски.
Существующая работа по анализу настроений могжет быть
классифицирована с различных точек зрения: по используемому методу,
представлению текста, уровню детализации анализа текста, виду рейтинга и т.д.
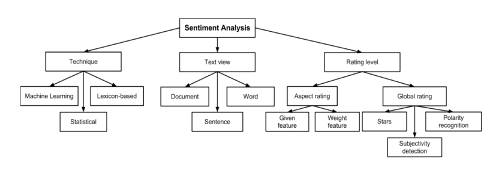
С точки зрения представления текста, определение настроение осуществляется для всего документа (сообщения). Это может быть сделано с помощью машинного обучения "с учителем”, "без учителя”, с помощью подхода, основанного на лингвистических правилах, или на комбинации из этих различных методов. В рамках исследования реализовываются два различных подхода: лингвистический и машинное обучение "с учителем”.
2.2 Лингвистический подход
Подход основанный на лингвистике включает в себя вычисление настроений для документа с использованием заранее подготовленного тонарного словаря, содержащего слова, для которых уже отмечена тональность. Массив данных для позитивных и негативных слов, выражающих мнение (тональных слов) взят у Linis Crowd - краудсорсинговом веб-ресурсе для создания лингвистических инструментов.
Метод машинного обучения
Метод машинного обучения использует несколько алгоритмов классификации для определения настроения путем обучения на известном наборе данных с тональной размет. Подход машинного обучение с учителем требует в качестве обучающей выборки набор тонально размеченных документов.
2.3 Twitter API. Представление данных
Twitter, социальная сеть для ведения микроблога, считается 9ым самым популярным сайтом в соответствии с рейтингом Alexa на состояние января 2015 года. Она имеет около 284 млн ежемесячно активных пользователей. Каждый день публикуются порядка 500 миллионов твитов, большинство из которых находятся в открытом доступе. Популярность Twitter среди академиков, ученых и исследователей растет, за счёт простоты сбора данных на основе предопределенных пользовательских параметров Twitter API, в отличие от других социальных медиа сайтов, таких как Facebook, где извлечение данных является трудной задачей.
"Twitter Streaming API" - это возможность, предоставляемая Twitter, которая позволяет любому извлекать максимум 1% выборку всех данных. Morstatter считает, что для больших наборов данных или больших задач, которые генерируют много трафика, 1% данных, по-видимому, 'верный' в полной мере поток, с общим набором самых популярных ключевых слов и хэштегов [9]. Поскольку собранные сообщения за 12 месяцев продолжительности имеет значительное количество твитов, ожидается, что общие тенденции будут наблюдатся в этом образце, проведет в течение всего набора данных.
Text - Текст твита
Screen Name - отображаемое имя пользователя, разместившего твит
ID - уникальный идентификатор твита
Retweet - "True", если твит был процитирован другим пользователем