Материал: шпоры бд
Особенности клиента
Пользователям, работающим в сети, часто требуется запускать приложения с сетевого сервера. Клиентские компоненты должны включать средства поддержки локальной информации (в том числе и информацию из локального реестра и локальных файлов) и средства, предоставляющие пользователю доступ к серверным компонентам.
Особенности сервера
В состав серверной части должны входить основные исполняемые файлы, библиотеки и все остальные файлы, необходимые для поддержки доступа пользователей по сети. Кроме того, надо изучить требования к ресурсам сервера и на их основе принять решение относительно аппаратной конфигурации, учитывая тип процессора (например, SQL Server поддерживает процессоры Alpha AXP, MIPS и 32-разрядные процессоры семейства Intel x86) и ресурс памяти (чем больше клиентов, тем больше потребуется ОЗУ для сохранения и увеличения быстродействия).
Системы клиент-сервер
Клиент-серверная система управления базой данных может опираться на несколько типов распределения обязанностей между клиентом и сервером:
«интеллектуальные» клиенты;
«интеллектуальный» сервер;
смешанные системы;
многоуровневые системы. Схему реализации выбирают на основе анализа требований к:
сетевому графику;
ресурсам клиента и сервера;
производительности базы данных.
«Интеллектуальные» клиенты
Это один из самых распространенных методов реализации клиент-серверных приложений (рис. 6.7). «Интеллектуальному» клиенту можно доверить выполнение как бизнес-логики, так и сервисов представления данных.
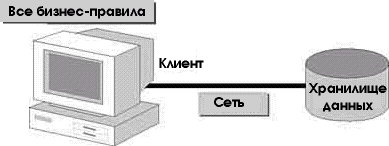
Рис. 6.7 Бизнес-логика реализована на клиенте
В этом случае функции сервера ограничены поддержкой собственно базы данных. Вся информация обрабатывается локально, что освобождает ресурсы сервера. Многие приложения, разработанные на Visual Basic, являются интеллектуальными клиентами.
Достоинства «интеллектуальных» клиентов
Простота архитектуры, что облегчает разработку и сопровождение системы.
Наличие хорошо известных и достаточно мощных средств разработки (например, Visual Basic 5.0).
Клиент хорошо подходит для хранения текущей информации о состоянии, например первичного ключа записи, которую сейчас просматривает пользователь.
Недостатки «интеллектуальных» клиентов
Выполнение бизнес-правил на клиенте иногда увеличивает сетевой трафик из-за необходимости передавать клиенту все данные для принятия решения на основе правил.
Для модификации бизнес-логики необходимо повторное развертывание всех клиентов.
«Интеллектуальные» серверы
Перенеся все бизнес-правила на SQL Server, где они реализуются в виде хранимых процедур, Вы создадите «интеллектуальный» сервер (рис. 6.8). Роль сервера в такой клиент-серверной системе много шире простого хранилища файлов, доступных множеству пользователей сети. Интеллект сервера проявляется в способности выполнять команды (SQL-запросы) и возвращать результирующий набор данных.
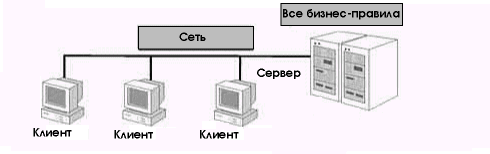
Рис. 6.8 Бизнес-логика реализована на центральном сервере
В двухуровневой системе с «интеллектуальным» сервером бизнес-логика и сервисы представления развертываются на сервере. В этом случае бизнес-логика обычно реализуется в виде хранимых процедур и триггеров БД, так что основная часть обработки выполняется на сервере, а не на компьютере-клиенте.
Достоинства «интеллектуальных» серверов
Увеличение производительности: бизнес-логика выполняется в том же адресном пространстве, что и код доступа к базе данных, и, кроме того, тесно интегрирована с механизмом поиска данных SQL Server. Это означает, что данные не нужно перемещать или копировать перед обработкой, а значит, сетевой трафик минимизируется.
На сервере легче обеспечивать целостность данных.
При необходимости бизнес-логика модифицируется централизованно, без изменения клиентов.
Недостатки «интеллектуальных» клиентов
Повышение требований к ресурсам сервера, где выполняются все запросы и манипуляции с данными.
Ограниченный выбор средств разработки: хранимые процедуры, например, создают на языке Transact-SQL. Хотя SQL Server поддерживает вызовы кода, написанного на других языках, этот подход сложен и в общем случае менее эффективен, нежели разработка тех же функций на Transact-SQL.
Смешанные системы
В рамках двухуровневой реализации возможны и смешанные варианты, обладающие достоинствами как интеллектуальных серверов, так и интеллектуальных клиентов (рис. 6.9). Например, клиентский компонент смешанного решения, разработанный средствами Visual Basic, может вызывать хранимые процедуры SQL Server.
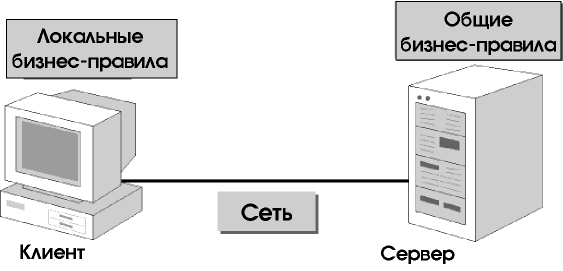
Рис. 6.9 Смешанные системы: интеллектуальные клиенты и интеллектуальный сервер
Достоинства смешанных систем
Часть бизнес-логики может быть реализована в клиентской части.
Серверный код (например, хранимые процедуры SQL Server) одновременно доступен многим клиентам, что снижает накладные затраты при выполнении однотипных запросов.
Эффективность работы клиентов меньше зависит от сетевого трафика.
Недостатки смешанных систем
Бизнес-логика распределена между клиентом и сервером.
Модернизация приложения требует распространения новых версий клиентской части среди широкой аудитории.
Многоуровневые системы
Многоуровневая система (иногда ее называют трехуровневой) позволяет разделить пользовательский интерфейс, бизнес-правила и базу данных (рис. 6.10).
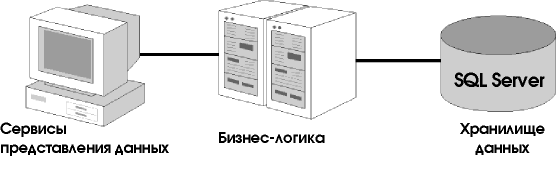
Рис. 6.10 Пользовательский интерфейс, бизнес-правила и база данных размешены отдельно
В многоуровневой системе бизнес-правила реализуются как отдельные библиотеки (DLL). Их (например, написанные на Visual Basic) можно разместить на сервере. Клиент, библиотеки и база данных составляют распределенные сервисы многоуровневой системы.
55 Многомерные базы данных. Разработка (извлечение) данных
Многомерные базы данных рассматривают данные как кубы, которые являются обобщением электронных таблиц на любое число измерений. Кроме того, кубы поддерживают иерархию измерений и формул без дублирования их определений. Набор соответствующих кубов составляет многомерную базу данных (или хранилище данных).
Многомерные базы данных отличаются от реляционных прежде всего трехмерностью — поддержкой неограниченного числа значений в поле, и находят свое применение там, где необходима эффективная и простая работа с большими массивами символьной информации. В многомерных СУБД данные организованы в виде упорядоченных многомерных массивов, удовлетворяющих требованиям защиты от несанкционированного доступа в организации. Они обеспечивают более быструю реакцию на запросы данных за счет того, что обращения поступают к относительно небольшим блокам данных, необходимых для конкретной группы пользователей. Для достижения сравнимой производительности реляционные системы требуют тщательной проработки схемы базы данных, определения способов индексации и специальной настройки. Ограничения SQL остаются реальностью, что не позволяет реализовать в реляционных СУБД многие встроенные функции, легко обеспечиваемые в системах основанных на многомерном представлении данных.
Основные преимущества многомерных СУБД
Общая простота системы, что позволяет осуществлять быстрое встраивание технологий многомерных СУБД в приложения. Системы на основе многомерных баз данных требуют меньше специальных навыков по разработке и администрированию;
Относительно низкая общая стоимость владения, а также быстрый возврат инвестиций;
В случае использования многомерных СУБД поиск и выборка данных осуществляется значительно быстрее, чем при многомерном концептуальном взгляде на реляционную базу данных, так как многомерная база данных обеспечивает оптимизированный доступ к запрашиваемым ячейкам;
Многомерные СУБД легко справляются с задачами включения в информационную модель разнообразных встроенных функций, тогда как объективно существующие ограничения языка SQL делают выполнение этих задач на основе реляционных СУБД достаточно сложным, а иногда и невозможным.
ERwin: сильные и слабые связи между сущностями. Операции прямого и обратного проектирования.
Связи между сущностями на ER‑диаграммах обозначаются следующим образом:


сильная или идентифицирующая связь типа 1 : М

слабая или неидентифицирующая связь типа 1 : М
связь типа М : М
В случае связи 1 : М (один ко многим) одна из связываемых сущностей выступает в роли родительской или главной, а другая – в роли дочерней или подчиненной. Эта связь каждому кортежу родительской сущности ставит в соответствие любое (в том числе нулевое) число кортежей дочерней сущности, однако каждый кортеж дочерней сущности может быть связан только с одним кортежем родительской сущности.
Механизм реализации связи «один ко многим» состоит в том, что в дочернюю сущность добавляются атрибуты, дублирующие ключевые атрибуты родительской сущности (т.е. атрибуты, входящие в первичный или альтернативный ключ). Эти атрибуты получают название внешнего ключа (Foreign Key, сокращенно FK) и с их помощью устанавливается связь между кортежами родительской сущности – с одной стороны – и подмножествами кортежей дочерней сущности – с другой. Еще такие атрибуты называют мигрирующими из родительской сущности. Если дочерняя сущность является зависимой от родительской сущности, то мигрирующие атрибуты включаются в состав первичного ключа дочерней сущности, в противном случае – в состав ее неключевых атрибутов.
53 Подготовка данных применительно к хранилищам данных
На этапе подготовки данных аналитик готовит набор данных, содержащий достаточно информации, для того чтобы создать точные модели на последующих этапах. В случае с FSC, точная модель должна помочь прогнозировать, с какой вероятностью клиент купит продукты, рекламируемые в новом каталоге. Поскольку эти прогнозы основаны на факторах, потенциально влияющих на покупки клиентов, множество данных в модели будет включать в себя всех клиентов, отреагировавших на рассылаемые по почте каталоги за последние три года, их демографическую информацию, десять самых дорогих продуктов, которые приобрел каждый клиент, а также информацию о каталоге, послужившем стимулом для этих покупок.
Подготовка данных может включать в себя сложные запросы с объемными результатами. К примеру, подготовка множества данных FSC предусматривает соединение таблицы клиентов и таблицы продаж, а также выявление 10 самых дорогих покупок для каждого клиента. Все эти вопросы, касающиеся эффективной обработки запросов для поддержки принятия решения, одинаково актуальны в контексте добычи данных. Фактически, платформы добычи данных используют реляционные серверы или серверы OLAP для решения своих задач по подготовке данных.
Как правило, добыча данных включает в себя итеративно создаваемые модели на основе подготовленного множества данных, а затем применение одной или нескольких моделей. Поскольку создание моделей на больших множествах данных может оказаться весьма дорогостоящим, аналитики часто сначала работают с несколькими выборками множества данных. Платформы добычи данных, таким образом, должны поддерживать вычисления на случайно выбранных экземплярах данных в сложных запросах.
54 Магазины (витрины) данных. Банки оперативных данных Красный – в рот я ебал такие вопросы
Витрина данных (англ. Data Mart; другие варианты перевода: хранилище данных специализированное, киоск данных, рынок данных) — срез хранилища данных, представляющий собой массив тематической, узконаправленной информации, ориентированный, например, на пользователей одной рабочей группы или департамента.
Концепция :
Концепция витрин данных была предложена Forrester Research ещё в 1991 году. По мысли авторов, витрины данных — множество тематических баз данных (БД), содержащих информацию, относящуюся к отдельным аспектам деятельности организации.
Концепция имеет ряд несомненных достоинств:
Аналитики видят и работают только с теми данными, которые им реально нужны.
Целевая БД максимально приближена к конечному пользователю.
Витрины данных обычно содержат тематические подмножества заранее агрегированных данных, их проще проектировать и настраивать.
Для реализации витрин данных не требуется высокомощная вычислительная техника.
Но концепция витрин данных имеет и очень серьёзные пробелы. По существу, здесь предполагается реализация территориально распределённой информационной системы с мало контролируемой избыточностью, но не предлагается способов, как обеспечить целостность и непротиворечивость хранимых в ней данных.
52. Хранилища данных. Их отличия от операционных баз данных
Хранилище данных — предметно-ориентированная информационная база данных, специально разработанная и предназначенная для подготовки отчётов и бизнес-анализа с целью поддержки принятия решений в организации. Строится на базе систем управления базами данных и систем поддержки принятия решений. Данные, поступающие в хранилище данных, как правило, доступны только для чтения.
Есть два варианта обновления данных в хранилище:
полное обновление данных в хранилище. Сначала старые данные удаляются, потом происходит загрузка новых данных. Процесс происходит с определённой периодичностью, при этом актуальность данных может несколько отставать от OLTP-системы;
инкрементальное обновление — обновляются только те данные, которые изменились в OLTP-системе.
Источниками данных могут быть:
Традиционные системы регистрации операций
Отдельные документы
Наборы данных
Операции с данными:
Извлечение — перемещение информации от источников данных в отдельную БД, приведение их к единому формату.
Преобразование — подготовка информации к хранению в оптимальной форме для реализации запроса, необходимого для принятия решений.
Загрузка — помещение данных в хранилище, производится атомарно, путем добавления новых фактов или корректировкой существующих.
Анализ — OLAP, Data Mining, сводные отчёты.
Представление результатов анализа.
OLAP — технология обработки данных, заключающаяся в подготовке суммарной (агрегированной) информации на основе больших массивов данных, структурированных по многомерному принципу. Реализации технологии OLAP являются компонентами программных решений класса Business Intelligence.
Причина использования OLAP для обработки запросов — скорость. Реляционные БД хранят сущности в отдельных таблицах, которые обычно хорошо нормализованы. Эта структура удобна для операционных БД (системы OLTP), но сложные многотабличные запросы в ней выполняются относительно медленно.
Существуют три типа OLAP:[2]
многомерная OLAP (Multidimensional OLAP — MOLAP);
реляционная OLAP (Relational OLAP — ROLAP);
гибридная OLAP (Hybrid OLAP — HOLAP).
MOLAP — классическая форма OLAP, так что её часто называют просто OLAP. Она использует суммирующую БД, специальный вариант процессора пространственных БД и создаёт требуемую пространственную схему данных с сохранением как базовых данных, так и агрегатов.
ROLAP работает напрямую с реляционным хранилищем, факты и таблицы с измерениями хранятся в реляционных таблицах, и для хранения агрегатов создаются дополнительные реляционные таблицы.
HOLAP использует реляционные таблицы для хранения базовых данных и многомерные таблицы для агрегатов.
Особым случаем ROLAP является "ROLAP реального времени" (Real-time ROLAP — R-ROLAP). В отличие от ROLAP в R-ROLAP для хранения агрегатов не создаются дополнительные реляционные таблицы, а агрегаты рассчитываются в момент запроса. При этом многомерный запрос к OLAP-системе автоматически преобразуется в SQL-запрос к реляционным данным