Материал: шпоры бд
Управление резервным копированием и восстановлением данных в субд.
СУДБ содержит специальные утилиты, с помощью которых администратор БД может выполнять регулярные и экстренные процедуры резервного копирования и восстановления данных.
Восстановление данных происходит в следующих 2-х случаях:
аварийный отказ аппаратуры (жесткий сбой системы)
В этом случае данные повреждаются физически.
После аварийного отказа ПО (мягкий сбой системы)
Мягкий сбой системы характеризуется утратой оперативной памяти, но данные, хранящиеся на диске, остаются неповрежденными.
Для восстановления данных, необходимо, чтобы они сохранялись в БД с некоторой избыточностью, позволяющей восстановить то состояние, которое было перед сбоем. Такую избыточность обеспечивают полная активная копия БД и журнал транзакций.
Журнал транзакций содержит перечень всех транзакций, выполненных после создания последней архивной копии данных с описанием всех деталей каждой транзакции.
Полная архивная копия БД создается практически с учетом скорости накопления журнала транзакций и, как правило, размещается на другом сетевом диске.
Для восстановления данных, поврежденных в результате жесткого сбоя системы, используют последнюю по времени полную архивную копию БД и журнал транзакций.
Восстановление данных состоит в том, что исходя из полной архивной копии, по журналу транзакций последовательно воспроизводится работа всех поврежденных транзакций.
В результате БД восстанавливается в то состояние в котором, в котором она была перед повреждением.
Восстановление данных после мягкого сдоя системы осуществляется как часть процедуры перезагрузки системы.
При перезагрузки системы транзакции подвергаются анализу для выявления завершившихся транзакций и транзакций, прерванных из-за сбоя.
Транзакции, подтвержденные до наступления сбоя, но результат выполнения которых не записан на диск, выполняются заново.
Транзакции, незавершившиеся из-за сбоя, и транзакции, результат которых записан на диск, откатываются.
Самым плохим случаем является ситуация, когда разрушены физически и БД и журнал транзакций.
Единственно, что можно сделать, это восстановить состояние БД на момент резервного копирования.
Чтобы не допустить возникновения такой ситуации, БД и журнал транзакций необходимо размещать на физически разных дисках, упр-х физически разными контролями.
Механизм тиражирования (репликации) данных в субд.
Работа распределенной БД базируется над синхронной фиксацией изменений сразу на нескольких узлах системы, что предъявляет жесткие требования к производительности и надежности каналов.
Реальная альтернатива – технология тиражирования данных, не требующая синхронной фиксации изменений.
Действительно, далеко не всегда требуется поддерживать идентичность БД на различных узлах в любое время – достаточно это делать лишь в определенные критические моменты времени. Можно накапливать изменения на одном узле в виде последовательности транзакций и периодически копировать эти изменения на другие узлы. Эти функции выполняют специальные модули СУБД – репликаторы.
Его задача – автоматически синхронизировать БД, распр-ой системы и тем самым обеспечивать актуальность их копий, или как их называют реплик.
Поддержка репликации баз данных – одна из важнейших задач администратора: почти у каждой сколько-нибудь важной базы данных есть реплика, а то и не одна. Среди задач, решаемых репликацией, можно назвать как минимум
поддержку резервной базы данных на случай потери основной;
снижение нагрузки на базу за счёт переноса части запросов на реплики;
перенос данных в архивные или аналитические системы. Можно выделить три подхода к репликации:
Блочная репликация на уровне системы хранения данных;
Физическая репликация на уровне СУБД;
Логическая репликация на уровне СУБД.
Назначение и функции субд.
Основные функции СУБД
управление данными во внешней памяти (на дисках);
управление данными в оперативной памяти с использованием дискового кэша;
журнализация изменений, резервное копирование и восстановление базы данных после сбоев;
поддержка языков БД (язык определения данных, язык манипулирования данными).
Программное обеспечение, предназначенное для работы с базами данных, называется система управления базами данных (СУБД). СУБД используются для упорядоченного хранения и обработки больших объемов информации.
СУБД организует хранение информации таким образом, чтобы ее было удобно:
просматривать,
пополнять,
изменять,
искать нужные сведения,
делать любые выборки,
осуществлять сортировку в любом порядке.
Системы управления базами данных (СУБД) используются для упорядоченного хранения и обработки больших объемов информации. В процессе упорядочения информации СУБД генерируют базы данных, а в процессе обработки сортируют информацию и осуществляют ее поиск. Информация в базах данных структурирована на отдельные записи, которыми называют группу связанных между собой элементов данных. Характер связи между записями определяет два основных типа организации баз данных: иерархический и реляционный. В иерархической базе данных записи упорядочиваются в определенную последовательность, как ступеньки лестницы, и поиск данных может осуществляться последовательным «спуском» со ступени на ступень. Иерархическая база данных по своей структуре соответствует структуре иерархической файловой системы. Реляционная база данных, по сути, представляет собой двумерную таблицу. Под записью здесь понимается строка двумерной таблицы, элементы которой образуют столбцы таблицы. В зависимости от типа данных столбцы могут быть числовые, текстовые или содержать дату. Строки таблицы нумеруются. Работа с СУБД начинается с создания структуры базы данных, т. е. с определения: • количества столбцов; • названий столбцов; • типов столбцов (текст/число/дата); • ширины столбцов.
Управление словарем данных и обеспечение безопасности данных в субд.
Словарь данных предназначен для хранения метаданных, т.е. описаний структур и свойств данных и их взаимосвязи, дат создания объектов БД, списка авторизованных пользователей и т. д.
Т. к. любые программы получают доступ к БД через СУБД, то использование словаря данных упрощает разработку прикладных программ за счет использования уже имеющихся стандартов организации и именования данных.
Управление хранением, преобразованием и представлением данных
СУБД создает сложные структуры, необходимые для хранения данных, освобождая пользователя от знания деталей их физического представления в памяти компьютера.
Кроме того СУБД преобразует запросы пользователя в команды, обеспечивающие определение физического местоположения нужной информации, ее извлечение, обработку и форматирование с целью предания вида, удобного для чтения.
Современ. СУБД обеспечивают не только хранение данных, но и связанных с ними экранных форм, отчетов, правил проверки данных, систем обработки видеоинформации и мн. др.
Обеспечение безопасности данных
СУБД создает систему, которая обеспечивает защиту и конфиденциальность пользовательских данных, содержащихся в БД.
Правила безопасности устанавливают: какие пользователи могут получить доступ к БД, а также какие операции разрешено выполнить тому или иному пользователю над конкретными объектами БД. Такие разрешенные операции называются привилегиями.
Установка, контроль и снятие привилегий – администратор БД.
... WHERE index_part1=1 OR index_part2=10
/* Нет индекса, покрывающего все строки*/
В некоторых случаях MySQL не использует индекс, даже если это возможно. Несколько примеров таких ситуаций приведено ниже:
Если использование индекса требует от MySQL прохода более чем по 30% строк в данной таблице (в таких случаях просмотр таблицы, по всей видимости, окажется намного быстрее, так как потребуется выполнить меньше операций поиска). Следует учитывать, что если подобный запрос использует LIMIT по отношению только к извлекаемой части строк, то MySQL будет применять индекс в любом случае, так как небольшое количество строк можно найти намного быстрее, чтобы вернуть результат.
Если диапазон изменения индекса может содержать величины NULL при использовании выражений ORDER BY ... DESC.
Обеспечение целостности данных в субд.
В СУДБ предусмотрены средства обеспечения целостности данных, что позволяет постоянно поддерживать СУБД в вирт. состоянии.
Обеспечение целостности данных основано на использовании механизма транзакций при выполнении различных операции с объектами БД.
Транзакция - последовательность выполнения операций в БД, которая рассматривается как некоторое неделимое действие, осмысленное с т. зр. пользователя.
Можно сказать, что транзакция – лог. 1 работы системы, которая реализует некоторую прикладную функцию, например перевод денег с одного счета на другой в банковской системе.
Если все операции, составляющие транзакцию, успешно выполняются, то СУБД фиксирует в БД изменения, произведенные этой транзакцией.
В этом случае говорят, что транзакция подтверждается или фиксируется.
Если хотя бы одна из операций не будет выполнена, то БД останется в том же состоянии, что и перед началом выполнения транзакции, т. е. все операции, составляющие транзакцию отменяются и транзакция соответственно не подтверждается (отказывается).
Т. о. операции с БД выполняются только в рамках транзакции, каждая из которых переводит БД из одного целостного состояния в другое.
Управление многопользовательским доступом к данным в субд.
СУБД включает в себя средства, обеспечивающие доступ к данным нескольким пользователям одновременно без нарушения целостности данных.
В основе этого лежат механизмы транзакции и блокировки.
Транзакция - последовательность выполнения операций в БД, которая рассматривается как некоторое неделимое действие, осмысленное с т. зр. пользователя.
Механизм блокировки заключается в том, что если несколько пользователей хотят одновременно изменить одни и те же данные, то только транзакция первого пользователя получит доступ к общему ресурсу, а остальные транзакции будут ждать, пока она не завершится и не разблокирует этот ресурс. После чего начнет выполняться след. транзакция и т. д.
Транзакции и блокировки тесно связаны друг с другом.
Блокировки являются тем механизмом, которые обеспечивают независимость транзакций друг от друга. Однако использование блокировок существенно замедляет процесс обработки транзакций из-за необходимости ожидания, когда освободятся данные, захваченные конкурирующей транзакцией.
Эти задержки можно снизить, снизив размеры фрагментов данных, захватываемые транзакцией.
В частности, можно блокировать сразу всю БД (неприемлемый вариант), таблицу, часть таблицы (страницу), отдельную строку. Все эти варианты известны под названием «уровни блокировки».
Большинство СУДБ использую блокировки на уровне страниц или строк. Т. к. размер страниц невелик, то время ожидания транзакции для доступа к странице оказывается вполне приемлемым.
Наивысшую производительность обеспечивают блокировки на уровне строк, т. к. используется наим. Возможный размер блокируемого ресурса.
Блочная репликация
При блочной репликации каждая операция записи выполняется не только на основном диске, но и на резервном.
Физическая репликация
Идея физической репликации состоит в том, что изменения из журналов повторно выполняются в другой базе (реплике), и таким образом данные в реплике повторяют данные в основной базе байт-в-байт.
Логическая репликация
репликация триггерами;
использование журналов СУБД;
использование программного обеспечения класса CDC (change data capture);
прикладная репликация.
Типы баз данных.
Как я уже говорил, видов и типов баз данных очень и очень много и описать их все в данной публикации я просто не смогу, но самые распространенные виды хранения информации или виды баз данных я постараюсь описать. Понятно, что база данных хранит в себе информацию о каких-то объектах, например, информацию о товаре в интернет-магазине. Любой товар в базе данных – это объект с какими-то определенными параметрами и свойствами. Перейдем к конкретным примерам.
Иерархическая база данных, структура иерархических баз данных
Иерархическая база данных – каждый объект при таком хранение информации представляется в виде определенной сущности, то есть, у этой сущности могут быть дочерние элементы, родительские элементы, а у тех дочерних могут быть еще дочерние элементы, но есть один объект, с которого все начинается. Получается своеобразное дерево. Примером иерархической базы данных может быть, документ в формате XML или файловая система компьютера, пример с файловой системой компьютера я приводил, когда рассматривал структуру XML документа, в рубрике Заметки о XML.
Следует сказать, что базы данных подобного вида оптимизированы под чтение информации, то есть, базы данных, имеющие иерархическую структуру умеют очень быстро выбирать, запрашиваемую информацию и отдавать ее пользователям. Но такая структура не позволяет столь же быстро перебирать информацию, тут можно привести пример из жизни, компьютер может легко работать с каким-либо конкретным файлом или папкой (которые, по сути являются объектами иерархической структуры) но проверка компьютера антивирусам осуществляется очень долго. Второй пример – реестр Windows.
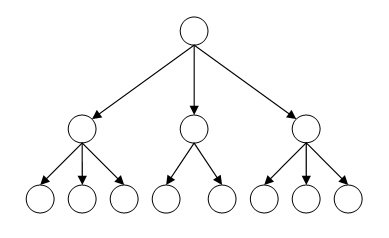
На рисунке вы можете увидеть структуру иерархической базы данных, в самом верху находится родитель или корневой элемент, ниже находятся дочерние элементы, элементы, находящиеся на одном уровне называются братьями, ну или соседними элементами. Соответственно чем ниже уровень элемента, тем вложенность этого элемента больше.
Сетевая база данных, структура сетевых баз данных
Сетевые базы данных, являются своеобразной модификацией иерархических баз данных. Если вы внимательно смотрели на рисунок выше, то наверное обратили внимание, что к каждому нижнему элементу идет только одна стрелочка от верхнего элемента. То есть у иерархических баз данных у каждого дочернего элемента может быть только один потомок. Сетевые базы данных отличаются от иерархических тем, что у дочернего элемента может быть несколько предков, то есть, элементов стоящих выше него. Для большей наглядности и понимания структуры сетевых баз данных обратите внимание на рисунок:
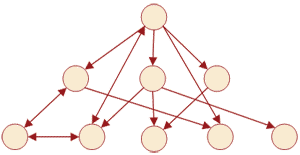
Стоит заметить, что сетевые базы данных обладают примерно теми же характеристиками, что и иерархические базы данных. Но, в данной рубрике нас не сильно интересуют иерархические и сетевые базы данных, данная тема больше относится кформату XML, и возможно в рубрике посвященной языку расширяемой разметки, я постараюсь более подробно рассмотреть эту тему. А в рубрике посвященной MySQL нас интересуют реляционные базы данных, на которых мы и остановимся более подробно.