Дипломная (вкр): Система психолингвистического анализа текстов
Формирование предложений по автоматизации бизнес-процессов
С целью не только решить существующие проблемы отдела, но и внести изменения, повышающие качество проводимых анализов, было решено изучить рынок программных продуктов, успешно внедренных в других компаниях.
В настоящее время на рынке существуют различные программы психолингвистического анализа текстов, основанные на подходах, которые по-разному используют разные методы содержательного анализа текстов. Так, например, программы, основанные на информационном подходе (И.Р. Галыгерин, Н.И. Жинкин, Л.П. Доблаев, Т.М. Николаева, А.И. Новиков, 3.Я. Тураева, Л.А. Черняховская) осуществляют содержательный анализ целого текста, внутреннего строения и иерархии его единиц в соответствии с логикой внеязыковых предметных отношений [15]. Программы, основанные на когнитивном подходе (А.Г. Баранов, Е.С. Кубрякoва, Г.Г. Молчанова, М.А. Шахиарович, Т. ван Дейк, В. Кинч), предполагают анализ информационной структуры текста в соответствии с системой разнообразных знаний, мнений и наблюдений в рамках конкретной речевой деятельности [16]. Для оценки подобного соответствия вводятся понятия макроструктуры, когниотипа, модели ситуации, концепта, фрейма и пр. Программы, основанные на антропоцентрическом подходе, расширяют представления о соответствии информационной структуры когнитивным процессам, подчиняя их в денотатной иерархии эмоциям и мотивам субъекта (E. W. T. V. Kneepkens, R. A. Zwaan). В настоящее время широкое распространение получили программы, основанные на подходе, рассматривающем текст как источник самодостаточных единиц анализа - концептов, в которых заключаются "свернутые" представления, отражающие объекты как предметной, так и психической, социальной (культурной) действительности (А. Вежбицкая, В.И. Карасик, Д.С. Лихачев, С.Х. Ляпин, Ю.С. Степанов) [3].
Одним из примеров успешного выхода на рынок программ подобного рода является пример ВААЛ-2000, основанная на информационном подходе.
Система ВААЛ, работа над которой ведется с 1992 года, позволяет прогнозировать эффект неосознаваемого воздействия текстов на массовую аудиторию, анализировать тексты с точки зрения такого воздействия составлять тексты с заданным вектором воздействия и выявлять личностно-психологические качества авторов текста.
В настоящее время пользователями системы является ряд крупных банков, рекламных компаний, издательских компаний, газет, коммерческих фирм. Она нашла успешное применение при проведении кампаний по выборам депутатов Государственной Думы 1993, 1995 и 1999 годов, выборов Президента России в 1996 году. Также систему ВААЛ используют в исследовательских целях психологи, психотерапевты, лингвисты, практики НЛП. Во многом возможности ее практического применения ограничены лишь богатством фантазии людей [7].
Результаты проведенного исследования рынка приведены в
таблице 1.
Таблица 1
Сравнительная характеристика систем-аналогов
Название
Достоинства
Недостатки
ВААЛ-2000
- Система реализована в виде набора
DLL-библиотек, которые подключаются к текстовому процессору Microsoft Office
Word.
- Для бесплатной загрузки доступна только
старая DOS-версия системы образца 1995 года.
ПСИ-Офис
- Поддержка русского (словарь 690 тыс. слов) и
английского (словарь 430 тыс. слов) языков.
- Устаревшая, работает только в Windows
9x/2000/NT, новых версий не выпускалось.
Приемы журналистики & Public Relations
- В основе программы - анализ 12500 текстов
мастеров русского языка, начиная от писателей-классиков и заканчивая
современными журналистами и политиками.
- В программе отсутствуют возможности анализа
написанного Пользователем текста; для бесплатной загрузки доступна только
старая версия системы образца 2000 года.
Фоносемантический анализ фамилии
-Выявление подсознательного мнения об имени и
фамилии.
- Крайне узкая направленность.
Все вышеперечисленные программы являются бесплатными только в
урезанных и устаревших версиях, полные и обновленные версии программного
продукта крайне дорого стоят. За два десятилетия интерфейс программ практически
не изменился, поэтому является крайне неудобным, таким образом, у пользователя,
не обладающего знаниями лингвистики, возникнут проблемы при использовании
программы.
Система психолингвистический анализ текстов позволяет решить
данные проблемы, обладает удобным интерфейсом и позволяет анализировать тексты
любой направленности.
Основной целью проекта автоматизации является сокращение
затрат на оплату труда высокооплачиваемых специалистов за счет сокращение
времени их работы над исследованием. Для достижения поставленной цели должны
быть решены следующие задачи:
¾ Предоставить возможность
загружать в системы тексты разных форматов;
¾ Предоставить возможность
пакетной обработки текстов;
¾ Предоставить возможность
автоматического формирования отчетов.
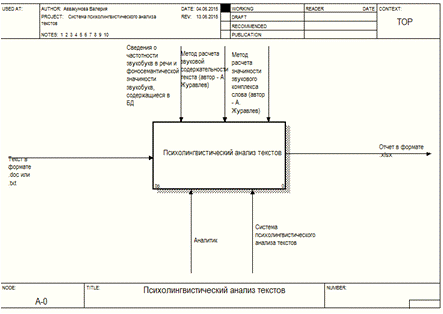
На рисунке 5 изображена контекстная диаграмма бизнес-процесса
"Как должно быть", то есть как должны выглядеть процессы после
проведения автоматизации. Вход в систему изменился тем, что теперь анализу
подвергаются тексты конкретного формата (. doc или. txt), однако теперь вся
работа с данными выполняется с помощью системы психолингвистического анализа
текстов. Необходимость в использовании справочных материалов по стилистике и
фоносемантике отпала. Более того часть задач теперь может выполнять обычный
пользователь (который условно назван "Аналитик"), не имеющий знаний в
области лингвистики. На выходе появляется автоматически сгенерированный отчет в
формате. xslx.
Рисунок 5. Контекстная диаграмма "Как должно быть".
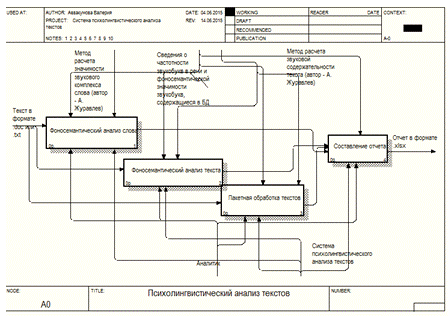
Для более глубокого понимания, как изменились протекающие
процессы, проведем декомпозицию (результат смотреть на рис. 6). На рисунке
видно, что теперь психолингвистический анализ текстов разделился на четыре
подпроцесса: фоносемантический анализ слова, фоносемантический анализ текста,
пакетная обработка текстов и составление отчета.
Рисунок 6. Декомпозиция контекстной диаграммы.
Чтобы понять, какие работы стоят за каждым процессом, была
проведена декомпозиция каждого из них в нотации IDEF3. Декомпозицию процесса
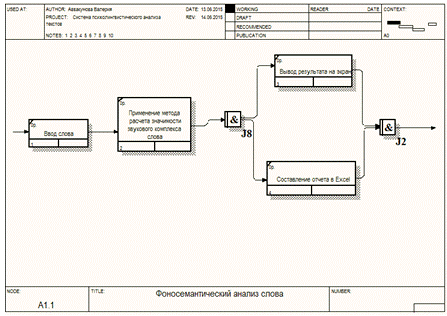
фоносемантического анализа слова можно увидеть на рисунке 7. В систему
необходимо ввести слово, к нему применяется метод расчета значимости звукового
комплекса слова, после чего результаты анализа выводятся на экран или, по
запросу пользователя, формируется отчет в Excel.
Рис. 7. Декомпозиция процесса "Фоносемантический анализ
слова".
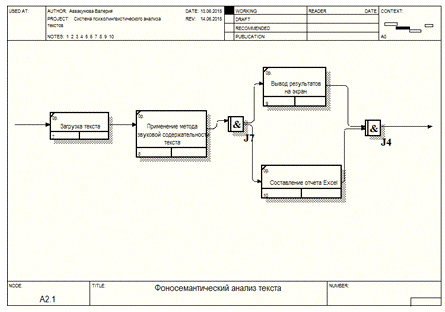
На рисунке 8 изображена декомпозиция процесса
фоносемантического анализа текста. В систему необходимо загрузить текст, к нему
применяется метод звуковой содержательности текста, после чего результаты
анализа выводятся на экран или, по запросу пользователя, формируется отчет в
Excel.
Рисунок 8. Декомпозиция процесса "Фоносемантический
анализ текста".
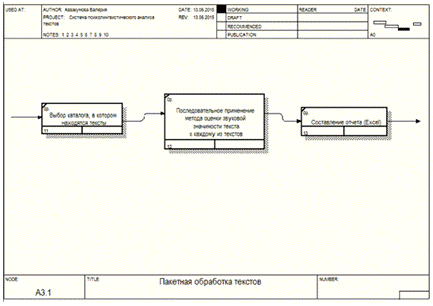
Рисунок 9 изображает последовательность работ, которые
необходимо выполнить для пакетной обработки текстов. Для начала необходимо
выбрать каталог, в котором находятся тексты для анализа. После чего ко всем
текстам каталога последовательно применяется метод звуковой содержательности
текста, и формируется отчет в Excel.
Рисунок 9. Декомпозиция процесса "Пакетная обработка
текста".
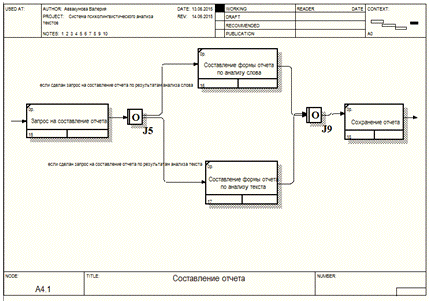
Декомпозиция процесса составления отчета представлена на
рисунке 10. В систему поступает запрос на формирование отчета.
В зависимости от того, на что сделан запрос - формирование
отчета по результатам анализа слова или текста, программа составляет отчет
соответствующей формы.
Рисунок 10. Декомпозиция процесса "Составление
отчета".
Система предъявляет следующие требования к обеспечению:
а) информационному: для функционирования системы
необходимо наличие базы данных формата MS Access;
б) лингвистическому: для написания системы
использовался язык программирования C#. Изменение исходных кодов не
рекомендуется, в случае возникновения проблем обращаться к разработчику;
в) программному и техническому: для работы с системой
требуется компьютер со следующими характеристиками:
) техническое обеспечение:) операционная система: MS Windows
95/2000/XP/7/8/8. 1;) процессор Intel Pentium III 866 МГц;) оперативная память
256 Мбайт;
) программное обеспечение:) MS Access;) платформа.net
Framework 4. 0;) офисный пакет приложений Microsoft Office.
К пользовательским требованиям относится следующее:
1) надежность:) аппаратных и
программных средств должна обеспечиваться за счет предварительного обучения
пользователей и обслуживающего персонала;
b) своевременного
выполнения процессов администрирования;) соблюдения правил эксплуатации и
технического обслуживания программно-аппаратных средств;) своевременная
подготовка критических обновлений системы.
2) Эргономика и техническая эстетика: подсистема сбора и
подготовки данных к обработке должна обеспечивать удобный для пользователя
интерфейс, отвечающий следующим требованиям:) интерфейсы подсистем должны
быть типизированы;
b) должно быть обеспечено наличие локализованного
(русскоязычного) интерфейса пользователя;) при возникновении ошибок в работе
подсистемы на экран монитора должно выводиться сообщение с наименованием ошибки
и с рекомендациями по её устранению на русском языке.
Ниже представлены вспомогательные для выбора наиболее
подходящей модели жизненного цикла программного продукта.
Таблица 2
Выбор модели ЖЦ в зависимости от характера требований к
системе
Характеристика требований
Модель
Каскадная
Макетирование
Инкрементная
Спиральная
RAD
Являются ли требования легко определимыми и/или
хорошо известными?
Да
Нет
Нет
Нет
Да
Могут ли быть требования заранее определены?
Да
Нет
Да
Нет
Да
Часто ли будут изменяться требования?
Нет
Да
Нет
Да
Нет
Нужно ли демонстрировать требования с целью их
определения?
Нет
Да
Нет
Да
Да
Требуется ли для демонстрации возможностей
проверка концепции?
Нет
Да
Нет
Да
Нет
Будут ли требования отражать сложность системы?
Нет
Да
Да
Да
Нет
Отражают ли требования на раннем этапе
функциональные свойства системы?
Нет
Да
Да
Да
Да
Таблица 3
Выбор модели ЖЦ на основе характеристик типа проектов и
рисков
Характеристика типа проекта и рисков
Модель
Каскадная
Макетирование
Инкрементная
Спиральная
RAD
Будет ли проект идентифицировать новое
направление продукта для организации?
Нет
Да
Да
Да
Нет
Будет ли проект иметь тип системной интеграции?
Нет
Да
Да
Да
Да
Будет ли проект являться расширением
существующей системы?
Нет
Нет
Да
Нет
Да
Будет ли финансирование проекта стабильным на
всем протяжении жизненного цикла?
Да
Да
Нет
Нет
Да
Ожидается ли длительная эксплуатация продукта в
организации?
Да
Нет
Да
Да
Нет
Должна ли быть высокая степень надежности?
Нет
Нет
Да
Да
Нет
Будет ли система изменяться, возможно, с
применением непредвиденных методов, на этапе сопровождения?
Нет
Да
Да
Да
Нет
Является ли график ограниченным?
Да
Да
Да
Да
Являются ли "прозрачными"
интерфейсные модули?
Да
Нет
Да
Нет
Нет
Доступны ли повторно используемые компоненты?
Нет
Да
Нет
Да
Да
Являются ли достаточными ресурсы (время,
деньги, инструменты, персонал)?
Нет
Да
Нет
Да
Нет
Выбор модели жизненного цикла разработки зависит от
характеристики требований к проекту, его типа и рисков. Чтобы определить, на
сколько подходит конкретная модель ЖЦ для разработки проекта, проставляются
баллы. Обоснование проставленных баллов представлено в таблицах 2 и 3. В
результате подсчета баллов по всем характеристикам была выбрана инкрементная
модель (9 баллов).
При разработке любого программного продукта разработчик будет
вынужден столкнуться с определенными ограничениями и рисками. Целью
нижеприведенного анализа является учет потенциальных временных потерь. Это
позволит подготовить календарный план, исходя из реальной, а не идеальной
ситуации, тем самым снизив вероятность невыполнения сроков. Анализ рисков
приведен в таблице 4.
Таблица 4
Оценка рисков проекта
Наименование риска
Влияние риска, %
Вероятность риска, %
Техника управления риском
Приоритет
Временные потери в днях
Неверный выбор языка программирования
30%
5-10%
Внимательнее изучение особенностей задачи и
возможностей языка.
1
10-20 дней
Неверно сформулированные требования
20%
20-30%
Увеличение числа контактов с заказчиком,
подготовка макетов для уточнение требований заказчика к системе.
2
До 10 дней
Ошибочно спроектированный интерфейс
10%
10-20%
Провести дополнительный анализ требований
пользователей, чаще демонстрировать макеты интерфейса.
4
1 день
Временная нетрудоспособность разработчика
5%
5-10%
Соблюдение техники безопасности на рабочем
месте и на территории организации.
3
До 5 дней
Недостаточные знания технологий
программирования
35%
30-40%
Дополнительное изучение технической литературы,
ознакомление с официальной технической документацией, обращение на
тематические форумы.
2
5-10 дней
Шкала оценки воздействия отражает значимость риска (таблица
4) в случае его возникновения. Она может изменяться в зависимости от сложности
выполнения проектов, количества разработчиков в команде, важности архитектуры
системы. Чем сложнее система, тем опаснее для нее риски. Например, ошибки при
проектировании архитектуры распределенного приложения может привести к полной
ее непригодности, и, как результат, полной переработке проекта с нуля.
Таблица 5
Шкала оценки воздействия риска
1
Катастрофа
> 20 дней
2
Критично
> 3 дня
3
Проблема
> 1 дня
4
Возможно игнорирование
< 1 дня
В соответствии с выбранной моделью жизненного цикла и
определенными в предыдущем пункте возможными потерями дней из-за возникновения
рисков представлен календарный план в таблице 6.
Таблица 6
График календарного плана сдачи этапов жизненного цикла
Этап жизненного цикла Системное планирование и анализ
Техническое задание
01. 04.2015 - 15. 04.2015
Выбор модели ЖЦ ПО
16. 04.2015 - 20. 04.2015
Системный анализ и проектирование
Проектирование системы
06. 04.2015 - 30. 04.2015
Конструирование и тестирование
Конструирование ПО
01. 05.2015 - 18. 05.2015
Тестирование ПО
19. 05.2015 - 22. 05.2015
Документирование и оценка ПО
Документирование ПО
23. 05.2015 - 10. 06.2015
Оценка качественных характеристик ПО
23. 05.2015 - 25. 05.2015
Оценка трудоемкости разработки ПО
01. 06.2015-05. 06.2015
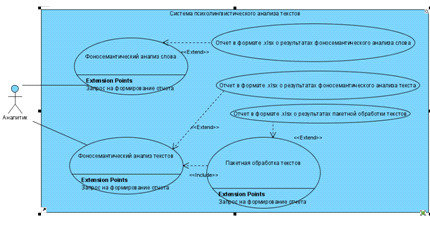
Рисунок 11. Диаграмма вариантов использования.
На рисунке 11 представлена Use Case диаграмма в нотации UML.
На диаграмме наглядно представлено какой функционал системы доступен.
Функции фоносемантического анализа слов и текстов и пакетной
обработки текстов расширяют функции составления отчетов о результатах
соответствующего анализа.
Для наиболее удобного конструирования системы и ее
дальнейшего функционирования было принято решение для работы с данными
использовать технологию ADO.net, являющейся наиболее удобной для работы с
базами данных Microsoft Access. Для извлечения данных из БД было использовано
пространство имен System. Text. RegularExpressions содержит классы,
обеспечивающие доступ к обработчику регулярных выражений платформы.net
Framework. Пространство имен обеспечивает функциональные возможности регулярный
выражений, которые могут быть использованы из любой платформы или языка,
работающих в рамках Microsoft.net Framework.
В базе данных содержатся две самостоятельные таблицы,
составленные на основе исследований А. Журавлева: "Частотность"
(содержит поля: Код (число), Звук (текст), Частотность (число)), в которой
указано, сколько раз в среднем на тысячу звукобукв встречается каждая звукобуква
в обычной разговорной речи, и "Значимость" (содержит поля: Код
(число), Буква (текст), Значение (число), Признак (текст)) [5].
Частотность звука и его информативность
("заметность") находятся в обратной зависимости. Отсюда следует, что
в слове наименее информативен звук с максимальной частотностью, а все остальные
звуки во столько раз информативнее, во сколько раз их частотность меньше
максимальной для звуков данного слова [5].
Значит, при расчете фонетической значимости звукового
комплекса слова нужно увеличить вес средних оценок не только для первого и
ударного звуков, но и для всех звуков, кроме максимально частотного в слове.
Иначе говоря, нужно считать не просто среднее арифметическое
средних оценок всех звуков слова, а сначала приписать каждому звуку свой вес,
свой весовой коэффициент, в зависимости от места в слове и частотности, а уже
затем вычислять среднее арифметическое [3].
Так, если частотность любого (i-того) звука слова обозначить
как Pi, а максимальную частотность звука в данном слове как Pmax,
то коэффициент, учитывающий разницу частотностей звуков слова (ki),
можно вычислить как отношение:
Теперь нужно учесть место каждого звука в слове. Для этого
коэффициент первого звука слова (k1) увеличим в четыре раза:
А для ударного (kуд) - в два раза:
После всех этих приготовлений можно сконструировать формулу
для теоретического расчета фонетической значимости слова:
Где F - фонетическая значимость слова; fi -
фонетическая значимость очередного (i-тoro) звука слова; ki -
коэффициент для очередного (i-того) звука [1].
Но как из получившейся оценки понять, в какую сторону по
шкале двигается оценка?
На основании исследований Журавлева ясно, что если оценка
попадает в диапазон (1; 2,5) - ставим положительную оценку (например, по шкале
"красивый-отталкивающий" это будет красивый), [2,5 до 3,5] - не
учитываем оценку по данной шкале в общей оценке, [3,5; ∞) - ставим
отрицательную оценку (по шкале "красивый-отталкивающий" это будет
отталкивающий) [5].
Всего исследования проведены по 25 шкалам. Введенное слово
нужно оценить по каждой из этих шкал последовательно. Учитываются только те
оценки, которые попадают в зоны существенных отклонений, т.е. которые либо
меньше 2,5, либо больше 3,5. Если оценка попадает в нейтральную зону, ее
результат не выводится вообще (т.е. оценка слова по данной шкале не имеет
значительной фонетической значимости).
При проведении оценки текста используются те же таблицы базы
данных и показатели, что и для анализа слова, однако дополнительно необходимо
еще подсчитать количество каждой звукобуквы в тексте, границы колебаний
частотностей звукобукв (по законам теории вероятностей и статистики нормальные
колебания не превышают ±2σ), выразить через σ отклонения частотностей звукобукв в тексте от нормальных,
посчитать общие суммы положительных и отрицательных отклонений. Если в тексте
модуль суммы положительных отклонений больше отрицательных, то в качестве
оценки текста берется положительный признак соответствующей шкалы, наоборот -
отрицательный. Журавлев в своих исследованиях не проводит зависимости между
границей нейтральности оценок и количеством символов анализируемого текста,
однако в ходе проведенных в результате проектирования и тестирования системы
экспериментов, было установлено, что при анализе текста с количеством символов
меньшим или равным 1000, учитываются отклонения, превышающие ±1σ, и с увеличением количества символов в тексте на тысячу эта
граница увеличивается на |1| как в положительном, так и в отрицательном
направлениях.
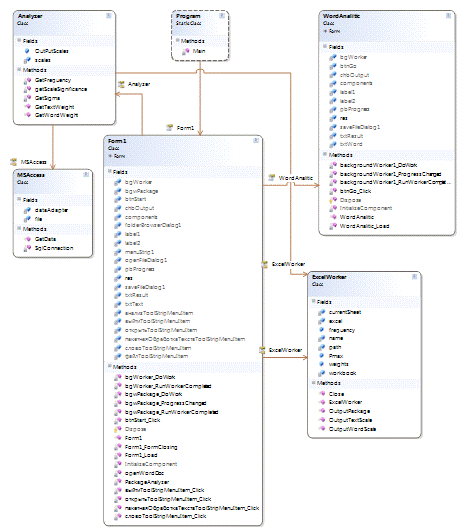
На рисунке 12 представлена диаграмма классов разрабатываемого
модуля.
Класс Program является классом входа в систему, Form1 отвечает
за вспомогательные методы анализа текстов, Analyzer - класс, содержащий
основные методы анализа текстов, WordAnalitic содержит методы для реализации
анализа слов, ExelWorker отвечает за выгрузку данных и формирование отчетов в
Excel, а MSAcces - за корректную работу БД.
Рисунок 12. Диаграмма классов.
Все алгоритмические задачи и базовый функционал вынесен в
отдельные классы. Такая структура делает систему более гибкой и адаптивной.
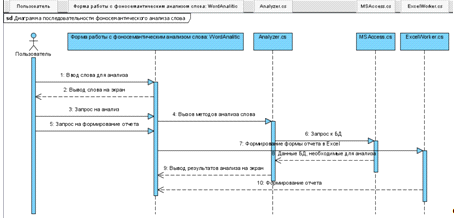
На рисунке 13 представлена диаграмма последовательности
фоносемантического анализа слова. Пользователь вводит слово для анализа, а
система, в свою очередь, вызывает методы анализа слова, извлекает необходимые
для математических расчетов данные из БД, формирует отчета формата. xlsx.
Рисунок 13. Диаграмма последовательности фоносемантического
анализа слова.
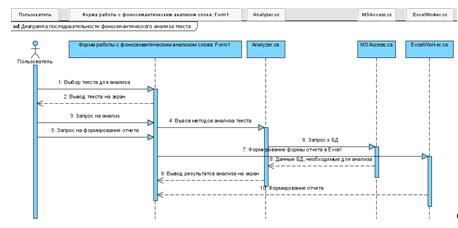
Рисунок 14. Диаграмма последовательности фоносемантического
анализа текста.
На рисунке 14 представлена диаграмма последовательности
фоносемантического анализа текста. Пользователь загружает текст для анализа, а
система, в свою очередь, вызывает методы анализа слова, извлекает необходимые
для математических расчетов данные из БД, формирует отчета формата. xlsx.
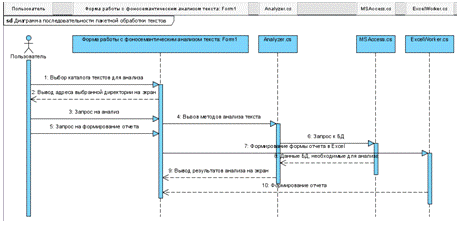
Рисунок 15. Диаграмма последовательности пакетной обработки
текстов.
На рисунке 15 представлена диаграмма последовательности
пакетной обработки текстов. Пользователь выбирает директорию, содержащую тексты
для анализа, а система, в свою очередь, вызывает методы анализа слова,
извлекает необходимые для математических расчетов данные из БД, формирует
отчета формата. xlsx.
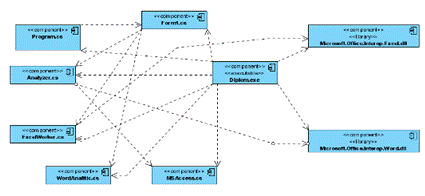
Рисунок 16. Диаграмма компонентов модуля.
На рисунке 16 представлена диаграмма компонентов системы.
Каждый разработанный класс находится в отдельном файле с расширением".
cs". Система взаимодействует с внешними библиотеками Microsoft. Office.
Interop. Word и Microsoft. Office. Interop. Excel для организации корректной
загрузки текстов в форматах. doc и. docx и вывода отчетов в формате. xlsx.
При работе с системой психолингвистического анализа текстов
на рабочем месте аналитика разворачивается исполняемая среда MS Access, через
которую осуществляется работа с базой данных.
Для осуществления математических расчетов методов расчета
значимости звукового комплекса слова и оценки звуковой содержательности
необходимо использование достаточно большого перечня параметров, которые
хранятся в БД MS Access. Работа с БД организована с использованием технологии
ADO.net..net - технология, предоставляющая доступ к данным для приложений,
основанных на Microsoft.net. Является не развитием более ранней технологии ADO,
а самостоятельной технологией, частью фреймворка.net. В отличие от классической
ADO, которая была в основном предназначена для тесно связанных клиент-серверных
систем, ADO.net больше нацелена на автономную работу с помощью объектов
DataSet. Эти типы представляют локальные копии любого количества
взаимосвязанных таблиц данных, каждая из которых содержит набор строк и
столбцов. Объекты DataSet позволяют вызывающей сборке работать с содержимым
DataSet, изменять его, не требуя подключения к источнику данных.
Для проведения анализа текста в качестве контрольного примера
было взято стихотворение А.С. Пушкина "Зимнее утро".
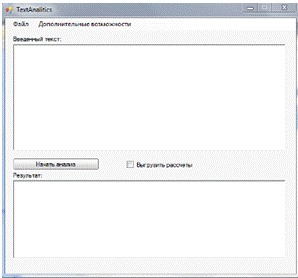
Рисунок 17. Начало работы с программой.
На рисунке 17 представлено начало работы с программой. Сразу
после открытия программы отображается форма для фоносемантического анализа
текстов.
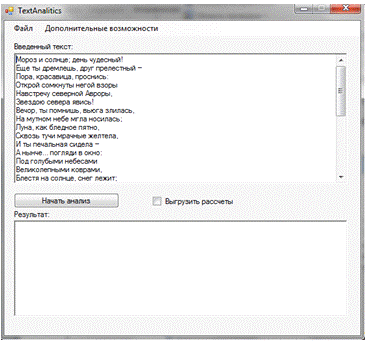
Рисунок 18. Загрузка текста в систему.
На рисунке 18 представлен вывод текста на экран после
загрузки его в систему.
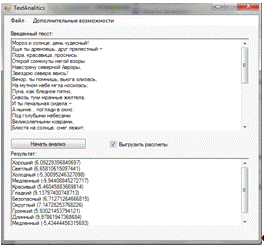
Рисунок 19. Вывод результатов анализа на экран.
На рисунке 19 представлена выгрузка результатов анализа
текстов на экран. Так как пользователь дополнительно проставил
"галочку" у опции выгрузки расчетов, системой был сформирован отчет
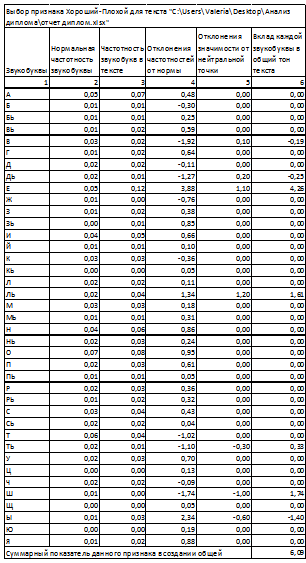
формата. xlsx. Его внешний вид представлен на рисунках 20-22.
Рисунок 20. Анализ текста по шкале
"Хороший-плохой".
Так как пользователь дополнительно проставил
"галочку" у опции выгрузки расчетов, системой был сформирован отчет
формата. xlsx.
Листинг разработанного программного продукта представлен в
Приложении А "Листинг исходного кода проекта".
Планируется массовое распространение системы
психолингвистического анализа текстов, стоимость одного экземпляра определяется
из предпочтительной прибыли. Аргументация запланированных размеров прибыли, а
так же расчет себестоимости системы не приводится, так как не имеют прямого
отношения к данной работе.
Определять цену одного экземпляра было решено исходя из
планируемого объема прибыли равного одному миллиону рублей с десяти проданных
коробок. Затраты на тиражирование и реализацию одной коробки были условно взяты
равными 10% от себестоимости системы. Себестоимость системы равна 461 500
рублей.
Определим себестоимость продукта с учетом затрат на
тиражирование и реализацию:
Цзатр=Цразраб + 10%; (5)
Цзатр= 461 500 + 10% = 507 650 рублей.
Определим цену одного экземпляра продукта, исходя из
необходимой прибыли:
Цэкз= Цзатр / Т + П / Т, (6)
где Т - тираж, П - прибыль.
Цэкз = 507 650/10 + 1 000 000/10 = 150 765 рублей.
При расчете отпускной цены учитывается величина налога на
добавленную стоимость НДС (18%). В данном случае воспользуемся формулой:
Цэкз отп = Цэкз* (1+0,18); (7)
Цэкз отп= 150 765 * 1,18= 177 902,7 рублей.
Таким образом цена продажи одной коробки составляет 177 902,7
рублей.
Совокупная стоимость владения равна затратам на внедрение,
так как закупка дополнительной техники предприятием не требуется.
Затраты на внедрение программного продукта (КВПР)
рассчитываются по формуле:
где ЗМ - затраты на приобретение материалов,
руб.;
ЗКТС - затраты на приобретение комплекса технических средств, руб.;
ЗПО
- затраты на приобретение программного обеспечения (включают стоимость
разработанного ПП, а также других существующих ПП, необходимых для
функционирования системы), руб.;
ЗФОТВ - затраты на оплату труда работников, занятых внедрением проекта,
руб.;
ЗОБУЧ - затраты на оплату труда работников, занятых освоением ПП, руб.
ЗЭВМ - затраты, связанные с эксплуатацией ЭВМ при внедрении проектного
решения, руб.;
Рком - командировочные расходы, руб.;
РН
- накладные расходы, руб.;
kТУН - коэффициент транспортирования, установки и наладки комплекса
технических средств, определяется действующими нормативами организации, а также
спецификой конкретного проекта.
Так как техника и программное обеспечение для эксплуатации системы
уже закуплены, установлены и готовы к эксплуатации, затраты на приобретение
материалов, техники и дополнительного программного обеспечения равны нулю.
Командировочные расходы так же не планируются. С учетом данных условий получим
следующую формулу:
Затраты на приобретение программного обеспечения ЗПО =
474212 руб.
Внедрением занят один системный инженер с окладом 20000 руб. Время
внедрения - 0,3 месяцев. Совокупные затраты на оплату труда системного инженера
с учетом отчислений во внебюджетные фонды.
ЗФОТВ = оклад * tВН * (1+ kД) * (1+kОВФ),
(10)
где kД - коэффициент дополнительной зарплаты работников,
занятых внедрением проекта, kД = 0,2;
kОВФ - коэффициент отчислений во внебюджетные фонды, kОВФ
=0,302;
tВН - общее время на внедрение проектного решения, затрачиваемое
сотрудником, мес.
ЗФОТВ = 20 000*0,3* (1+0,2) (1+0,302) = 9 374,4 руб
.
Затраты на оплату труда работников, занятых освоением ПП:
ЗОБУЧ = n*оклад* tОБ* (1+ kД) * (1+ kОВФ)
/21/8, (11)
где n - количество сотрудников, занятых в обучении, чел., n=1
чел.;ОБ - время обучения, час., tОБ = 10 час.
ЗОБУЧ = 1*20000*10* (1+0,2) * (1+0,302) /21/8 = 3 720 руб.
Затраты, связанные с эксплуатацией ЭВМ при внедрении проектного
решения, при условии, что время работы каждой ЭВМ составит 30 % от времени
внедрения:
ЗЭВМ = 0,3*tВН * 21*8* СМ-Ч *n,
(12)
где СМ-Ч - стоимость машино-часа эксплуатации
оборудования, руб. /час., СМ-Ч =16,24 руб. /час.
ЗЭВМ = 0,3*0,3*21*8*16,24*1 = 245 руб.
Накладные расходы
РН
= (ЗФОТВ + ЗОБУЧ) * kНР,
(13)
РН
= (9 374,4 +3 720) *0,7 = 9166 руб.
Суммарные затраты на внедрение
КВПР = 461 500 + 9 374,4 + 3 720 + 245 + 9166= руб.
Таким образом, затраты на внедрение программного продукта
составили 484 005 рублей и равны балансовой стоимости продукта (или общей
стоимости владения).
Внедрение системы психолингвистического анализа текстов
позволит:
автоматизировать процесс фоносемантического анализа текстов;
снизить трудоемкость процесса фоносемантического анализа
текстов;
уменьшит затраты на заработную плату лингвиста-аналитика.
Таким образом, внедрение вышеуказанной системы позволит
исключить ошибки, связанные с восприятием текста конкретным лингвистом ввиду
сведения человеческого фактора при анализе к минимуму [5].
В результате выполнения выпускной квалификационной работы
были построены модели предметной области и разработанной системы. Модель
предметной области включает в себя диаграммы бизнес-процессов
"Как-есть" в нотациях IDEF0 и IDEF3 (всего 4 диаграммы), диаграммы
бизнес-процессов "Как-должно-быть" в нотациях IDEF0 и IDEF3 (всего 6
диаграмм). Модель системы (7 диаграмм) проектировалась в нотации UML и включает
в себя описание функциональных возможностей системы, ее логической и физической
структуры, а так же схему взаимодействия модулей. В системе реализовано более 7
сложных объектов, объем кода составляет более 1000 строк.
Полученный программный продукт отвечает всем требованиям
пользователей, а так же выполнил все задачи и цель ВКР. Разработанный модуль,
позволяет пользователю производить психолингвистический анализ текстов и
автоматически формировать отчеты в формате. xlsx. Таким образом, время,
необходимое для осуществления анализа, сокращается во много раз.
В настоящий момент времени система работает только с русскоязычными
текстами, потому база данных для математических расчетов есть только на русском
языке. В дальнейшем планируется провести масштабное исследование для
составление базы данных для англоязычных текстов и реализовать модуль анализа
текстов на английском языке (и соответственно локализовать систему для
англоязычных пользователей) [22].
1.
Белоусов
К.И., Блазнова Н.А. Введение в экспериментальную. лингвистику: учеб. пособие /
К.И. Белоусов, Н.А. Блазнова. - М.: Флинта: Наука, 2005. - 136 с.
2.
Воронин
С.В. Фоносемантика как самостоятельная дисциплина. Исходные теоретические
положения // Общая психолингвистика: Хрестоматия. Учебное пособие / Сост.к.Ф.
Седова. - М.: Лабиринт, 2004. - 320 с.
3.
Гендер
и язык: сборник научных статей / Московский гос. лингвистический ун-т;
Лаборатория гендерных исследований. - М.: Языки славянской культуры, 2005 - 624
с.
4.
Дридзе
Т.М. Социально-психологические аспекты порождения и интерпретации текстов в
деятельности речевого общения. // Аспекты изучения текста. М., 1981. С.
129-136.
Журавлев
А.Н. Звук и смысл: Кн. для внеклассного чтения. - М.: Просвещение, 1981 - 160
с., ил.
5.
Залевская
А.А. Проблемы психолингвистики: вопросы теории и истории: лекции. - Алматы,
2006. - 56 с.
6.
Залевская
А.А. Психолингвистические исследования. Слово. Текст: Избранные труды. - М.:
Гнозис, 2005. - 543 с.
Имшинецкая
И. Фоносемантика в рекламе [Электронный ресурс] / И. Имшинецкая. - Режим
доступа: http://evartist. narod.ru/text11/60. htm, 1. 06.2015 г.
7.
Исследование
речевого мышления в психолингвистике: сборник научных трудов/ Отв. Ред. Е.Ф.
Тарасов. - М.: Наука, 1985. - 240 с.
8.
Котлячков
А., Горин С. Оружие - слово. - М.: 2001. - 215 с.
9.
Леонтьев
А.А. Психолингвистические единицы и порождение речевого высказывания: Монография.
- М.: Едиториал УРСС, 2003. - 312 с.
10.Настин И.В. Психолингвистика: учебно-методическое пособие. - М.:
Московский психолого-социальный институт, 2007. - 211 с.
11.Петренко В.Ф. Основы психосемантики: Учеб. пособие. - М.: Изд-во
Моск. ун-та, 1997. - 400 с.
12.Психолингвистические проблемы семантики: сборник научных трудов/
Отв. Ред.А. А. Леонтьев, А.М. Шахнарович. - М.: Наука, 1983. - 286 с.
13.Секерина И.А. Психолингвистика // Фундаментальные направления
современной американской лингвистики: сборник научных трудов. - М., 1997. - С.
231 - 256 с.
14.Фоносемантика [Электронный ресурс] / Материал из Википедии -
свободной энциклопедии. - Режим доступа: https: // ru.
wikipedia.org/wiki/фоносемантика, 1. 06.2015 г.
15.Фрумкина Р.М. Психолингвистика: Учеб. пособие для студ. высш.
учеб. заведений. - М.: Издательский центр "Академия", 2003. - 320 с.
16.Хроленко А.Т. Введение в лингвофольклористику: Учебное пособие
[Текст] / А.Т. Хроленко. - М.: Флинта: Наука, 2010. - 234 с.
17.Черемных, С.В. Моделирование и анализ систем. I DEF-технологии:
практикум / С.В. Черемных, И.О. Семенов, B. C. Ручкин. - М.: Финансы и
статистика, 2006. - 192 с: ил. - (Прикладные информационные технологии).
18.Языковое сознание: формирование и функционирование: сборник
научных трудов. - М., 1998. - 455 с.
19.Contemporary linguistics / Ed. by W. O'Grady, M. Dobrovolsky, M.
Aronoff. Boston, 1997.Р. 389-508.
20.Osgood Charles E. Method and Theory in Experimental Psychology
[Text] / Ch. E. Osgood. - Oxford, 1956. - 297 p.
Приложение А.
Листинг исходного кода проекта
using System;System. Collections.
Generic;System.componentModel;System. Data;System. Drawing;System. Linq;System.
Text;System. Windows. Forms;System. IO;Word = Microsoft. Office. Interop.
Word;System. Text. RegularExpressions;Diplom
{partial class Form1: Form
{Form1 ()
{();
}string openWordDoc (string path) // открытие текстового
документа соответствующего формата
{. Application wordapp = new Word. Application ();. Visible =
false;filename = path;confirmConversions = true;readOnly =
true;addToRecentFiles = true;passwordDocument = Type. Missing;passwordTemplate
= Type. Missing;revert = false;writePasswordDocument = Type.
Missing;writePasswordTemplate = Type. Missing;format = Type. Missing;encoding =
Type. Missing;;oVisible = Type. Missing;openConflictDocument = Type.
Missing;openAndRepair = Type. Missing;documentDirection = Type.
Missing;noEncodingDialog = false;xmlTransform = Type. Missing;extention = path.
Split ('. ') [1];result="";(extention)
{"txt": result = File. ReadAllText (path);
break;"doc":"docx": Word. Document wordDoc = wordapp.
Documents. Open (ref filename,confirmConversions, ref readOnly, ref
addToRecentFiles,passwordDocument, ref passwordTemplate, ref
revert,writePasswordDocument, ref writePasswordTemplate,format, ref encoding,
ref oVisible,openAndRepair, ref documentDirection, ref noEncodingDialog, ref
xmlTransform);= wordDoc. Range (). Text;. Quit (); break;
}result;
}void словоToolStripMenuItem_Click (object sender, EventArgs
e)
{wordForm = new WordAnalitic ();. ShowDialog ();
}void открытьToolStripMenuItem_Click (object sender,
EventArgs e)
{(openFileDialog1. ShowDialog () == DialogResult. OK).
Text=openWordDoc (openFileDialog1. FileName);
}void выйтиToolStripMenuItem_Click (object sender, EventArgs
e)
{. Close ();
}void Form1_FormClosing (object sender, FormClosingEventArgs
e)
{(MessageBox. Show ("Вы точно хотите выйти из
программы?", "Вы покидаете программу.", MessageBoxButtons.
YesNo)! = DialogResult. Yes). Cancel = true;
}void btnStart_Click (object sender, EventArgs e)
{( (chbOutput. Checked) && (saveFileDialog1.
ShowDialog ()! = DialogResult. OK));. Text = "";<string> bgData
= new List<string> ();. Add (txtText. Text);. Add (saveFileDialog1. FileName);.
Enabled = false;.runWorkerAsync (bgData);. Visible = true;. Value = 25;
}<string> res;void bgWorker_DoWork (object sender,
DoWorkEventArgs e)
{<string> data = (List<string>) e.
Argument;(chbOutput. Checked)= Analyzer. GetTextWeight (data [0], new ExcelWorker
(data [1], data [1]));= Analyzer. GetTextWeight (data [0]);
}void bgWorker_RunWorkerCompleted (object sender,
RunWorkerCompletedEventArgs e)
{(res! = null)(string result in res)(! result. Contains
("--")). Text = txtResult. Text + result + "\n";(String.
IsNullOrEmpty (txtResult. Text)). Text = "Текст не имеет сильной
эмоциональной окрашенности. ";. Visible = false;. Enabled = true;. Value =
0;
}void пакетнаяОбработкаТекстаToolStripMenuItem_Click (object
sender, EventArgs e)
{( (folderBrowserDialog1. ShowDialog () == DialogResult. OK)
&& (saveFileDialog1. ShowDialog () ==DialogResult. OK))
{. Text = "";<string> bgData = new
List<string> ();. Add (folderBrowserDialog1. SelectedPath);. Add
(saveFileDialog1. FileName);. Enabled = false;.runWorkerAsync (bgData);.
Visible = true;
}
}void bgwPackage_DoWork (object sender, DoWorkEventArgs e)
{<string> data = (List<string>) e.
Argument;(sender as BackgroundWorker, data [0], data [1]);
}void bgwPackage_RunWorkerCompleted (object sender,
RunWorkerCompletedEventArgs e)
{. Show ("Пакетная обработка файлов успешно
завершена!");. Enabled = true;. Value = 0;. Visible = false;
}void PackageAnalyzer (BackgroundWorker bg, string OpenPath,
string SavePath)
{<string> files = Directory. GetFiles (OpenPath +
"\\", "*. txt"). ToList ();. AddRange (Directory. GetFiles
(OpenPath + "\\", "*. doc?"). ToList ());step = 100/files.
Count;ew = new ExcelWorker (SavePath, "", true);. OutputPackage
("Шкала \\ Текст", Analyzer. OutPutScales. ToList ());(string file in
files)
{<string> result = Analyzer. GetTextWeight (openWordDoc
(file));. ReportProgress (step);. OutputPackage (file, result);
}. Close ();
}void bgwPackage_ProgressChanged (object sender,
ProgressChangedEventArgs e)
{. Value += e. ProgressPercentage;
}System;System. Collections. Generic;System. Linq;System.
Text;System. Data;System. Data. OleDb;System. Data. SqlClient;System.
Windows;System. Windows. Forms;Diplom
{MSAccess
{static OleDbDataAdapter dataAdapter = new OleDbDataAdapter
();string file = "MyDB. mdb";static OleDbConnection SqlConnection ()
{
// string file = "DBTeis. db";con = new
OleDbConnection ();
// SqlConnectionStringBuilder conString = new
SqlConnectionStringBuilder ();conString = "Provider=Microsoft. Jet. OLEDB.
4. 0; Data Source=" + file + "; User Id=admin; Password=; ";.
ConnectionString = conString. ToString ();con;
}static DataTable GetData (string selectCommand)
{con = SqlConnection ();table = new DataTable ();
{. Open ();comm = new OleDbCommand (selectCommand, con);= new
OleDbDataAdapter (comm);commandBuilder = new OleDbCommandBuilder
(dataAdapter);. Locale = System. Globalization. CultureInfo. InvariantCulture;.
Fill (table);. Close ();
}(Exception e)
{. Show ("При выполнении запроса к базе данных произошла
ошибка: " + e. Message);
}table;
}
}
}System;System. Collections.
Generic;System.componentModel;System. Data;System. Drawing;System. Linq;System.
Text;System. Windows. Forms;System. Text. RegularExpressions;Diplom
{partial class WordAnalitic: Form
{WordAnalitic ()
{();
}void btnGo_Click (object sender, EventArgs e)
{matches = Regex. Matches (txtWord. Text, "
[^\\*а-яА-Я]", RegexOptions. IgnoreCase);(matches. Count! = 0)
{. Show ("Некорректно введено слово!!!!");;
}( (chbOutput. Checked) && (saveFileDialog1.
ShowDialog ()! = DialogResult. OK));. Text = "";<string> bgData
= new List<string> ();. Add (txtWord. Text);. Add (saveFileDialog1.
FileName);. Enabled = false;.runWorkerAsync (bgData);. Visible = true;. Value =
45;
}<string> res;void backgroundWorker1_DoWork (object
sender, DoWorkEventArgs e)
{<string> data = (List<string>) e.
Argument;(chbOutput. Checked)= Analyzer. GetWordWeight (data [0], new
ExcelWorker (data [1], data [1]));= Analyzer. GetWordWeight (data [0]);
}void backgroundWorker1_ProgressChanged (object sender,
ProgressChangedEventArgs e)
{
}void backgroundWorker1_RunWorkerCompleted (object sender,
RunWorkerCompletedEventArgs e)
{(res! = null)(string result in res). Text = txtResult. Text
+ result + "\n";(String. IsNullOrEmpty (txtResult. Text)). Text =
"Текст не имеет сильной эмоциональной окрашенности. ";. Visible =
false;. Enabled = true;. Value = 0;
}void WordAnalitic_Load (object sender, EventArgs e)
{
}
}
}System;System. Collections. Generic;System. Linq;System.
Text;System. Text. RegularExpressions;System. Data;System. Windows.
Forms;Diplom
{Analyzer
{static string [] scales = { "1. Хороший-плохой",
"2. Большой-маленький", "3. Нежный-грубый", "4.
Женственный-мужественный","5. Светлый-темный", "6.
Активный-пассивный", "7. Простой-сложный", "8.
Сильный-слабый","9. Горячий-холодный", "10.
Быстрый-медленный", "11. Красивый-отталкивающий", "12.
Гладкий-шероховатый","13. Легкий-тяжелый", "14.
Веселый-грустный", "15. Безопасный - страшный", "16. Величественный-низменный","17.
Яркий-тусклый", "18. Округлый-угловатый","19. Радостный -
печальный", "20. Громкий-тихий","21.
Длинный-короткий", "22. Храбрый-трусливый", "23.
Добрый-злой", "24. Могучий-хилый", "25.
Подвижный-медленный"};static string [] OutPutScales = {
"Хороший-Плохой", "Большой-Маленький",
"Нежный-Грубый", "Женственный-Мужественный","Светлый-Темный",
"Активный-Пассивный", "Простой-Сложный",
"Сильный-Слабый","Горячий-Холодный",
"Быстрый-Медленный", "Красивый-Отталкивающий",
"Гладкий-Шероховатый","Легкий-Тяжелый",
"Веселый-Грустный", "Безопасный-Страшный", "Величественный-Низменный","Яркий-Тусклый",
"Округлый-Угловатый","Радостный-Печальный",
"Громкий-Тихий","Длинный-Короткий",
"Храбрый-Трусливый", "Добрый-Злой",
"Могучий-Хилый", "Подвижный-Медленный"};MSAccess MSAccess
{
{new System. NotImplementedException ();
}
{
}
}ExcelWorker ExcelWorker
{
{new System. NotImplementedException ();
}
{
}
}static List<string> GetWordWeight (string word,
ExcelWorker output = null)
{
{= word + " ";<string> Result = new
List<string> ();<string, double> frequency = new
Dictionary<string, double> ();<string, double> weights = new
Dictionary<string, double> ();letters = MSAccess. GetData ("Select *
from Частототность where звук not like '_ [’юёяие] '");(DataRow letter in
letters. Rows)
{matches;goodletter = letter [1]. ToString (). Replace
("*", @"\*");teststring =
"АаОоЁёЕеИиУуЭэЯяЫыЮюЙйЧчЩщЖжШшЦц";( (letter [1]. ToString (). Length
== 1) && (! teststring. Contains (letter [1]. ToString ())))= Regex.
Matches (word, goodletter. ToString () + " [^\\*ьюёяие]",
RegexOptions. IgnoreCase); // Ищет в указанной входной строке все вхождения
заданного регулярного выражения.
{pattern = goodletter. Replace ("Ь", "
['ьюёяие] ");= Regex. Matches (word, pattern, RegexOptions. IgnoreCase);
// Ищет в указанной входной строке все вхождения заданного регулярного
выражения, используя указанные параметры сопоставления.
}(Match match in matches)
{(frequency. ContainsKey (letter [1]. ToString ()))
{[letter [1]. ToString ()] += 1;;
}. Add (letter [1]. ToString (), double. Parse (letter [2].
ToString ()));(match. Index == 0)
{. Add (letter [1]. ToString (), 4);;
}(match. Value. Contains ('*')). Add (letter [1]. ToString
(), 2);. Add (letter [1]. ToString (), 1);
}
}Pmax = frequency. Values. Max ();summKi = 0;(string sound in
frequency. Keys)
{[sound] = weights [sound] * Pmax / frequency [sound];+=
weights [sound];
}(output! = null)
{. weights = weights;. Pmax = Pmax;. frequency = frequency;
}(int i = 0; i < scales. Length; i++)
{scaleRes = getScaleSignificance (i, weights, summKi,
output);(! String. IsNullOrEmpty (scaleRes)). Add (scaleRes);
}(output! = null). Close ();Result;
}(Exception e)
{. Show ("При выполнении расчетов произошла ошибка,
проверьте введенные данные. ");null;
}
}static string getScaleSignificance (int scale,
Dictionary<string, double> frequency, double summ, ExcelWorker output =
null) // значение шкал
{F = 0;significance = MSAccess. GetData ("Select Буква,
Значение from Значимость where Признак = '"+ scales [scale]
+"'");<string, double> fk = new Dictionary<string,
double> ();(KeyValuePair<string, double> sound in frequency)
{[] sign = significance. Select ("Буква = '"+sound.
Key. Replace ("*","") +"'");. Add (sound. Key,
double. Parse (sign [0] [1]. ToString ()) * sound. Value);
}(output! = null). OutputWordScale (OutPutScales [scale],
fk);= fk. Values. Sum () /summ;(F <= 2. 5)OutPutScales [scale]. Split ('-')
[0];(F >= 3. 5)OutPutScales [scale]. Split ('-') [1];"";
}static List<string> GetTextWeight (string text,
ExcelWorker output = null) // анализ текста
{
{<string, double> frequency = new Dictionary<string,
double> ();<string, double> realFrequency = GetFrequency (text, ref
frequency);<string, double> sigma = new Dictionary<string, double>
();<string> result = new List<string> ();[] separator = { ' ',
'\n', '\r' };<string> words = text. Split (separator, StringSplitOptions.
RemoveEmptyEntries). ToList ();blockLength = words. Count / 5;(blockLength! =
0)
{<Dictionary<string, double>> realFreq = new
List<Dictionary<string, double>> ();. Add (realFrequency);(int i =
4; i >= 0; i--)
{<string, double> partFreq = new Dictionary<string,
double> ();[] tmp = new string [words. Count - blockLength * i];. CopyTo
(blockLength * i, tmp, 0, words. Count - blockLength * i);. Add (GetFrequency
(String. Concat (tmp), ref partFreq));. RemoveRange (words. Count - tmp.
Length, tmp. Length);
}= GetSigma (realFreq);
}
{. Show ("В выбранном документе менее 5 слов. Корректно
провести анализ невозможно. ");null;
}<string, double> midDeviation = new
Dictionary<string, double> ();(string sound in frequency. Keys). Add
(sound, (realFrequency [sound] - frequency [sound]) / sigma [sound]);(int i =
0; i < scales. Length; i++)
{<string, double> signDeviation = new
Dictionary<string, double> ();<string, double> contribution = new
Dictionary<string, double> ();significance = MSAccess. GetData
("Select Буква, Значение from Значимость where Признак = '" + scales
[i] +
"' and Буква not like '_ [юёяие] '");(string sound
in frequency. Keys)
{( (midDeviation [sound] < - 1) || (midDeviation [sound]
> 1))
{[] sign = significance. Select ("Буква = '" +
sound + "'");. Add (sound, 3. 0 - double. Parse (sign [0] [1].
ToString ()));. Add (sound, midDeviation [sound] * signDeviation [sound]);
}
{. Add (sound, 0);. Add (sound, 0);
}
}(output! = null)
{. frequency = frequency;. weights = realFrequency;.
OutputTextScale (OutPutScales [i], midDeviation, signDeviation, contribution);
}sum = contribution. Values. Sum ();fringe = 5;(text. Length
> 1000)+= text. Length / 1000;(sum > fringe). Add (OutPutScales [i].
Split ('-') [0] + " (" + sum. ToString () + ")");
{(sum < 0-fringe). Add (OutPutScales [i]. Split ('-') [1]
+ " (" + sum. ToString () + ")");. Add (" - (" +
sum. ToString () + ")");
}
}(output! = null). Close ();result;
}(Exception e)
{. Show ("При выполнении расчетов произошла ошибка,
проверьте введенные данные. ");null;
}
}static Dictionary<string, double> GetSigma
(List<Dictionary<string, double>> realFreq) // вычисление сигмы для
статистики
{<string, double> sigma = new Dictionary<string,
double> ();(string sound in realFreq [0]. Keys)
{midSound = 0;(int i = 1; i < 6; i++)(realFreq [i].
ContainsKey (sound))+= realFreq [i] [sound];/= 5;. Add (sound, 0);(int i = 1; i
< 6; i++)
{(realFreq [i]. ContainsKey (sound))[sound] += Math. Pow (
(realFreq [i] [sound] - midSound), 2);[sound] += Math. Pow (midSound, 2);
}[sound] = Math. Pow (sigma [sound] * 0. 2, 0. 5);
}sigma;
}static Dictionary<string, double> GetFrequency (string
text, ref Dictionary<string, double> frequency) // вычисление частотности
{soundcount = 0;= text + " ";<string, double>
realFrequency = new Dictionary<string, double> ();letters = MSAccess.
GetData ("Select * from Частототность where звук not like '_ [*’юёяие]
'");teststring = "АаОоЁёЕеИиУуЭэЯяЫыЮюЙйЧчЩщЖжШшЦц";(DataRow
letter in letters. Rows)
{matches;( (letter [1]. ToString (). Length == 1) &&
(! teststring. Contains (letter [1]. ToString ())))= Regex. Matches (text,
" (" + letter [1] + @" [^ьюёяие])", RegexOptions.
IgnoreCase);
{pattern = letter [1]. ToString (). Replace ("Ь",
" [ьюёяие] ");= Regex. Matches (text, pattern, RegexOptions.
IgnoreCase);
}(Match match in matches)
{(frequency. ContainsKey (letter [1]. ToString ()))
{[letter [1]. ToString ()] += 1;++;;
}. Add (letter [1]. ToString (), double. Parse (letter [2].
ToString ()));. Add (letter [1]. ToString (), 1);++;
}
}(string sound in frequency. Keys)[sound] /=
soundcount;realFrequency;
}
}
}System;System. Collections. Generic;System. Linq;System.
Text;System. Windows. Forms;Excel = Microsoft. Office. Interop. Excel;Diplom
{ExcelWorker
{path;Excel. Application excel;currentSheet;. Workbook
workbook;Dictionary<string, double> frequency;Dictionary<string,
double> weights;double Pmax;name;ExcelWorker (string path, string name, bool
package=false)
{. path = path;. name = name;= new Excel. Application ();(!
package). SheetsInNewWorkbook = 25; // количество листов в книге.
SheetsInNewWorkbook = 1;. Workbooks. Add (Type. Missing); // добавляем книгу=
excel. Workbooks [excel. Workbooks. Count]; // получам ссылку на первую
открытую книгу= 1;
}void OutputPackage (string fileName, List<string>
scales)
{columns = "ABCDEFGHIJKLMNOPQRSRUVWXY";. Worksheet
sheet = workbook. Worksheets. get_Item (1);. Cells [1, currentSheet] =
fileName;(int i=0; i<scales. Count; i++). Cells [i+2, currentSheet] = scales
[i];. Range rng = (Excel. Range) sheet. Cells. get_Range (columns
[currentSheet-1]. ToString () + 1. ToString (), columns [currentSheet-1].
ToString () + (scales. Count+1). ToString ());. Borders. LineStyle = Excel.
XlLineStyle. xlContinuous;. Borders. Weight = Excel. XlBorderWeight. xlMedium;.
ColumnWidth = rng. ColumnWidth * 2;. WrapText = true;++;
}void OutputTextScale (string scale, Dictionary<string,
double> midDeviation, Dictionary<string, double> signDeviation,
Dictionary<string, double> contribution) // вывод отчета по тексту
{
{. Worksheet sheet = workbook. Worksheets. get_Item
(currentSheet); // получаем ссылку на лист. Range header = (Excel. Range)
sheet. get_Range ("A1", "F2"). Cells;. Merge (Type.
Missing);. Value = "Выбор признака " + scale + " для текста
\"" + name + "\"";. Cells [3, 1] =
"Звукобуквы";. Cells [3, 2] = "Нормальная частотность
звукобуквы";. Cells [3, 3] = "Частотность звукобукв в тексте";.
Cells [3, 4] = "Отклонения частотностей от нормы";. Cells [3, 5] =
"Отклонения значимости от нейтральной точки";. Cells [3, 6] =
"Вклад каждой звукобуквы в общий тон текста";(int i = 1; i < 7;
i++). Cells [4, i] = i;row = 5;(string sound in frequency. Keys)
{. Cells [row, 1] = sound;. Cells [row, 2] = frequency
[sound];. Cells [row, 3] = weights [sound];. Cells [row, 4] = midDeviation
[sound];. Cells [row, 5] = signDeviation [sound];. Cells [row, 6] =
contribution [sound];++;
}. Range end = (Excel. Range) sheet. get_Range ("A"
+ row, "E" + row). Cells;. Merge (Type. Missing);. Value =
"Суммарный показатель данного признака в создании общей фонетической
значимости текста";. Cells [row, 6] = contribution. Values. Sum ();.
Cells. get_Range ("A1", "F" + row). Borders. LineStyle =
Excel. XlLineStyle. xlContinuous;. Cells. get_Range ("A1",
"F" + row). Borders. Weight = Excel. XlBorderWeight. xlMedium;.
Cells. get_Range ("A1", "F" + (row + 1)). WrapText =
true;++;
}(Exception e)
{. Show ("При формировании отчета произошла
ошибка");;
}
}void OutputWordScale (string scale, Dictionary<string,
double> fk) // отчет по слову
{
{. Worksheet sheet = workbook. Worksheets. get_Item
(currentSheet); // получаем ссылку на лист. Range header = (Excel. Range)
sheet. get_Range ("A1", "F2"). Cells;. Merge (Type.
Missing);. WrapText = true;. Value = "Вычисление фонетической значимости
слова " + name + " по шкале \"" + scale +
"\"";. Range thletter = (Excel. Range) sheet. get_Range
("A3", "A4"). Cells;. Merge (Type. Missing);. Value =
"Звукобуквы";. Range thstart = (Excel. Range) sheet. get_Range
("B3", "C3"). Cells;. Merge (Type. Missing);. Value =
"Исходные данные";. Range thmid = (Excel. Range) sheet. get_Range
("D3", "F3"). Cells;. Merge (Type. Missing);. Value =
"Промежуточные данные";. Cells [4, 2] = "fi";. Cells [4, 3]
= "pi";. Cells [4, 4] = "pmax/pi";. Cells [4, 5] =
"ki";. Cells [4, 6] = "fi*ki";row = 5;(string sound in fk.
Keys)
{. Cells [row, 1] = sound;. Cells [row, 2] = fk [sound] /
weights [sound];. Cells [row, 3] = frequency [sound];. Cells [row, 4] = Pmax /
frequency [sound];. Cells [row, 5] = weights [sound];. Cells [row, 6] = fk
[sound];++;
}. Cells [row, 1] = "Сумма: ";. Cells [row, 5] =
weights. Values. Sum ();. Cells [row, 6] = fk. Values. Sum ();++;. Range res =
(Excel. Range) sheet. get_Range ("A" + row, "F" + row).
Cells;. Merge (Type. Missing);. Value = "F = " + fk. Values. Sum () +
" / " + weights. Values. Sum () + " = " + fk. Values. Sum
() / weights. Values. Sum ();. Cells. get_Range ("A1", "F"
+ row). Borders. LineStyle = Excel. XlLineStyle. xlContinuous;. Cells.
get_Range ("A1", "F" + row). Borders. Weight = Excel.
XlBorderWeight. xlMedium;. Cells. get_Range ("A1", "F" +
(row + 1)). WrapText = true;++;
}(Exception e)
{. Show ("При формировании отчета произошла
ошибка");;
}
}void Close ()
{
{. SaveAs (path);. Quit ();
}(Exception e)
{. Show ("При сохранении отчета произошла
ошибка");;
}
}
}
1.3
Постановка задачи автоматизации бизнес-процессов
Цели и задачи
автоматизации бизнес-процессов
Построение и
обоснование модели новой организации бизнес процессов
Спецификация
и обоснование нефункциональных требований
.4
Календарно-ресурсное планирование проекта, анализ бюджетных ограничений и
рисков
Модель
жизненного цикла разработки программного продукта
Анализ
ограничений и рисков
Календарный
план
2. Проект
автоматизации
2.1
Функциональная структура
.2
Информационное обеспечение
2.3
Математическое обеспечение



2.4
Программное обеспечение
2.5
Техническое обеспечение
2.6
Технологическое обеспечение
2.7 Контрольный
пример
3. Оценка
эффективности проекта
3.1 Оценка
совокупной стоимости владения
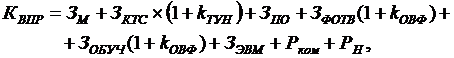 (8)
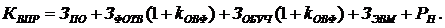 (9)
3.2 Анализ
качественных и количественных факторов воздействия проекта на
бизнес-архитектуру организации
Заключение
Список
литературы
Приложения