Дипломная (вкр): Таблицы принятия решений в СУБД с табличной моделью данных
Например, при работе с правилами, имеющими исключения, действий при одних и тех же условиях может быть больше одного. Поэтому, в реализованном варианте для каждого действия предусмотрена своя строка (т. е. продукция). Возможен вариант продукций со списком действий в столбце «Действие».
В столбце «Последействия» записываются возможные переходы к другим строкам таблицы (это позволяет работать с исключениями из правил) или к другим таблицам.
Поскольку в данной работе используется прямой логический вывод, то для выбора антецедента в экспертной системе используется ответ пользователя на поставленные вопросы, консеквентном - соответствующее действие.
Прямой вывод в ТПР экспертной системы легко реализуется простым запросом
к единственной таблице решений, когда выбирается одна или несколько продукций.
Множественный выбор должен появляться только в ТПР с нечёткостями.
1.5 Универсальная модель данных
Как упоминалось выше, возможность использования запросов SQL с соединениями в качестве эквивалентов простых продукций вида AK известна. В предлагаемой дипломной работе применяется более эффективное решение, в котором одной продукции соответствует единственный простой запрос к одной таблице. Этот подход распространён на таблицы принятия решений (с ограниченным и расширенными вводами), основанными на продукциях общего вида (с выбором области и подобласти, условий применения и заданием последействия). Для хранения этих таблиц и работы с любыми таблицами решения была использована универсальная модель данных (УМД).
УМД состоит из фиксированного набора таблиц. Она может хранить в себе и
данные, и метаданные нескольких виртуальных схем базы. В простейшем варианте
УМД представляет собой набор из четырех таблиц изображённый на рисунке 2.
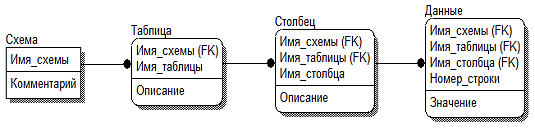
Рисунок 2 - схема УМД
Этот набор таблиц остаётся неизменным. Для добавления имени таблицы в виртуальную схему необходимо добавить одну строку в таблицу «Таблица», а для добавления столбца - добавить одну строку в таблицу «Столбец». Количество строк в таблице «Данные», определяющих одну строку таблицы, равно числу столбцов у этой таблицы. Заметим, что тип столбца может быть описан в колонке «Описание» таблицы «Столбец», но может быть добавлен в дополнительном столбце [6].
Универсальность расширения обеспечивается, прежде всего, хранением множества систем таблиц принятия решений, или продукций в универсальной модели данных. При добавлении любого количества интеллектуальных подсистем структура хранения не меняется. При добавлении новых таблиц принятии решений, условия и действия записываются в таблицу metadata, а содержимое таблиц - в decision. Таким образом, одной продукции соответствует единственный простой запрос к одной таблице.
Особенности УМД - низкая скорость. Но в наших задачах для экспертных систем малые объёмы данных.
Высокая эффективность работы с таблицами решений позволяет строить
сложные системы искусственного интеллекта. Их преимущества по сравнению с
обычными экспертными системами - простота эксплуатации, легкость встраивания в
базу данных и вытекающая из этого обстоятельства возможность использования
индексов базы для ускорения доступа к большому объёму фактов, представленных
таблицами базы данных.
1.6 Динамические SQL-запросы и их использование
Хранение таблиц решений в универсальной модели данных позволяет осуществлять работу с таблицами при помощи однотипных запросов, состоящих из трёх базовых фраз языка SQL: SELECT, FROM, WHERE в стандарте SQL-2, что обеспечивает встраиваемость в различные СУБД с табличной моделью данных.
Универсальность построения запросов обеспечивается использованием технологии динамических SQL-запросов, что позволяет избегать соединения нескольких таблиц, для получения каких-либо вспомогательных данных и обеспечивает работу с любым количеством условий.
Например, для поиска нужных продукций, заполнения таблицы с историей работы пользователя, может потребоваться получить дополнительную информацию, такую как ответы пользователя, информация о предыдущем шаге работе и др. Запросы с соединением таблиц, внешних для ТПР может иметь невыгодный план запроса. Намного выгодней выполнить несколько простых запросов к одиночным таблицам с временным сохранением результатов и последующей генерацией динамического запроса, на основе этих данных.
Приведём пример сгенерированного запроса, для поиска продукции, соответствующей комбинации ответов пользователя, где ответы заранее извлечены в одномерный массив:
actions, aftereffect FROM decisionsysname = 'Medicine' AND
Domain = 'Diagnostics'Subdomain ='Breathing System' AND table_id = 1( (
('yes'='yes') OR 'yes'='_') AND( ('no'='no') OR 'no'='_')( ('yes'='yes') OR
'yes'='_') );
Здесь подчёркнутые «yes» и
«no» - элементы массива, содержащего
ответы пользователя на поставленные условия, хранящиеся в отдельной таблице
базы и извлечённые заранее.
1.7 Нечёткая логика в таблицах принятия решений
Классическая логика, по определению, не может оперировать с нечетко очерченными понятиями, поскольку все высказывания в формальных логических системах могут иметь только два взаимоисключающих состояния: «истина» со значением истинности «1» и «ложь» со значением истинности «0».
Одной из попыток уйти от двузначной бинарной логики для описания неопределенности было введение Лукашевичем трехзначной логики с третьим состоянием «возможно» со значением истинности «0,5». Введя в рассмотрение нечеткие множества, Заде предложил обобщить классическую бинарную логику на основе рассмотрения бесконечного множества значений истинности. В предложенном Заде варианте нечеткой логики множество значений истинности высказываний обобщается до интервала [0;1] , т.е. включает как частные случаи классическую бинарную логику и трехзначную логику Лукашевича. Такой подход позволяет рассматривать высказывания с различными значениями истинности и выполнять рассуждения с неопределенностью.
Нечеткое высказывание - это законченная мысль, об истинности или ложности которой можно судить только с некоторой степенью уверенности [0;1]: «возможно истинно», «возможно ложно» и т.п. Чем выше уверенность в истинности высказывания, тем ближе значение степени истинности к 1. В предельных случаях 0, если мы абсолютно уверены в ложности высказывания, и 1, если мы абсолютно уверены в истинности высказывания, что соответствует классической бинарной логике. В нечеткой логике нечеткие высказывания обозначаются так же, как и нечеткие множества: A, B, C … . Введем нечеткое отображение T: Ω→[0 ; 1] , которое действует на множестве нечетких высказываний Ω=A, B, C… . В этом случае значение истинности высказывания A∈Ω определяется как TA∈[0;1] и является количественной оценкой нечеткости, неопределенности, содержащейся в высказывании A .
Логическое отрицание нечеткого высказывания A обозначается ¬A - это унарная (т.е. производимая над одним аргументом) логическая операция, результат которой является нечетким высказыванием «не A », «неверно, что A », значение истинности которого:
¬ A = 1 − T A
Логическая конъюнкция нечетких высказываний A и B обозначается A∩B- это бинарная (т.е. производимая над двумя аргументами) логическая операция, результат которой является нечетким высказыванием «A и B», значение истинности которого:
A ∩ B = min (T A ; T B)
Помимо приведенного выше исторически принятого основного определения логической конъюнкции (нечеткого «И»), введенного Заде, могут использоваться альтернативные формулы, например:
A ∩ B = max (T A + T B − 1 ; 0) - в базисе Лукашевича-Гилеса;
Логическая дизъюнкция нечетких высказываний A и B обозначается A B - это бинарная логическая операция, результат которой является нечетким высказыванием «A или B», значение истинности которого:
A B = max (TA ; TB).
Могут использоваться альтернативные формулы, например:
A B = min ( T A + T B ; 1) - в базисе Лукашевича-Гилеса;
Нечеткая импликация нечетких высказываний A и B обозначается A ⊃ B - это бинарная логическая операция, результат которой является нечетким высказыванием «из A следует B », «если A , то B », значение истинности которого:
A B = max( (min T A ; T B) ; 1 − T A)
Помимо приведенного выше исторически принятого основного определения нечеткой импликации, введенного Заде, могут использоваться следующие альтернативные определения нечеткой импликации, предложенные различными исследователями в области теории нечетких множеств:
A B = max (1 − T A ; T B) - Гедель;A B = min (T A ; T B) - Мамдани;A B = min (1 ; 1 − T A + T B)
- Лукашевич;A B = min (T A + T B ; 1)
- Лукашевич-Гилес.
Общее число введенных определений нечеткой импликации не ограничивается приведенными выше. Большое количество работ по изучению различных вариантов нечеткой импликации обусловлено тем, что понятие нечеткой импликации является ключевым при нечетких выводах и принятии решений в нечетких условиях. Наибольшее применение при решении прикладных задач нечеткого управления находит нечеткая импликация Заде.
Так же, как в классической бинарной логике, в нечеткой логике с помощью рассмотренных выше логических связок можно формировать достаточно сложные логические высказывания [9].
В представленной работе нечёткие логики используются для нахождения значимости полученного решения и определения приоритета в случае нескольких решений: пусть, необходимо работать с предикатами, атрибуты которых имеют разные значимости. На каждый основной атрибут вводится по одному дополнительному атрибуту, хранящему его вес. Взвешенная сумма произведений весов на признаки наличия атрибута (0 или 1), даёт значимость продукции, позволяющую выбирать наиболее существенные из выделенных, обычно, нескольких продукций и «отсекать» продукции, значимость которых ниже какого-либо установленного порога.
Например, пусть исходная комбинация условий имеет вид:
условие_1&( условие_2|| ^условие_3),
где значимость первого условия равна 0.2, второго - 0.7, третьего - 0.6.
С учётом весов комбинация примет вид:
.2&(0.7||^0.6)
При условии, что & есть min(A;B), || - max(A;B), а ^ есть (1-A), получим значение продукции равное 0.2.
Для более точного анализа можно применить расширенный ввод, использование которого, позволит пользователю отвечать на поставленные условия не строго «да»/«нет», но выставлять «показатель выраженности» условия, значения которого также могут находиться в интервале [0;1].
Введём для предыдущего примера дополнительные показатели для 3х условий:
0.7, 0.8 и 0.2 соответственно. Тогда получим:
(0.2*0.7) & ( (0.7*0.8) || (0.6*0.2) ),
где значение продукции будет равно 0.14.
2. Реализация ТПР, встроенных в БД табличного типа
Общая схема приложения для СУБД Oracle приведена на рисунке 3.
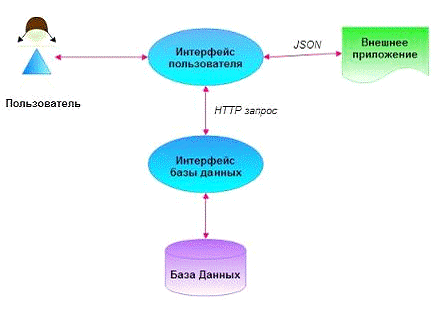
Рисунок 3 - схема приложения для Oracle
2.1 Схемы базы данных
Для хранения таблиц решения в УМД используются 2 таблицы: decision и metadata. То есть, при добавлении новых таблиц принятия решений не требуется создание новых таблиц для их хранения.
Таблицы data_users и data_clients содержат данные о пользователях и «привязанных» к ним клиентах и служат для поддержки работы интерфейса.
Схема модели данных в Oracle приведена на рисунке 4. Условные обозначения
на рисунке: P - превичный ключ, F - внешний ключ.
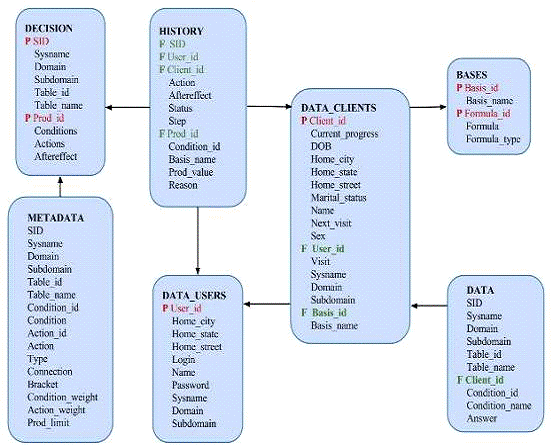
Рисунок 4 - Схема базы данных в Oracle
Таблица data (рисунок 5) - хранит ответы клиента
на условия, пройденных таблиц решения. Также содержит имя системы, область,
подобласть, в которых работает клиент, его идентификационный номер. Данные в
таблицу заносятся в процессе работы клиента с системой: на соответствующей
странице интерфейса клиент отвечает на поставленные вопросы (условия в
соответствующей таблице принятия решений), после чего ответ автоматически
заносится в таблицу и обрабатывается системой для получения «ответа» (действия)
и возможного перехода на следующую таблицу.
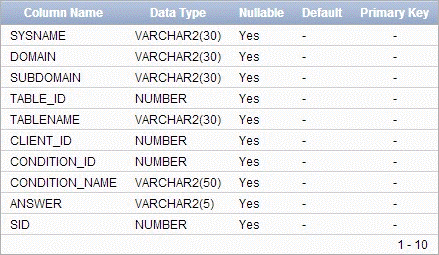
Рисунок
5 - таблица data
Здесь:
sysname - название системы, domain - название области, subdomain - название подобласти, table_id - номер таблицы принятия решений, tablename - название этой таблицы, client_id - номер клиента,
condition_id - номер условия, condition_name - само условие, answer - ответ клиента на заданное условие, sid - суррогатный ключ. В случае ограниченного ввода ответы клиента имеют вид «yes», «no» или «_» (безразлично). На рисунке 6 приведён пример заполнения таблицы data с расширенным вводом, где значения поля answer характеризуют степень выраженности
условия.
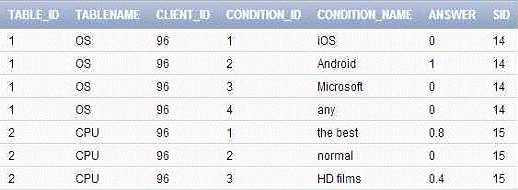
Рисунок 6 - пример заполнения таблицы data
Таблица data_clients (рисунок 7) - содержит личную информацию о клиентах, данные об областях в которых он работает, а также номер пользователя (является уникальным), к которому он «привязан». Например, в случае постановки медицинского диагноза, клиентом является пациент, а пользователем - доктор. Таким образом, каждый клиент должен быть привязан к какому-либо пользователю.
Клиент в каждый момент времени может находиться только в одной системе, области и подобласти. Учётная запись клиента создаётся пользователем, данные в таблицу так же добавляются пользователем. При этом пользователь имеет право редактировать данные только своих клиентов.
Данные о текущей таблице решения и номере продукции заносятся
автоматически в процессе работы с системой.
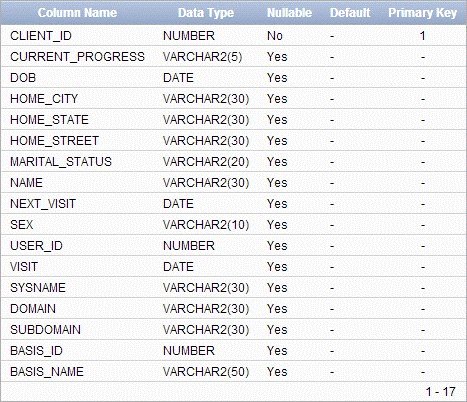
Рисунок
7 - таблица data_clients
Здесь: current_progress - номер текущей таблицы решения и номер продукции, dob - дата рождения, home_city - город проживания, home_state - штат/область, home_street - улица, marital_status - семейное положение, name - имя, next_visit - дата последнего посещения, sex - пол, user_id - номер пользователя, к которому привязан клиент, visit - первичный визит, basis_id и basis_name - id и название базиса с которым работает клиент. Базис для каждого клиента устанавливается пользователем перед началом работы системы и сохраняется до её окончания.
Таблица data_users (рисунок 8) - содержит личную информацию о всех
пользователях, работающих с системой: имя, адрес, id, названия системы, области
и подобласти, с которыми работает данный пользователь, а также логин и пароль
для входа в систему. Причём логин является уникальным и не может быть
одинаковым у разных пользователей. Данные пользователя заносятся в таблицу
автоматически при регистрации пользователя в системе. При этом пользователь
может находиться только в одной области и подобласти.
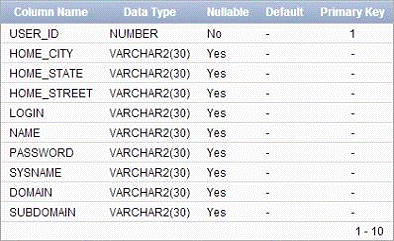
Рисунок 8 - таблица data_users
Таблица decision (рисунок 9) - хранит все таблицы
принятия решений, т.е. при добавлении новых таблиц решений не требуется
создание новых таблиц в базе для их хранения. Наборам ответов на условия,
хранящимся в столбце conditions, соответствуют наборы действий и последействий (actions и aftereffects).
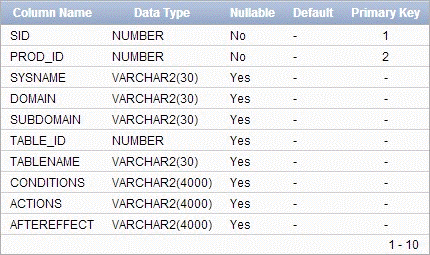
Рисунок 9 - таблица decision
Здесь: prod_id - номер соответствующей продукции, sid - суррогатный ключ, генерирующийся автоматически при
помощи триггера, conditions -
комбинация ответов на условия, actions
- содержит комбинацию действий, соединенные между собой логическим «И», aftereffect - последействие (переход на другую
таблицу/продукцию). Для столбца conditions допустимы логические операции: and
(&) и or (||).
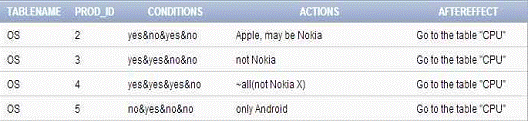
Рисунок 10 - пример заполнения таблицы decision
Данные в таблицу decision заносятся администратором и не могут редактироваться пользователями и клиентами.
Таблица metadata (рисунок 11) - содержит списки всех
условий и действий, соответствующих данной таблице принятия решений, названия
системы, области и подобласти, к которым принадлежит эта таблица, а также
вспомогательные поля для верного построения логического условия, такие как: type, определяющее «вид» ответа клиента: checkbox, в случае ограниченного ввода, и text, в случае расширенного ввода
(например, значение температуры); connection - определяет тип соединения данного условия с последующим («AND» или «OR»); brackets - наличие открывающей или закрывающей скобок. Для поддержки нечётких
логик используются следующий поля: condition_weight и action_weight - вес условий и действий, значения от 0 до 1; prod_limit - «порог» значения продукции, т.е. продукции,
значение которых ниже этого порога, не рассматриваются в дальнейшей работе
системы. Данные в таблицу также заносятся администратором и недоступны
пользователям и клиентам для редактирования.