Материал: 00464
Учитывая,
что цикл for
в строке
 повторяется
раз,
где
-
число вершин графа, получаем общую
оценку трудоемкости
 .
Необходимо отметить, что эта оценка
справедлива в предположении, что время,
требуемое для просмотра окрестности
вершины, пропорционально степени этой
вершины. Это имеет место, например, если
граф задан списками смежности. Если же
граф задан матрицей смежности, то для
просмотра окрестности любой вершины
будет затрачиваться время, пропорциональное
.
В этом случае общее время работы алгоритма
будет оцениваться как
 .
Наибольшее значение величины
при
данном
равно
 ,
т.е. имеет порядок
 .
Таким образом, трудоемкость алгоритма
поиска в ширину при задании графа
списками смежности не выше, чем при
задании матрицей смежности. В целом же
первый способ задания предпочтительнее,
так как дает выигрыш для графов с
небольшим числом ребер.
В
качестве простейшего примера применения
поиска в ширину для графа рассмотрим
задачу выявления компонент связности.
Допустим, мы хотим получить ответ в виде
таблицы, в которой для каждой вершины
указан
номер
 компоненты,
которой принадлежит эта вершина.
Компоненты будут получать номера в
процессе обхода. Для решения этой задачи
достаточно ввести переменную
со
значением, равным текущему номеру
компоненты, и каждый раз при посещении
новой вершины
полагать
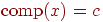 .
Значение
первоначально
устанавливается равным
и
модифицируется при каждом вызове
процедуры BFS.
BFS-дерево и вычисление расстояний
Другая простая задача, для решения которой можно применить поиск в ширину, - построение каркаса. Напомним, что каркасом графа называется остовный лес, у которого области связности совпадают с областями связности графа. Каркас связного графа - остовное дерево.
Ребра, исследуемые в процессе обхода графа, можно разделить на две категории: если ребро соединяет активную вершину с новой вершиной , то оно классифицируется как прямое, в противном случае - как обратное. В зависимости от решаемой задачи прямые и обратные ребра могут подвергаться различной обработке.
Предположим, что алгоритм поиска в ширину применяется к связному графу. Покажем, что в этом случае по окончании обхода множество всех прямых ребер образует дерево. Действительно, допустим, что на некотором шаге работы алгоритма обнаруживается новое прямое ребро , а множество прямых ребер, накопленных к этому шагу, образует дерево . Тогда вершина принадлежит дереву , а вершина не принадлежит ему. Поэтому при добавлении к дереву ребра связность сохранится, а циклов не появится.
Итак, если применить поиск в ширину к связному графу и запомнить все прямые ребра, то получим каркас графа. Для произвольного графа будет получен лес, также, очевидно, являющийся каркасом.
Каркас,
который будет построен описанным образом
в результате поиска в ширину в связном
графе, называется BFS-деревом.
Его можно рассматривать как корневое
дерево с корнем в стартовой вершине
.
BFS-дерево с заданным корнем
,
вообще говоря, не единственное - зависит
от того, в каком порядке просматриваются
окрестности вершин. Однако всякое
BFS-дерево обладает свойством, на котором
и основаны наиболее важные применения
поиска в ширину. Каркас
 связного
графа
с
корнем
назовем
геодезическим
деревом,
если для любой вершины
путь
из
в
в
дереве
является
кратчайшим путем между
и
в
графе
.
Теорема 1. Любое BFS-дерево является геодезическим деревом.
Доказательство.
Обозначим через
 множество
всех вершин графа, находящихся на
расстоянии
от
стартовой вершины
.
Работа алгоритма начинается с посещения
стартовой вершины, т.е. единственной
вершины, составляющей множество
 .
При первом выполнении цикла while
будут посещены и помещены в очередь все
вершины из множества
 .
Затем эти вершины будут одна за другой
извлекаться из очереди, становиться
активными, и для каждой из них будут
исследоваться все смежные вершины. Те
из них, которые еще не посещались, будут
посещены и помещены в очередь. Но это
как раз все вершины из множества
 (когда
начинается исследование окрестностей
вершин из
,
ни одна вершина из
еще
не посещалась и каждая из них смежна
хотя бы с одной вершиной из
).
Следовательно, каждая вершина из
будет
посещена после всех вершин из
.
Рассуждая далее таким образом, приходим
к следующему выводу.
(А)
Все вершины из
 будут
посещены после всех вершин из
,
 .
Строгое доказательство легко провести индукцией по . Отметим еще следующий факт.
(Б) Если активной является вершина из , то в этот момент все вершины из уже посещены.
В
самом деле, из (А) следует, что вершины
из
попадут
в очередь после вершин из
 .
Поэтому, когда первая вершина из
становится
активной, все вершины из
уже
закрыты. Значит, к этому моменту
окрестности всех вершин из
полностью
исследованы, и, следовательно, все
вершины из
посещены.
Рассмотрим
теперь момент работы алгоритма, когда
активной является вершина
 и
обнаруживается смежная с ней новая
вершина
.
В BFS-дереве расстояние между
и
на
1 больше, чем расстояние между
и
.
В графе расстояние между
и
не
больше, чем
 ,
так как
и
смежны.
Ввиду (А) это расстояние не может быть
меньше
,
а ввиду (Б) оно не может быть равно
.
Значит,
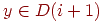 ,
т.е. в графе расстояние между
и
тоже
на 1 больше, чем расстояние между
и
.
Следовательно, если до какого-то момента
работы алгоритма расстояния от каждой
из посещенных вершин до стартовой
вершины в графе и в дереве были равны,
то это будет верно и для вновь посещаемой
вершины. Поскольку это верно вначале,
когда имеется единственная посещенная
вершина
(оба
расстояния равны
),
то это останется верным и тогда, когда
будут посещены все вершины.
Итак,
мы можем применить поиск в ширину для
вычисления расстояний от стартовой
вершины
до
всех остальных вершин графа - нужно
только в процессе обхода для каждой
посещаемой вершины
определять
расстояние от
до
в
BFS-дереве. Это сделать легко:
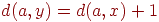 ,
где
-
активная вершина. Вначале устанавливаем
 .
Если
граф несвязен, некоторые расстояния
будут бесконечными. Чтобы учесть эту
возможность, положим вначале
 для
всех
 .
Пока вершина
остается
новой, для нее сохраняется значение
,
когда же она посещается,
 становится
равным расстоянию между
и
и
больше не меняется. Таким образом,
бесконечность расстояния можно
использовать как признак того, что
вершина новая. Если по окончании работы
для
некоторой вершины
,
это означает, что
не
достижима из
,
то есть принадлежит другой компоненте
связности.
Для
того чтобы не только определять
расстояния, но и находить кратчайшие
пути от
до
остальных вершин, достаточно для каждой
вершины
знать
ее отца
 в
BFS-дереве. Очевидно, что
 ,
где
-
вершина, активная в момент посещения
вершины
.
Заполнение таблицы
фактически
означает построение BFS-дерева.
Модифицируя процедуру BFS с учетом сделанных замечаний, получаем следующий алгоритм:
Алгоритм 2.Построение BFS-дерева и вычисление расстояний от вершины до всех остальных вершин:
for
 do
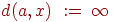
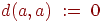
while do
for
 do
if

then
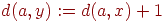

Процедура поиска в глубину
Поиск в глубину - вероятно, наиболее важная ввиду многочисленности приложений стратегия обхода графа. Идея этого метода - идти вперед в неисследованную область, пока это возможно, если же вокруг все исследовано, отступить на шаг назад и искать новые возможности для продвижения вперед. Метод поиска в глубину известен под разными названиями, например, "бэктрекинг", "поиск с возвращением".
Понятия новой, открытой, закрытой и активной вершин для поиска в глубину имеют такой же смысл, как и для поиска в ширину. Отметим, что всегда имеется не более чем одна активная вершина.
Обход
начинается с посещения заданной стартовой
вершины
,
которая становится активной и единственной
открытой вершиной. Затем выбирается
инцидентное вершине
ребро
 и
посещается вершина
.
Она становится открытой и активной.
Заметим, что при поиске в ширину вершина
оставалась
активной до тех пор, пока не были
исследованы все инцидентные ей ребра.
В дальнейшем, как и при поиске в ширину,
каждый очередной шаг начинается с выбора
активной вершины из множества открытых
вершин. Если все ребра, инцидентные
активной вершине
,
уже исследованы, она превращается в
закрытую. В противном случае выбирается
одно из неисследованных ребер
,
это ребро исследуется. Если вершина
новая,
то она посещается и превращается в
открытую.
Главное отличие от поиска в ширину состоит в том, что при поиске в глубину в качестве активной выбирается та из открытых вершин, которая была посещена последней. Для реализации такого правила выбора наиболее удобной структурой хранения множества открытых вершин является стек: открываемые вершины складываются в стек в том порядке, в каком они открываются, а в качестве активной выбирается последняя вершина. Схематически это показано на рис. 2.2.
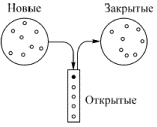
Рис. 2.2.
Обозначим
стек для открытых вершин через
 ,
остальные обозначения сохраняют тот
же смысл, что и в предыдущем разделе.
Через
 обозначается
верхний элемент стека (т.е. последний
элемент, добавленный к стеку). Тогда
процедура обхода одной компоненты
связности методом поиска в глубину со
стартовой вершиной
может
быть записана следующим образом (DFS -
Depth First Search).
Procedure DFS(a)
посетить вершину

while
 do

if имеется неисследованное ребро
then исследовать ребро
if вершина новая
then посетить вершину

else удалить из
Еще раз обратим внимание на основное отличие этой процедуры от аналогичной процедуры поиска в ширину. При поиске в ширину вершина, став активной, остается ею, пока не будет полностью исследована ее окрестность, после чего она становится закрытой. При поиске в глубину, если в окрестности активной вершины обнаруживается новая вершина , то помещается в стек и при следующем повторении цикла while станет активной. При этом остается в стеке и через какое-то время снова станет активной. Иначе говоря, ребра, инцидентные вершине , будут исследованы не подряд, а с перерывами.
Алгоритм обхода всего графа - тот же, что и в случае поиска в ширину (алгоритм 1), только нужно очередь заменить стеком, а процедуру BFS - процедурой DFS.
Свойства
1 и 2 поиска в ширину, отмеченные в
предыдущем разделе, сохраняются и для
поиска в глубину. Остается верной и
оценка трудоемкости
,
но ее доказательство требует несколько
иных рассуждений, так как каждая вершина
теперь может становиться активной
несколько раз. Однако каждое ребро
рассматривается только два раза (один
раз для каждой инцидентной ему вершины),
поэтому в операторе if
в строке 5 ветвь then
(строки 6-9) повторяется
раз.
В этом же операторе ветвь else
(строка 10) повторяется
 раз,
так как каждая вершина может быть удалена
из стека только один раз. В целом
получается
,
причем остаются справедливыми сделанные
замечания об условиях, при которых имеет
место эта оценка.
DFS-дерево
Поиск в глубину можно применить для нахождения компонент связности графа или для построения каркаса точно таким же образом, как поиск в ширину. Понятия прямого и обратного ребра определяются так же, как в предыдущем разделе и так же доказывается, что прямые ребра при поиске в глубину образуют каркас графа. Для связного графа каркас, получаемый поиском в глубину, называется DFS-деревом. DFS-дерево рассматривается как корневое дерево с корнем в стартовой вершине . Это дерево обладает особыми свойствами, на использовании которых основаны многочисленные применения метода поиска в глубину. Рассмотрим наиболее важное из этих свойств.
Относительно
любого корневого остовного дерева все
ребра графа, не принадлежащие дереву,
можно разделить на две категории. Ребро
назовем продольным,
если одна из его вершин является предком
другой, в противном случае ребро назовем
поперечным.
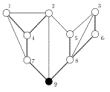
В примере на рис.
2.3
ребра каркаса выделены жирными линиями,
корень - черным кружком. Обратные ребра
показаны тонкими линиями, из них
продольными являются ребра
 ,
 ,
 ,
а поперечными - ребра
 ,
 ,
 .