Материал: 1 ИССЛЕДОВАННИЕ ДИСКРЕТНЫХ ИСТОЧНИКОВ ИНФОРМАЦИИ
Таблица 1.1
Распределение вероятности букв в текстах
Символ |
Вероятность |
Символ |
Вероятность |
Символ |
Вероятность |
Символ |
Вероятность |
Украинский текст |
|||||||
Пробел |
0,122 |
Р |
0,040 |
3 |
0,018 |
Ж |
0,007 |
О |
0,090 |
С |
0,034 |
Й |
0,017 |
Ц |
0,006 |
А |
0,074 |
Л |
0,034 |
Б |
0,016 |
Ю |
0,006 |
И |
0,059 |
К |
0,032 |
Я |
0,015 |
Ї |
0,006 |
І |
0,055 |
У |
0,032 |
Г |
0,013 |
Є |
0,003 |
Н |
0,053 |
Д |
0,026 |
Ч |
0,012 |
Ф |
0,002 |
В |
0,047 |
П |
0,026 |
Ш |
0,010 |
|
|
Т |
0,044 |
М |
0,023 |
X |
0,008 |
|
|
Е |
0,041 |
Ь |
0,021 |
Щ |
0,008 |
|
|
Русский текст |
|||||||
Пробел |
0,175 |
Р |
0,040 |
Я |
0,018 |
Х |
0,009 |
О |
0,089 |
В |
0,038 |
Ы |
0,016 |
Ж |
0,007 |
Е, Ё |
0,072 |
Л |
0,035 |
З |
0,016 |
Ю |
0,006 |
А |
0,062 |
К |
0,028 |
Ь, Ъ |
0,014 |
Ш |
0,006 |
И |
0,062 |
М |
0,026 |
Б |
0,014 |
Ц |
0,004 |
Т |
0,053 |
Д |
0,025 |
Г |
0,013 |
Щ |
0,003 |
Н |
0,053 |
П |
0,023 |
Ч |
0,012 |
Э |
0,003 |
С |
0,045 |
У |
0,021 |
Й |
0,010 |
Ф |
0,002 |
Английский текст |
|||||||
Пробел |
0,198 |
R |
0,054 |
U |
0,022 |
V |
0,008 |
Е |
0,105 |
S |
0,052 |
М |
0,021 |
К |
0,003 |
Т |
0,072 |
Н |
0,047 |
Р |
0,017 |
X |
0,002 |
О |
0,065 |
D |
0,035 |
Y |
0,012 |
J |
0,001 |
А |
0,063 |
L |
0,029 |
W |
0,012 |
Q |
0,001 |
N |
0,059 |
С |
0,023 |
G |
0,011 |
Z |
0,001 |
І |
0,055 |
F |
0,022 |
В |
0,010 |
|
|
Помимо неравновероятности появления букв, буквы в тексте зависимы. Так, после гласных не может появиться "Ь", мала вероятность сочетания более трёх согласных подряд, вероятность последовательности, не образующей осмысленных слов (идеальный источник), практически равна нулю. Расчёты показывают, что для текстов русской художественной прозы энтропия оказывается менее 1,5 бит на букву. Еще меньше, около 1 бита на букву, энтропия поэтических произведений, так как в них имеются дополнительные вероятностные связи, обусловленные ритмом и рифмами. Слово, рифмуемое с окончанием предыдущей стихотворной строки, легко угадывается без произнесения или чтения его, и поэтому информации не несет (I(xi) = 0). Энтропия телеграмм обычно не превышает 0,8 бит на букву, поскольку их тексты довольно однообразны (особенно поздравительных).
Условная энтропия
Как уже отмечалось, для эффективного кодирования информации необходимо учитывать статистическую зависимость сообщений. Наша ближайшая цель – научиться подсчитывать информационные характеристики последовательностей зависимых сообщений. Начнем с двух сообщений.
Рассмотрим ансамбли X = {xi} и Y={yj} и их произведение XY={(xi,yj), P(xi,yj)}. Для любого фиксированного yjY можно построить условное распределение вероятностей P(xi/yj) на множестве X и для каждого xiX подсчитать собственную информацию
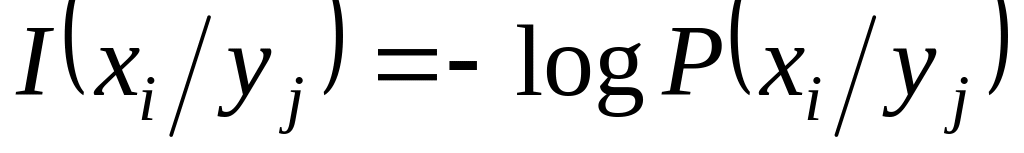 ,
которую называют условной собственной информацией сообщения xi при фиксированном yj.
Ранее мы назвали энтропией ансамбля X среднюю информацию сообщений xiX. Аналогично, усреднив условную информацию I(xi/yj) по xiX, получим величину
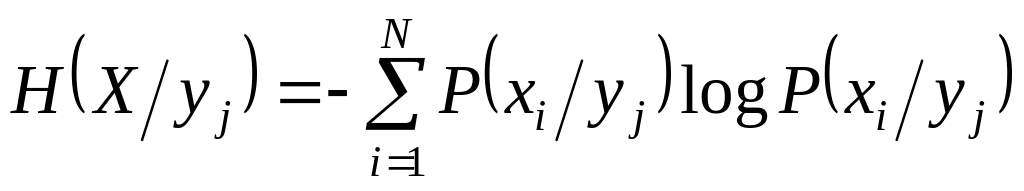 ,
называемую условной энтропией X при фиксированном yjY. Заметим, что в данном определении имеет место неопределенность в случае, когда P(xi/yj)=0. Следует отмечалось, что выражение вида z log z стремится к нулю при z 0 и на этом основании мы считаем слагаемые энтропии, соответствующие буквам xi с вероятностью P(xi/yj)=0, равными нулю.
Вновь введенная энтропия H(X/yj) – случайная величина, поскольку она зависит от случайной переменной yj. Чтобы получить неслучайную информационную характеристику пары вероятностных ансамблей, нужно выполнить усреднение по всем значениям yj. Величина
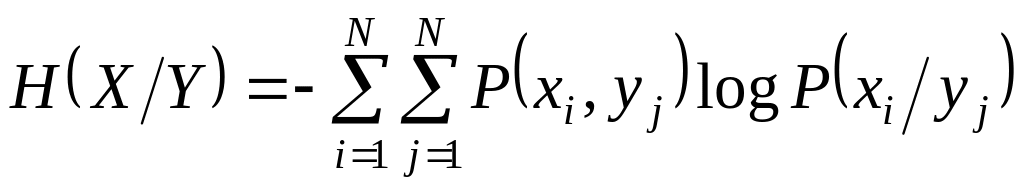
называется условной энтропией ансамбля X при фиксированном ансамбле Y . Отметим ряд свойств условной энтропии.
1.
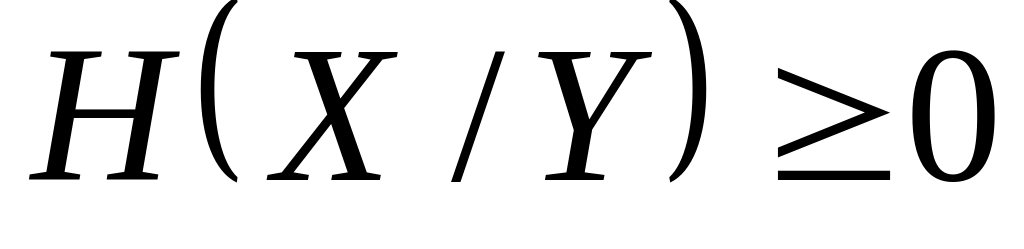 .
2.
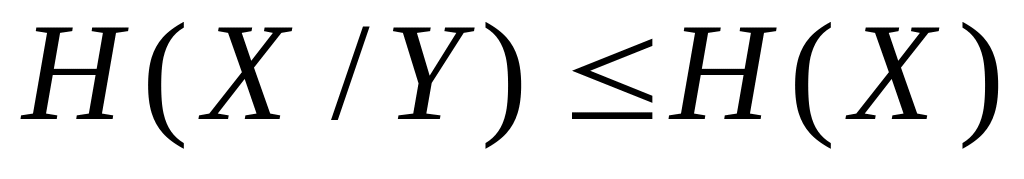 ,
причем равенство имеет место в том и
только в том случае, когда ансамбли X
и Y
независимы.
3.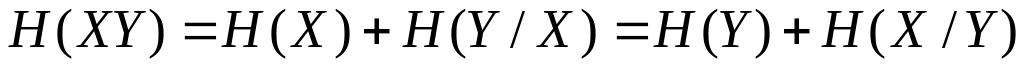 .
4.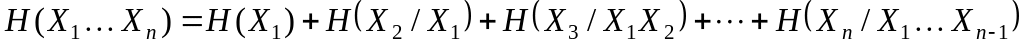 .
5.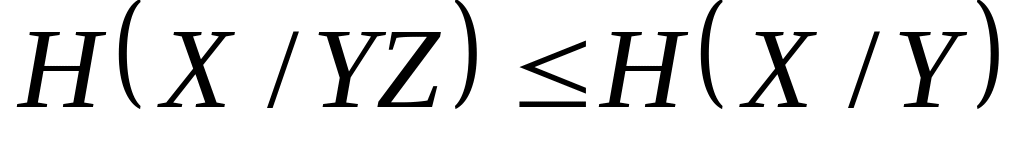 причем
равенство имеет место в том и только в
том случае, когда ансамбли X
и Y
условно
независимы при всех z
Z.
Обсудим «физический смысл» сформулированных свойств условной энтропии. Свойство 2 устанавливает, что условная энтропия ансамбля не превышает его безусловной энтропии. Свойство 5 усиливает это утверждение. Из него следует, что условная энтропия не увеличивается с увеличением числа условий. Оба эти факта неудивительны, они отражают тот факт, что дополнительная информация об ансамбле X, содержащаяся в сообщениях других ансамблей, в среднем, уменьшает информативность (неопределенность) ансамбля X . Замечание «в среднем» здесь очень важно, поскольку неравенство H(X/yj) ≤ H(X), вообще говоря, не верно.
Из свойств 1 – 5 следует неравенство
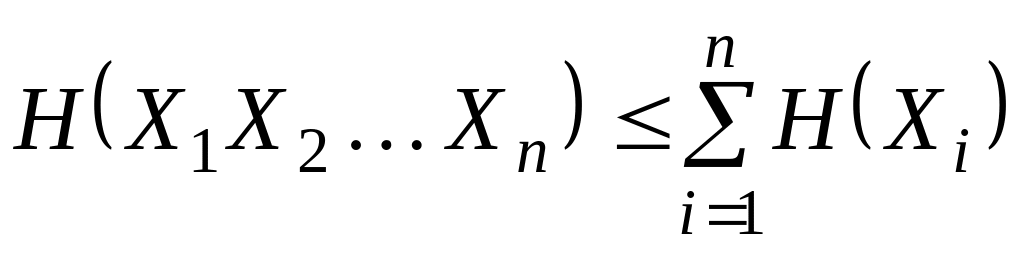 , (1.4)
в котором равенство возможно только в случае совместной независимости ансамблей X1, …, Xn.
Напомним, что вычисление энтропии – это вычисление затрат на передачу или хранение букв источника. Свойства условной энтропии подсказывают, что при передаче буквы Xn+1 следует использовать то обстоятельство, что предыдущие буквы X1, …, Xn уже известны на приемной стороне. Это позволит вместо H(Xn+1) бит потратить меньшее количество H(Xn+1/X1,…,Xn) бит. В то же время неравенство (1.4) указывает другой подход к экономному кодированию. Из этого неравенства следует, что буквы перед кодированием нужно объединять в блоки и эти блоки рассматривать как буквы нового «расширенного» источника. Затраты будут меньше, чем при независимом кодировании букв. Какой из двух подходов эффективнее?
Ниже мы дадим более точную количественную характеристику этих двух подходов, но перед этим нам нужно вспомнить некоторые определения из теории вероятностей.
Дискретные случайные последовательности. Цепи Маркова
Вместо отдельных ансамблей и произведений конечного числа ансамблей мы будем рассматривать теперь случайные последовательности из произвольного числа событий. Если элементы случайной последовательности – вещественные числа, то такие последовательности называются случайными процессами.
Номер элемента в последовательности трактуется как момент времени, в который появилось данное значение. Вообще говоря, множество значений времени может быть непрерывным либо дискретным, множество значений случайной последовательности также может быть непрерывным либо дискретным. Сейчас нас интересуют только дискретные процессы дискретного времени.
Случайный процесс x1, x2, … со значениями xiX, i = 1, 2, … задан, если для любых n указан способ вычисления совместных распределений вероятностей P(x1…xn).
Проще всего задать случайный процесс, предположив, что его значения в различные моменты времени независимы и одинаково распределены. Тогда
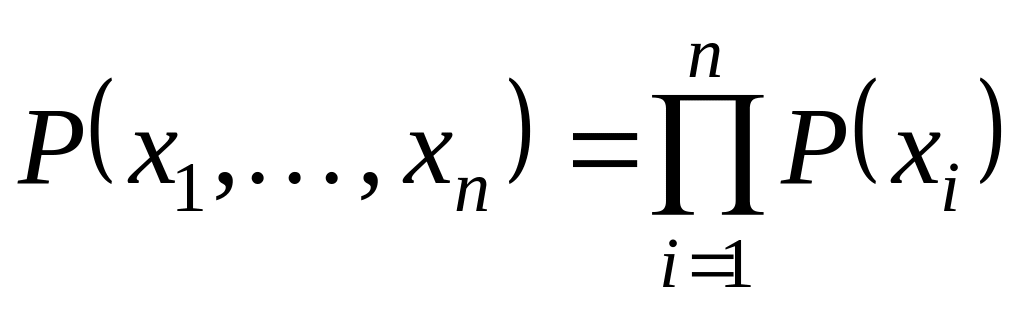 ,
где P(xi) – вероятность появления xiX в момент времени i. Для описания такого процесса достаточно указать вероятности P(xi) для всех xiX (всего N - 1 вероятностей).
Описание более сложных моделей процессов будет громоздким, если не сделать упрощающих предположений. Нам не обойтись без предположения о стационарности.
Процесс называется стационарным, если для любых n и m имеет место равенство
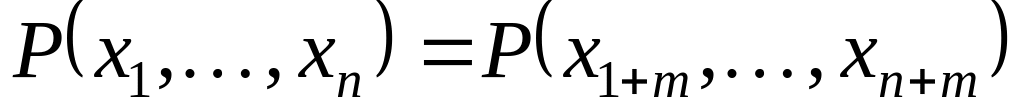 ,
в котором подразумевается, что xi=xi+m, i=1, …, n.
Иными словами, случайный процесс стационарен, если вероятность любой последовательности не изменяется при ее сдвиге во времени (не зависит от положения последовательности на оси времени).
Числовые характеристики, в частности, математическое ожидание стационарных процессов не зависят времени. Рассматривая стационарные процессы, мы сможем вычислять независящие от времени информационные характеристики случайных процессов.
Мы уже рассмотрели один пример стационарного процесса – процесс, значения которого независимы и одинаково распределены. Источник, порождающий такой процесс, называют дискретным постоянным источником (ДПИ).
Простейшей моделью источника, порождающего зависимые сообщения, является марковский источник.
Случайный
процесс x1,
x2, …
называют цепью
Маркова связности s ,
если для любых n
и для любых
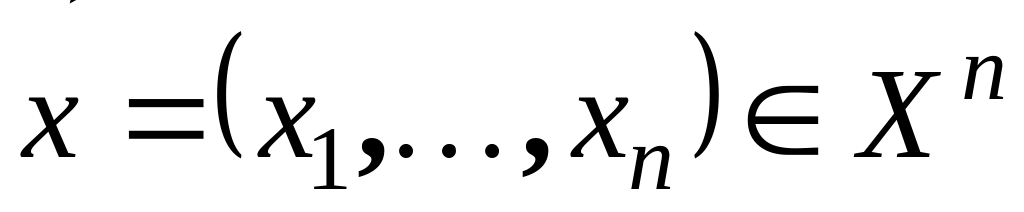 справедливы соотношения
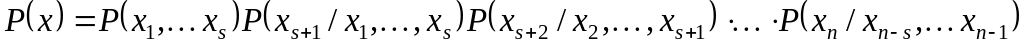 .
Иными словами, мы называем марковским процессом связности s такой процесс, для которого при n > s
P(xn / x1,…,xn-1)= P(xn / xn-s,…,xn-1),
то есть условная вероятность текущего значения при известных s предшествующих не зависит от всех других предшествующих значениях.
Описание марковского процесса задается начальным распределением вероятностей на последовательностях из первых s значений и условными вероятностями вида P(xn | xn-s,…,xn-1) для всевозможных последовательностей (xn-s,…,xn). Если указанные условные вероятности не изменяются при сдвиге последовательностей (xn-s,…,xn) во времени, марковская цепь называется однородной.
Однородная марковская цепь связности s=1 называется простой цепью Маркова. Для описания простой цепи Маркова с множеством состояний X={1,2,…,N} достаточно указать начальное распределение вероятностей {P(xi),xiX} и условные вероятности
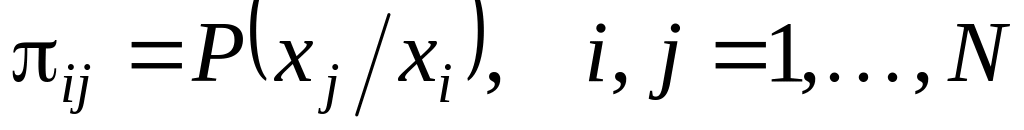 ,
называемые переходными вероятностями цепи Маркова.
Переходные вероятности удобно записывать в виде квадратной матрицы размерности N×N:
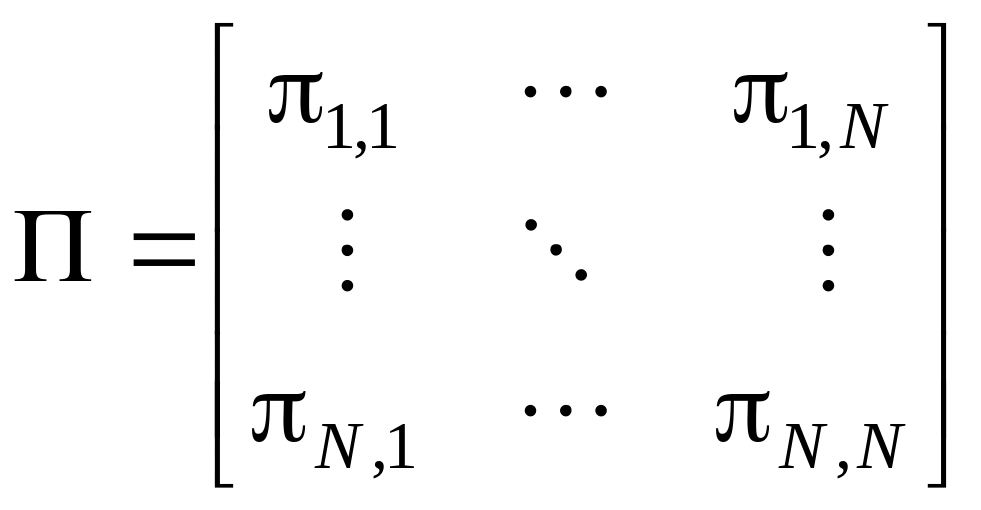
называемой матрицей переходных вероятностей. Эта матрица – стохастическая (неотрицательная, сумма элементов каждой строки равна 1).
Обозначим
через
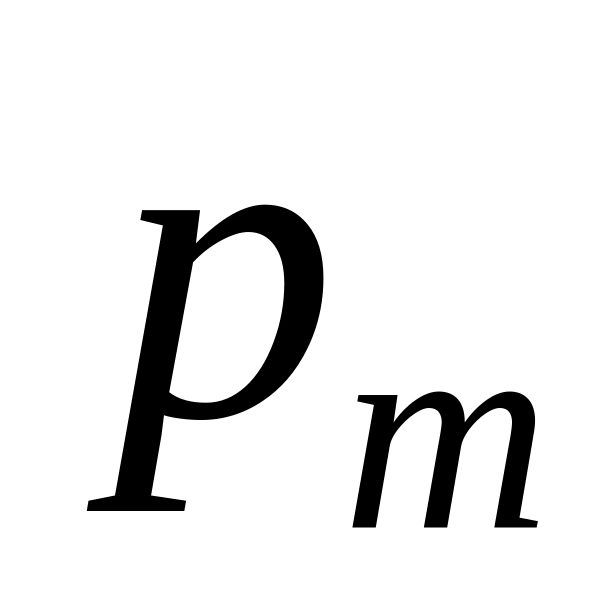 стохастический вектор, компоненты
которого – вероятности состояний цепи
Маркова в момент времени m,
то есть
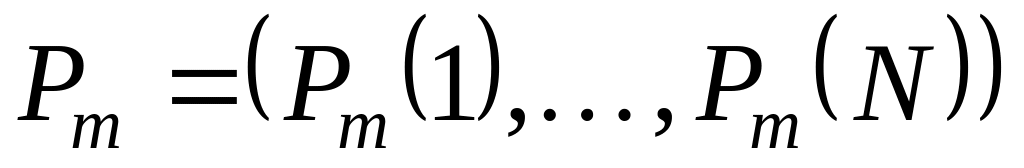 ,
где Pm(i)
есть вероятность состояния i
в момент
времени m,
i = 1, ..., N.
Из формулы полной вероятности следует,
что
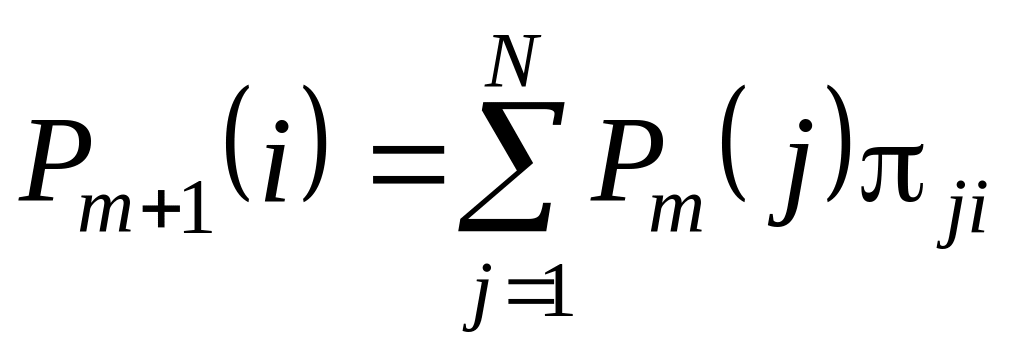
или в матричной форме
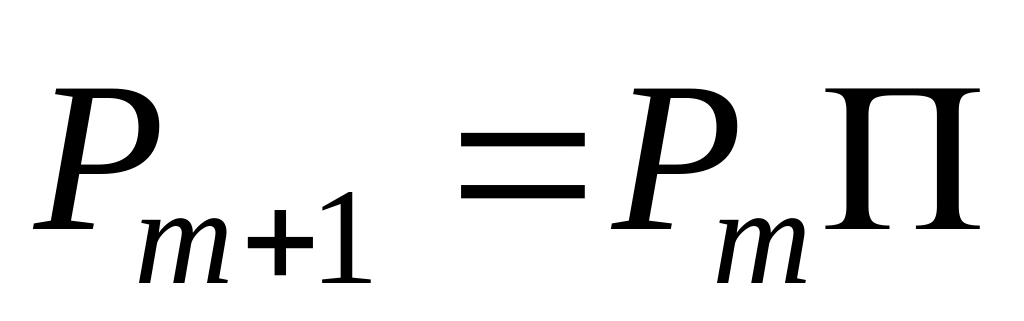 . (1.5)
Отсюда для произвольного числа шагов n получаем
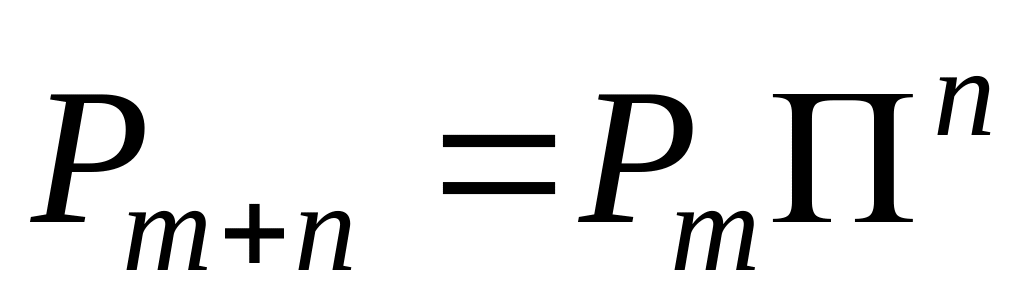 .
Значит, вероятности перехода за n шагов могут быть вычислены как элементы матрицы n.
Из
(1.5) видим, что распределение вероятностей
в момент времени m
зависит от
величины m
и от начального
распределения
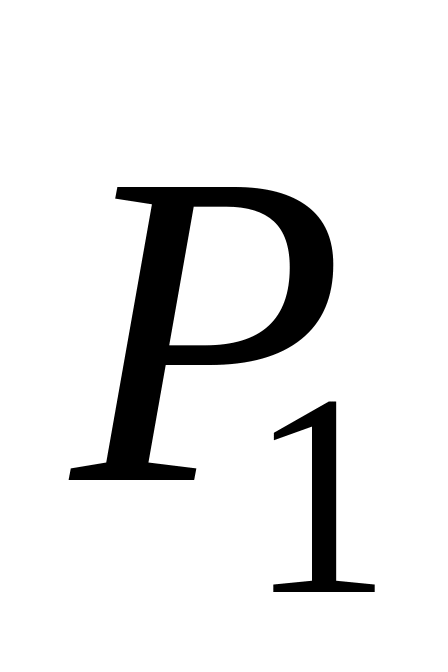 .
Отсюда следует, что в общем случае
рассматриваемый случайный процесс
нестационарен. Предположим, однако, что
существует стохастический вектор
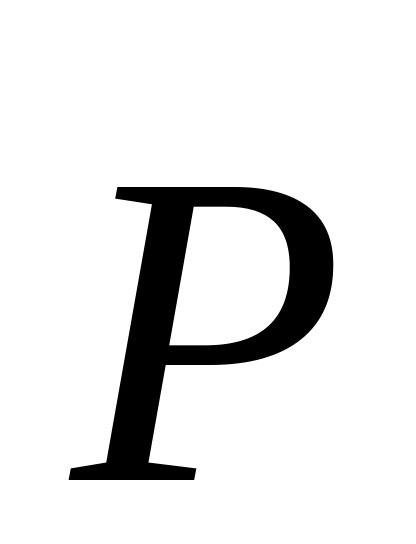 ,
удовлетворяющий уравнению
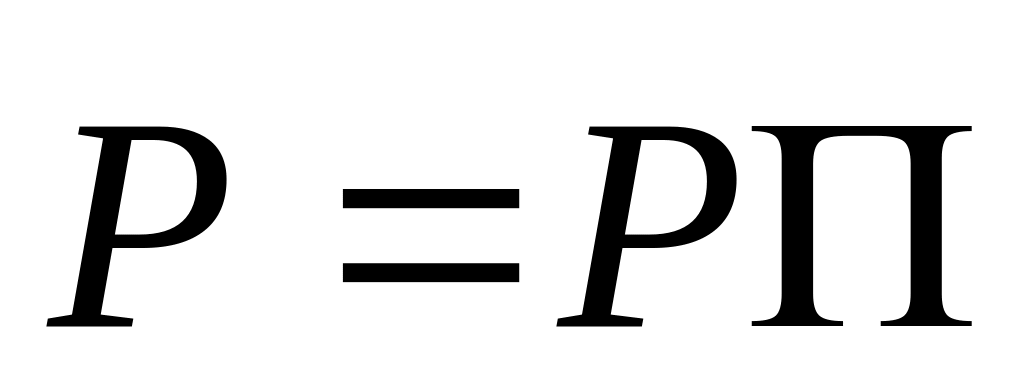 .
(1.6)
Положим
=
.
Тогда, воспользовавшись (1.5), получим
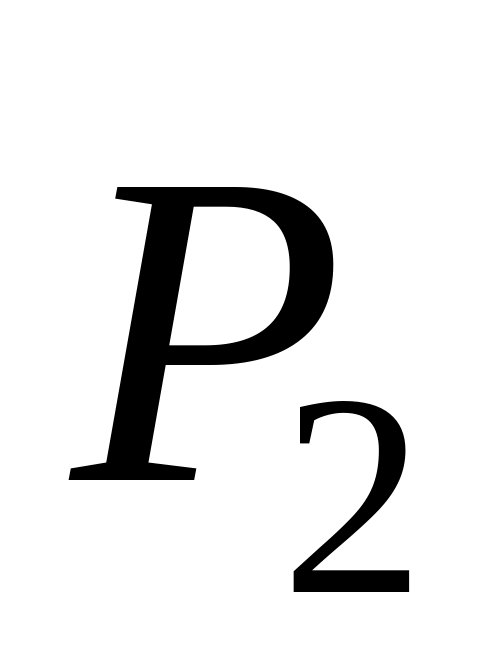 =
и, в конечном итоге,
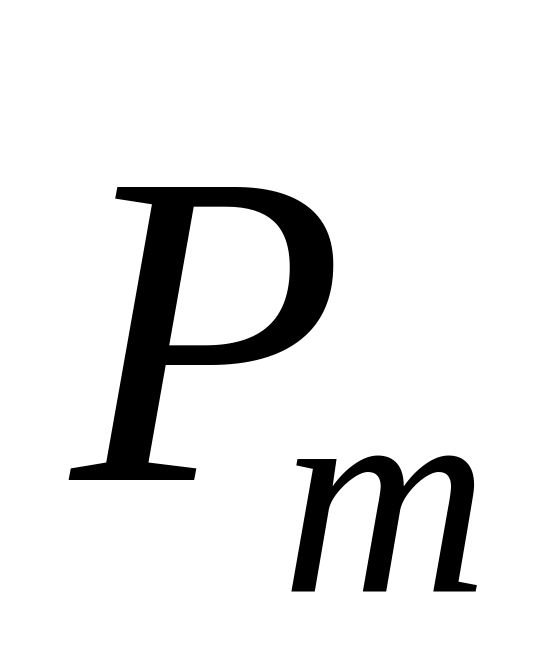 =
при всех m.
Таким образом, однородная марковская
цепь стационарна, если в качестве
начального распределения выбрано
решение уравнения (1.6).
Стохастический вектор , удовлетворяющий уравнению (1.6), называется стационарным распределением для цепи Маркова, задаваемой матрицей переходных вероятностей .
Финальным распределением вероятностей называют вектор
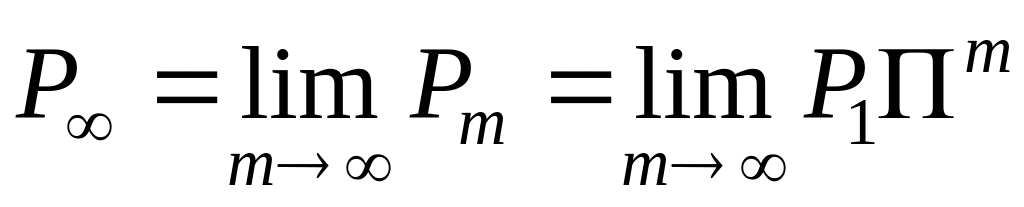 (1.7)
(если предел существует).
Из
этого определения следует, что финальное
распределение – распределение
вероятностей в момент времени m
бесконечно
далекий от начального момента времени
m = 1.
Было бы естественно ожидать, что оно не
зависит от начального распределения
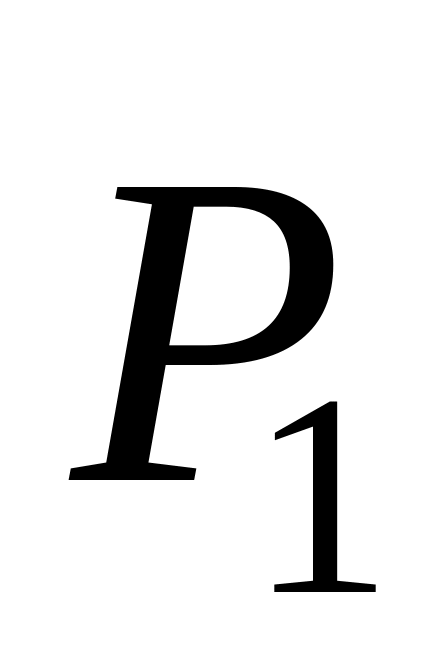 .
Оно не зависит также и от времени. Таким
образом, распределение
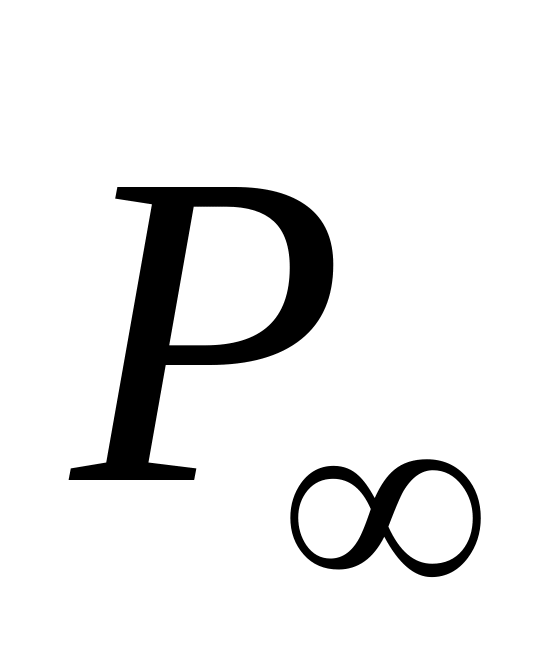 тоже (как
и), в некотором смысле, – стационарное
распределение. Как же соотносятся между
собой
и
?