Материал: 1 ИССЛЕДОВАННИЕ ДИСКРЕТНЫХ ИСТОЧНИКОВ ИНФОРМАЦИИ
Оказывается, для широкого класса простых цепей Маркова предел в (1.7) не зависит от начального распределения и равен единственному решению уравнения (1.6), то есть = . Такие цепи называют эргодическими.
Как определить по матрице эргодична ли соответствующая цепь Маркова? Ответ заведомо положительный, если все элементы матрицы положительны (не равны нулю). Более точное (но и сложнее проверяемое) условие состоит в том, что должна существовать некоторая положительная степень n0 матрицы такая, что все элементы матрицы n положительны при любых n ≥ n0.
Чтобы сформулировать необходимое и достаточное условие эргодичности, придется ввести несколько определений.
Состояние цепи i достижимо из состояния j, если для некоторого n вероятность перехода из состояния j в состояние i за n шагов положительна. Множество состояний C называется замкнутым, если никакое состояние вне C не может быть достигнуто из состояния, входящего в C .
Цепь называется неприводимой, если в ней не больше одного замкнутого множества. Цепь Маркова неприводима, в частности, тогда, когда все ее состояния достижимы друг из друга.
Состояние i называется периодическим, если существует такое m > 1, что вероятность перехода из i в i за n шагов равна нулю при всех n не кратных m. Цепь, не содержащая периодических состояний, называется непериодической.
Непериодическая неприводимая цепь Маркова эргодична.
Энтропия на сообщение дискретного стационарного источника
Рассмотрим произвольный дискретный стационарный источник, порождающий последовательность (x1, x2,…xm,…), xmXm=X. Из предположения о стационарности следует, что распределение вероятностей для буквы xm, порождаемой в момент времени m не зависит от m. Следовательно, величина энтропии этого распределения H(Xn)=H(X) также не зависит от времени. Назовем ее одномерной энтропией источника (или соответствующего случайного процесса). Обозначим ее как H1(X).
Как уже было отмечено, величина H1(X) не определяет полностью информационные характеристики процесса, поскольку не учитывает зависимости букв.
Рассмотрим
последовательность из n
последовательных
букв источника
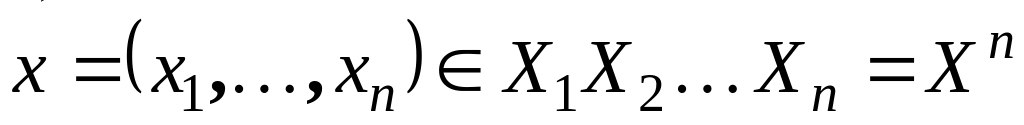 .
Для стационарного процесса энтропия
распределения вероятностей на таких
блоках H(X1X2…Xn)=H(Xn)
не зависит от
расположения блока во времени, ее
называют n
-мерной
энтропией источника.
Величина H(Xn) определяет среднее количество информации в последовательности из n букв. Нормированную величину
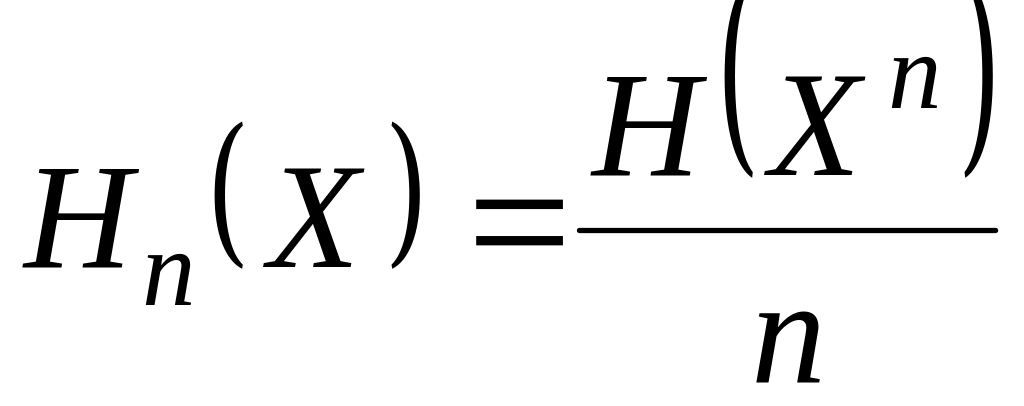
называют энтропией на букву последовательности длины n. Интуиция подсказывает, что значения Hn(X) при больших n могли бы служить адекватной мерой информативности источника.
Другой подход к измерению информации, порождаемой произвольным стационарным источником, состоит в том, что при передаче буквы xn все предыдущие буквы x1, x2,…xn-1 можно считать известными декодеру. Среднее количество подлежащей передаче информации об xn определяется величиной условной энтропии H(Xn / X1X2…Xn-1). В силу стационарности конкретные значения индексов не играют роли, важна лишь длина предыстории. Поэтому используется следующее обозначение:
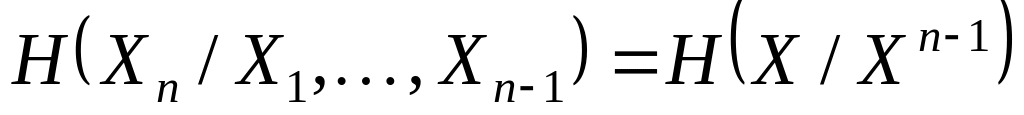 .
Следующая теорема устанавливает некоторые свойства двух информационных мер стационарных источников.
Теорема 1.1. Для дискретного стационарного источника
A. H(X / Xn) не возрастает с увеличением n;
B. Hn(X) не возрастает с увеличением n;
C. Hn(X) ≥ H(X / Xn-1);
D.
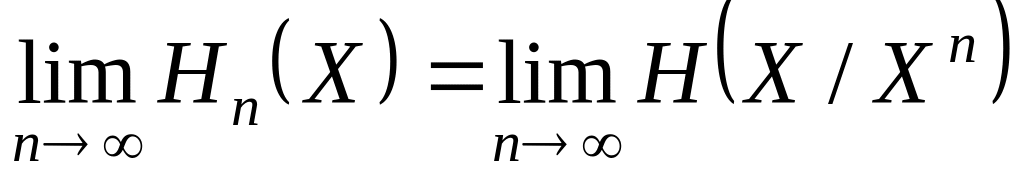 .
Введем обозначения
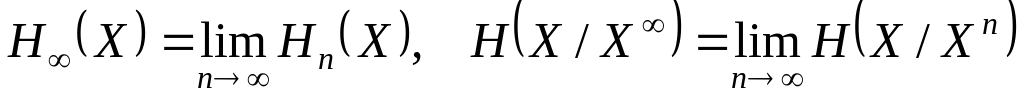 .
Основной результат теоремы состоит в том, что H∞(X) = H(X / X∞). В дальнейшем, при изучении конструктивных методов кодирования, можно убедится в том: что именно эта величина определяет минимально возможные удельные затраты бит на передачу одной буквы стационарного источника.
По сути, мы рассмотрели два подхода к анализу информативности стационарного источника:
- введение расширенного алфавита, буквами которого служат блоки из n символов источника;
- учет зависимости текущей буквы от n предшествующих букв.
Выяснилось, что, хотя при каждом конкретном n второй подход дает более оптимистические оценки затрат на передачу или хранение информации (свойство С), в пределе с увеличением параметра n , подходы становятся эквивалентными.
1.2 Описание лабораторного макета
Лабораторный макет представляет собой программный пакет обладающий следующими функциями:
- проводить оценку статистических и информационных характеристик дискретных источников информации (для источников с наличием и отсутствием зависимости между соседними символами);
- моделирование дискретного постоянного источника информации (ДПИ) и дискретного источника информации с помощью цепи Маркова первого, второго и третьего порядка;
- кодирование и декодирование сообщений источника неравномерным посимвольным кодом Шеннона-Фано, Хафмена
- кодирование и декодирование сообщений источника алгоритмом арифметического кодирования;
- кодирование и декодирование сообщений методами учитывающими взаимозависимость соседних символов («Стопка книг», LZ, LZW).
1.3 Порядок выполнения работы
Перед началом работы задайте программе каталог в который будут помещаться результаты работы.
Провести исследование дискретного источника с помощью модели ДПИ (не учитывающей взаимозависимость символов).
Загрузите заданный преподавателем анализируемый текстовый файл.
Приняв длину символов источника равной одной букве, оценить вероятности появления символов и информационный характеристики источника. Результат занести в отчет (таблица 1.2).
Повторить эксперимент п.п. 2.2 приняв длину символов источника равной двум, трем, четырем буквам. Результат занести в отчет, таблицу заполнить для 10-ти наиболее чаше встречаемых комбинаций.
Повторить эксперимент п.п. 2.2 приняв длину символов источника равной одному биту. Результат занести в отчет.
Сравнить результаты и сделать выводы.
Таблица 1.2
i |
xi |
Pi |
I(xi) |
1 |
|
|
|
2 |
|
|
|
.. |
|
|
|
H(X) =
H1(X) =
Hmax(X) = log(N) =
r= (Hmax(X) - H(X))/Hmax(X) =
Провести исследование дискретного источника с помощью модели учитывающей взаимозависимость символов (цепь Маркова 1-го и выше порядка).
Загрузите заданный преподавателем анализируемый текстовый файл.
Приняв связность цепи Маркова равной единице, оценить условные вероятности появления символов и информационный характеристики источника. Результат занести в отчет (таблица 1.3), таблицу заполнить для двух значений yj соответствующих наиболее чаше встречающимся символам.
Таблица 1.3
I |
xi |
yj= |
yj= |
||
P(xi|yj) |
I(xi|yj) |
P(xi|yj) |
I(xi|yj) |
||
1 |
|
|
|
|
|
2 |
|
|
|
|
|
.. |
|
|
|
|
|
H(X|yj) |
|
|
|||
H(X|Y) =
H1(X|Y) =
Hmax(X|Y) = log(N) =
r = (Hmax(X|Y) - H(X|Y))/Hmax(X|Y) =
Повторить эксперимент п.п. 3.2 приняв связность цепи Маркова равной двум, трем. Результат занести в отчет заполнив таблицы 5.4 и 5.5 аналогично предыдущему пункту.
Таблица 1.4
i |
xi |
yz= |
yz= |
||
P(xi|yz) |
I(xi|yz) |
P(xi|yz) |
I(xi|yz) |
||
1 |
|
|
|
|
|
2 |
|
|
|
|
|
.. |
|
|
|
|
|
H(X|yz) |
|
|
|||
H(X|YZ) =
H1(X|YZ) =
Hmax(X|YZ) = log(N) =
r = (Hmax(X|YZ) - H(X|YZ))/Hmax(X|YZ) =
Таблица 1.5
i |
xi |
yzw= |
yzw= |
||
P(xi|yzw) |
I(xi|yzw) |
P(xi|yzw) |
I(xi|yzw) |
||
1 |
|
|
|
|
|
2 |
|
|
|
|
|
.. |
|
|
|
|
|
H(X|yzw) |
|
|
|||
H(X|YZW) =
H1(X|YZW) =
Hmax(X|YZW) = log(N) =
r = (Hmax(X|YZW) - H(X|YZW))/Hmax(X|YZW) =
Сравнить результаты и сделать выводы.
Моделирование дискретного постоянного источника информации (без учета взаимозависимости символов сообщения).
Загрузите файл с параметрами источника полученный в результате выполнения п.2.2.
Задайте длину сообщения, генерируемую источником равною 1 000 символов.
Получите три реализации сообщения с помощью модели источника, сохраните каждое из сообщений в отдельный файл.
Проанализируйте полученные сообщения согласно методике описанной в п.2.2.
Повторить эксперимент для других значений длины символов источника.
Моделирование дискретного источника информации с учетом взаимозависимости символов сообщения.
Загрузите файл с параметрами источника полученный в результате выполнения п.3.2.
Задайте длину сообщения, генерируемую источником равною 1 000 символов.
Получите три реализации сообщения с помощью модели источника, сохраните каждое из сообщений в отдельный файл.
Проанализируйте полученные сообщения согласно методике описанной в п.3.2.
Повторить эксперимент для других значений связности цепи Маркова.
Используя архиватор, заархивируйте исходный файл, заданный преподавателем и файлы с сообщениями полученный в п.4 и п.5 каждый в отдельный архив. Измерьте длину полученных файлов, определите коэффициент сжатия, результаты занесите в отчет, сделайте выводы.