Материал: 4671
6
очень широки. Выберем в меню пункт Graphs→2D
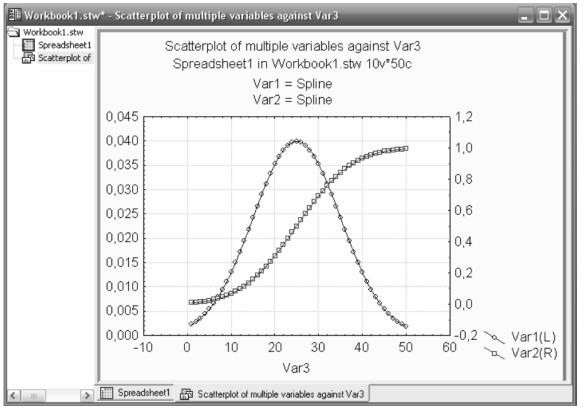
Graphs→Scatterplots…, далее вкладку Advanced в поле Graph type→Double-Y и в поле линии тренда для нашего случая подойдёт сплайн: Fit→Spline. Следующим действием выберем переменные нажав кнопку Variables для X: Var3, для Y Left: Var1 и Y Right: Var2. Далее нажимаем кнопку OK. Результат построения графиков изображен на рисунке 1. Редактирование цветов, надписей, линий сетки, диапазонов и способов подписи шкал, достаточно интуитивен, меню редактирования можно вызвать двойным щелчком левой кнопки мыши расположив указатель над интересующим элементом графика.
Рисунок 1- Результаты моделирования нормального распределения
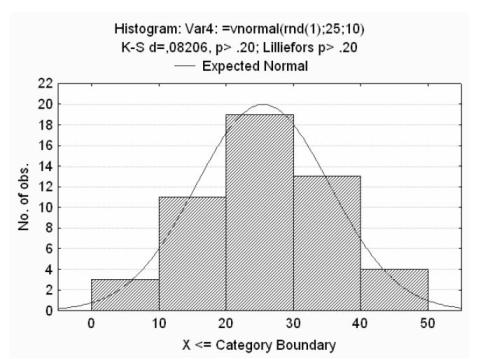
Часто для различных исследований может понадобится случайная величина с определённым законом распределения. Пакет STATISTICA позволяет производить такое моделирование. Рассмотрим случай генерации данных имеющих нормальное распределение. За генерацию случайной величины в диапазоне (0,max) функция =rnd(max), где max – максимальное значение. Введя в нашей рабочей книге в поле Long name (Var4) функцию =vnormal(rnd(1);25;10), мы получим вектор случайных чисел с нормальным законом распределения. Далее можно построить график плотности распределения полученной выборки, воспользуемся разделом главного меню Statistics→Basic Statistics/Tables в появившемся
7
окошке Descriptive statistics, далее выбрать вектор Var4, нажав кнопку Variables, затем нажать кнопку Histograms, результат моделирования показан на рисунке 2. Будет полезным при работе с различными разделами главного меню и опциональных меню STATISTICA поинтересоваться их назначением нажав клавишу F1.
Рисунок 2 - Моделирование случайной величины с распределением по нормальному закону
Лабораторная работа № 2 Применение пакета STATISTICA
Нормальное распределение важно по многим причинам. В большинстве случаев оно является хорошим приближением функций распределения случайной величины. Распределение многих статистик является нормальным или может быть получено из нормальных с помощью некоторых преобразований. Рассуждая философски, можно сказать, что нормальное распределение представляет собой одну из эмпирически проверенных истин относительно общей природы действительности и его положение может рассматриваться как один из фундаментальных законов природы. Точная форма нормального распределения (характерная "колоколообразная кривая") определяется только двумя параметрами: средним и стандартным отклонением.
Характерное свойство нормального распределения состоит в том, что 68% всех его наблюдений лежат в диапазоне ±1 стандартное отклонение от среднего, а диапазон ±2 стандартных отклонения содержит 95% значений.
8
Другими словами, при нормальном распределении, стандартизованные наблюдения, меньшие -2 или большие +2, имеют относительную частоту менее 5% (Стандартизованное наблюдение означает, что из исходного значения вычтено среднее и результат поделен на стандартное отклонение (корень из дисперсии)). Если у вас имеется доступ к пакету STATISTICA, Вы можете вычислить точные значения вероятностей, связанных с различными значениями нормального распределения, используя Вероятностный калькулятор; например, если задать z-значение (т.е. значение случайной величины, имеющей стандартное нормальное распределение) равным 4, соответствующий вероятностный уровень, вычисленный STATISTICA будет меньше .0001, поскольку при нормальном распределении практически все наблюдения (т.е. более 99.99%) попадут в диапазон ±4 стандартных отклонения.
Выбрав в главном меню раздел Statistics→Basic Statistics/Tables
откроется окно в котором можно выбрать Descriptive statistics нужно можно выбрать вектор для которого будет произведён расчёт и нажать кнопку Summary Statistics. В результате (по умолчанию) будет произведён расчёт числа валидных элементов вектора (Valid N), среднего арифметического значения (Mean), стандартного отклонения (Std.Dev.), произведён выбор минимального (Minimum) и максимального (Maximum) значений. Выбрав в окне Descriptive statistics опции можно рассчитать дополнительные параметры.
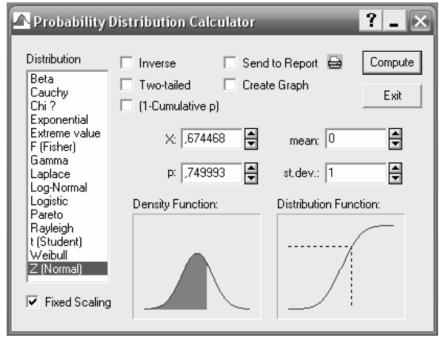
Достаточно часто бывает полезным вероятностный калькулятор (Probability Calculator). Вероятностный калькулятор (рис. 3) позволяет производить расчёт ряда связанных параметров. Выбрать его можно в главном меню Statistics→Probability Calculator→Distributions в
появившемся окошке можно выбрать тип распределения, и исследовать взаимосвязь (в рамках функциональной связи выбранного распределения), следующих величин: среднего значения (mean), стандартного отклонения (st.dev.), вероятности (p) и значения (x: xє X ). Параллельно с выводом значений вероятностный калькулятор производит построение функции плотности (Density Function) и функции распределения (Distributtion Function).
9
Рисунок 3 - Вероятностный калькулятор
Лабораторная работа № 3 Проверка гипотез в пакете STATISTICA
Статистическая значимость (p-уровень) результата представляет собой оцененную меру уверенности в его "истинности" (в смысле "репрезентативности выборки"). Выражаясь более технически, p-уровень (этот термин был впервые использован в работе Brownlee, 1960) это показатель, находящийся в убывающей зависимости от надежности результата. Более высокий p-уровень соответствует более низкому уровню доверия к найденной в выборке зависимости между переменными. Именно, p-уровень представляет собой вероятность ошибки, связанной с распространением наблюдаемого результата на всю популяцию. Например, p-уровень = .05 (т.е. 1/20) показывает, что имеется 5% вероятность, что найденная в выборке связь между переменными является лишь случайной особенностью данной выборки. Иными словами, если данная зависимость в популяции отсутствует, а вы многократно проводили бы подобные эксперименты, то примерно в одном из двадцати повторений эксперимента можно было бы ожидать такой же или более сильной зависимости между переменными. (Отметим, что это не то же самое, что утверждать о заведомом наличии зависимости между переменными, которая в среднем может быть воспроизведена в 5% или 95% случаев; когда между переменными популяции существует зависимость,
10
вероятность повторения результатов исследования, показывающих наличие этой зависимости называется статистической мощностью плана). Во многих исследованиях p-уровень .05 рассматривается как "приемлемая граница" уровня ошибки.
Не существует никакого способа избежать произвола при принятии решения о том, какой уровень значимости следует действительно считать "значимым". Выбор определенного уровня значимости, выше которого результаты отвергаются как ложные, является достаточно произвольным. На практике окончательное решение обычно зависит от того, был ли результат предсказан априори (т.е. до проведения опыта) или обнаружен апостериорно в результате многих анализов и сравнений, выполненных с множеством данных, а также на традиции, имеющейся в данной области исследований. Обычно во многих областях результат p=0.05 является приемлемой границей статистической значимости, однако следует помнить, что этот уровень все еще включает довольно большую вероятность ошибки (5%). Результаты, значимые на уровне p =0.01 обычно рассматриваются как статистически значимые, а результаты с уровнем p=0.005 или p=0.001 как высоко значимые. Однако следует понимать, что данная классификация уровней значимости достаточно произвольна и является всего лишь неформальным соглашением, принятым на основе практического опыта в той или иной области исследования.
Понятно, что чем больше число анализов вы проведете с совокупностью собранных данных, тем большее число значимых (на выбранном уровне) результатов будет обнаружено чисто случайно. Например, если вы вычисляете корреляции между 10 переменными (имеете 45 различных коэффициентов корреляции), то можно ожидать, что примерно два коэффициента корреляции (один на каждые 20) чисто случайно окажутся значимыми на уровне p .05, даже если переменные совершенно случайны и некоррелированы в популяции. Некоторые статистические методы, включающие много сравнений, и, таким образом, имеющие хороший шанс повторить такого рода ошибки, производят специальную корректировку или поправку на общее число сравнений. Тем не менее, многие статистические методы (особенно простые методы разведочного анализа данных) не предлагают какого-либо способа решения данной проблемы. Поэтому исследователь должен с осторожностью оценивать надежность неожиданных результатов. Рассмотрим следующий пример, заимствованный из Nisbett, et al., 1987. Имеются 2 больницы. Предположим, что в первой из них ежедневно рождается 120 детей, во второй только 12. В среднем отношение числа мальчиков, рождающихся в каждой больнице, к числу девочек 50/50. Однажды девочек родилось вдвое больше, чем мальчиков. Спрашивается, для какой больницы данное событие более вероятно? Ответ очевиден для статистика, однако, он не столь очевиден неискушенному. Конечно, такое