Материал: 4671
11
событие гораздо более вероятно для маленькой больницы. Объяснение этого факта состоит в том, что вероятность случайного отклонения (от среднего) возрастает с уменьшением объема выборки.
Рассмотренный пример показывает, что если связь между переменными "объективно" слабая (т.е. свойства выборки близки к свойствам популяции), то не существует иного способа проверить такую зависимость кроме как исследовать выборку достаточно большого объема. Даже если выборка, находящаяся в вашем распоряжении, совершенно репрезентативна, эффект не будет статистически значимым, если выборка мала. Аналогично, если зависимость "объективно" (в популяции) очень сильная, тогда она может быть обнаружена с высокой степенью значимости даже на очень маленькой выборке. Рассмотрим пример.
Представьте, что вы бросаете монету. Если монета слегка несимметрична, и при подбрасывании орел выпадает чаще решки (например, в 60% подбрасываний выпадает орел, а в 40% решка), то 10 подбрасываний монеты было бы не достаточно, чтобы убедить кого бы то ни было, что монета асимметрична, даже если был бы получен, казалось, совершенно репрезентативный результат: 6 орлов и 4 решки. Не следует ли отсюда, что 10 подбрасываний вообще не могут доказать что-либо? Нет, не следует, потому что если эффект, в принципе, очень сильный, то 10 подбрасываний может оказаться вполне достаточно для его доказательства. Представьте, что монета настолько несимметрична, что всякий раз, когда вы ее бросаете, выпадает орел. Если вы бросаете такую монету 10 раз, и всякий раз выпадает орел, большинство людей сочтут это убедительным доказательством того, что с монетой что-то не то. Другими словами, это послужило бы убедительным доказательством того, что в популяции, состоящей из бесконечного числа подбрасываний этой монеты орел будет встречаться чаще, чем решка. В итоге этих рассуждений мы приходим к выводу: если зависимость сильная, она может быть обнаружена с высоким уровнем значимости даже на малой выборке.
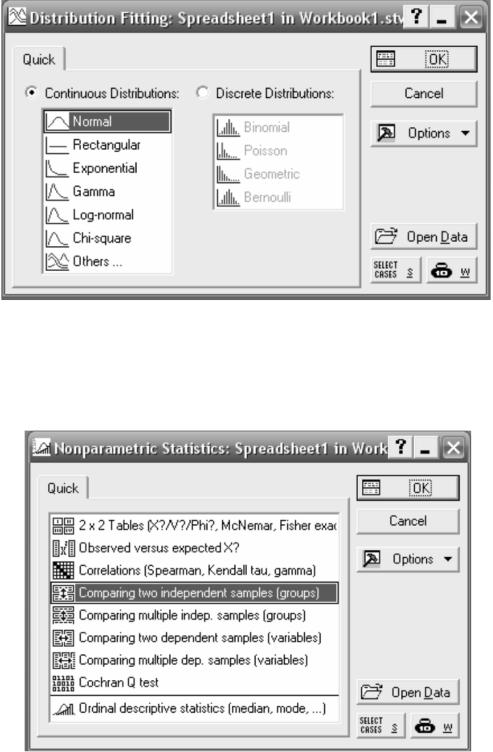
В качестве примера рассмотрим проверку гипотезы о виде распределении по критерию χ2. Для этого в пакете STATISTICA необходимо выполнить следующие действия. В главном меню выбрать Statistics→Distribution Fitting, далее выбрать вид распределения (рис. 4), выбираем Normal. В появившемся окошке необходимо выбрать переменные (вектор), во вкладке Parametrs можно задать дополнительные параметры. Результатом вычислений будет таблица в заголовке которой будет содержаться значение статистики критерия (Chi-Square), число степеней свободы (df) и вычисленный уровень значимости (p). На основании величины (p) принимается или отклоняется гипотеза о нормальном распределении выбранных данных.
12
Рисунок 4 - Окно подбор распределений
Впакете STATTSTICA непараметрические процедуры выполняются
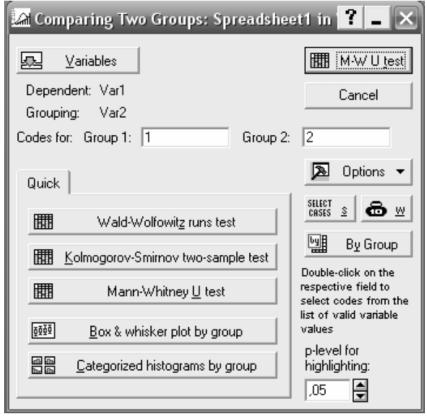
вмодуле Statistics→Nonpametrics (рис. 5).
Рисунок 5 - Непараметрические статистики
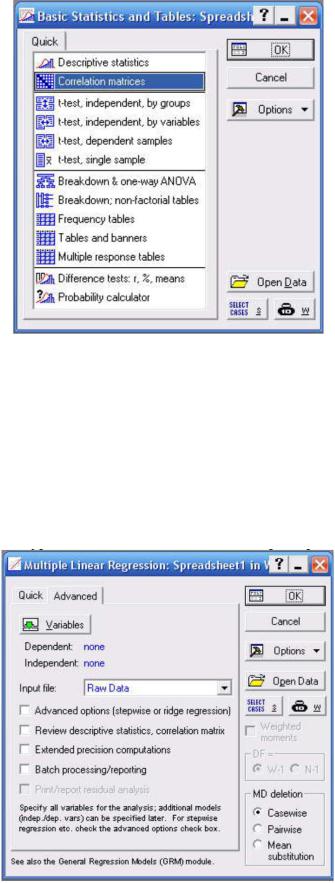
В модуле Nonpametrics содержится значительное количество процедур. Рассмотрим сравнение двух независимых выборок при помощи критерия Манна-Уитни. После выбора соответствующего раздела (рис. 5), необходимо в появившемся окне (рис. 5), выбрать сравниваемые выборки и затем нажать кнопку соответствующую критерию (рис. 6), в нашем случае (Mann-Whitney U-test). В результаты расчётов будут представлены
13
в виде таблицы на основании уровня значимости (p-level) принимается решение о принятии гипотезы 0 H о том, что две выборки получены из однородных генеральных совокупностей, и имеют равные средние и медианы.
Рисунок 6 - Сравнение двух выборок
Лабораторная работа № 4 Регрессионный анализ в пакете STATISTICA
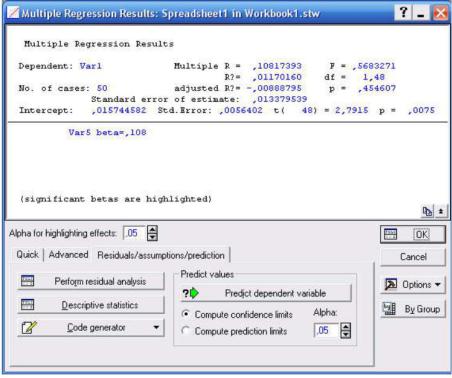
Пакет STATISTICA позволяет производить регрессионный анализ. Простую однофакторную регрессию можно вычислить используя раздел главного меню Statistics→Basic Statistics/Tables в появившемся окне (рис. 7) необходимо выбрать раздел Correlation matrices, далее выбрать векторы между которыми будет произведён расчёт корреляции. Результат вычислений можно посмотреть в виде корреляционной матрицы или построить корреляционные диаграммы, в том числе трёхмерные (для трёх векторов).
14
Рисунок 7 - Корреляционный анализ
Анализ множественной регрессии можно произвести при помощи раздела Statistics→Multiple Regression. В появившемся окне (рис. 8)
необходимо выбрать зависимые и независимые переменные, в случае необходимости указать дополнительные опции, произвести расчёт.
Результатом расчёта буде матрица содержащая значения регрессионных коэффициентов и уровней значимости для каждого фактора.
Рисунок 8 - Множественная регрессия
15
Так же сформированном в окне после вычислений (рис. 9) во вкладке
Residuals/assumptions/prediction возможно сделать ряд полезных операций, например, произвести прогнозирование значений на основе построенного уравнения регрессии.
Рисунок 9 - Результирующее окно расчёта множественной регрессии
Лабораторная работа № 5 Кластерный анализ в пакете STATSTICA
Пакет STATISTICA предоставляет значительные возможности для кластерного анализа. В модуле Cluster Analysis реализуются следующие методы кластеризации:
•соединения (древовидная кластеризация), Joining (tree clustering);
•метод К-средних (K-means clustering);
•двухвходовое объединение (Two-way joining).
Первая опция (Joining) представляет группу так называемых иерархических алгоритмов кластеризации. В основе этих алгоритмов лежит идея последовательной кластеризации. Пусть исходное множество содержит n объектов X1 , X2 ,...X n