Материал: 5856
66
Способ кодирования полностью определён, если задана кодовая таб-
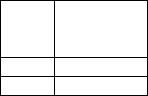
Таблица 3.1 – Пример кодовой таблицы (n=6)
Буква |
Комбинация |
|
|
а |
000000 |
|
|
б |
000111 |
в111000
г111111
лица, в которой перечислены все возможные сообщения и соответствующие им n-разрядные кодовые комбинации. Например, если каждая комбинация соответствует одной букве алфавита, а в используемом алфавите всего 4 буквы, кодовая таблица может иметь следующий вид (табл.3.1).
Можно вычислить расстояние djk между двумя любыми комбинациями в кодовой таблице. Минимальное его значение называется кодовым расстоянием и служит одной из важнейших характери-
dкод |
min d jk |
(3.4) |
|
j k |
|
стик выбранного способа кодирования. Это показатель отличия двух наиболее близких комбинаций в таблице. В приведённом примере
daб 3, daв 3 ,…, dаг 6 , в итоге dкод 3.
Довольно трудоёмкий, зато универсальный способ декодирования – это
декодирование по минимуму расстояния. Принятая комбинация сравнивается поочерёдно со всеми комбинациями в таблице. Если такая комбинация есть в таблице, то декодирование заканчивается. Конечно, при этом нет полной уверенности в том, что в принятой комбинации отсутствуют ошибки, хотя это весьма вероятно. Просто здесь нет лучшего варианта, поскольку обычно равновозможна передача любой из комбинаций, входящих в таблицу.
В противном случае (принятая комбинация не совпадает ни с одной комбинацией в кодовой таблице) следует несомненный вывод: в принятой комбинации есть ошибка и, может быть, не одна (произошло обнаружение ошибок).
Логически рассуждая и рассматривая примеры, легко убедиться в том,
что можно гарантированно обнаруживать любые ошибки кратности
qo dкод 1. |
(3.5) |
Вприведённом примере (табл. 3.1) код обнаруживает все однократные
идвукратные ошибки. Этот же код способен обнаруживать также некоторые ошибки более высоких кратностей, но не все. В частности, ошибки в первых трёх символах кодовой комбинации не будут замечены.
После обнаружения ошибок в СПИ с обратным каналом посылают запрос на повторную передачу данной комбинации. При отсутствии канала переспроса следует попытаться исправить ошибки, то есть найти в кодовой
67
таблице комбинацию, наиболее близкую к той, которая была принята (наиболее правдоподобную). Даже если в таблице нашлась лишь одна такая комбинация, это ещё не служит гарантией того, что ошибки исправлены верно.
Можно гарантированно исправить любые ошибки кратности
qи |
|
dкод |
1 |
. |
|
|
2 |
|
|
(3.6) |
|||
|
|
|
|
|
||
Например, код (табл. 3.1) способен исправить любую однократную ошибку. Убедитесь на примерах в том, что ресурсы кода используются полнее, если dкод является нечётным числом. Кроме того, видно, что исправлять
ошибки труднее, нежели их обнаруживать. Разумеется, возможны случаи, когда исправляются некоторые ошибки более высоких кратностей, чем следует из (3.6), но не все.
3.2 Линейные блочные коды
Когда количество символов n в кодовой комбинации велико (на практике оно может составлять несколько тысяч), кодовая таблица блочного кода может содержать огромное количество комбинаций. Кодирование и декодирование оказываются слишком трудоёмкими. Поэтому вполне естественно желание разработать такие коды, которые позволяют проводить эти операции, не обращаясь к кодовой таблице, а используя лишь некий набор свойств, присущий всем комбинациям в кодовой таблице. Именно такую возможность предоставляет применение линейного блочного кода.
Любой линейный блочный код обозначается как (n,k)-код, где: k - количество информационных символов, то есть длина двоичной комбинации, поступающей на вход кодера; n - количество символов в комбинации на его выходе. На вход кодера может поступать любая k–разрядная комбинация. Число таких комбинаций равно
N 2k . |
(3.7) |
Если бы кодирование не проводилось (n=k, то есть входная комбинация сразу поступает на выход кодера), такой код не обладал бы никакими корректирующими свойствами, поскольку для него 1, и любые ошибки в при-
нятой комбинации оказались бы незамеченными.
Поэтому для корректирующего кода n>k, и разность r=n-k есть число проверочных символов. Значения этих символов вычисляется по информационным символам с использованием ряда линейных операций.
Очевидно, что для самого простого кода r=1. Такой код называется кодом с проверкой на чётность (n, n-1). На вход кодера поступает комбинация a (a1, a2 ,..., ak ) . Кодер повторяет значения этих символов s1 a1,..., sk ak и до-
бавляет к ним ещё один, проверочный символ (напоминаем об операции mod2)
68
sk 1 a1 a2 ... ak |
. |
(3.8) |
В итоге любая комбинация s на выходе |
кодера содержит чётное коли- |
|
чество единиц. Это и есть то самое свойство, которое присуще всем переданным комбинациям. Например, при k=7 имеем: a=0110100→s=01101001; a=0000000→s=00000000; a=1111111→s=11111111. При декодировании до-
статочно провести общую проверку на чётность
c1 s1 ... sn . |
(3.9) |
Если проверка прошла ( c1 0), то это лишь означает, что такая комбинация могла быть передана. Если же проверка не прошла ( c1 1), то в принятой комбинации, несомненно, есть ошибки.
Кодовое расстояние для кода с проверкой на чётность равно двум, поэтому в соответствии с (3.5) он обнаруживает любую однократную ошибку. Более того, он способен обнаружить любую ошибку нечётной кратности, но исправлять ошибки он не может.
Операции (3.8) и (3.9) – чрезвычайно простые. Для реализации каждой из них достаточно иметь один счётный триггер. Тогда сразу возникает идея для повышения корректирующей способности кода использовать не одну, а несколько проверок на чётность. При этом очевидно, что в каждой проверке участвуют не все n символов, а лишь их часть. А в разных проверках должны участвовать разные группы символов.
В качестве примера рассмотрим код (5,2). Зададим его в систематической форме, то есть первые k символов выходной комбинации должны повторять входные информационные символы, а на оставшихся r=n-k=3 позициях размещаются проверочные символы, которые предстоит вычислить при
кодировании, то есть |
|
s=(a,b), |
(3.10) |
где a – вектор-строка информационных символов, b – вектор-строка проверочных символов. В частности, рассмотренный выше простой код с проверкой на чётность тоже является систематическим.
Итак, для кода (5,2) из N1 2n 32 всевозможных пятиразрядных комбинаций в кодовую таблицу включим лишь такие комбинации, которые удовлетворяют всем трём заданным проверкам на чётность (количество проверок на чётность всегда равно r). Результаты проведения этих r проверок для конкретной комбинации представим в виде вектора-строки ко-
торый имеет медицинское название “синдром”, то есть, сочетание признаков, характеризующих определённое состояние. Допустим, для нашего кода мы выбрали следующую систему проверок
c1 s1 s3; c2 s1 s 2 s4 ; c3 s2 s5 , (3.11)
то есть, в первой проверке участвуют символы, стоящие на первой и третьей позициях, и т.д. В кодовую таблицу (типа табл. 3.1) включим лишь те комбинации, для которых вектор c=0. Оказывается, что их всего 4, как и следовало
69
ожидать (3.7).
Таблица 3.2. Кодовая таблица кода (5,2)
a |
s |
00 |
00000 |
01 |
01011 |
10 |
10110 |
11 |
11101 |
По приведённой таблице (табл. 3.2) легко найти, что dкод 3 , то есть за-
данная нами система проверок на чётность (3.11) действительно однозначно определяет систематический корректирующий код, способный не только обнаружить любые однократные и двукратные ошибки, но даже исправлять все однократные ошибки.
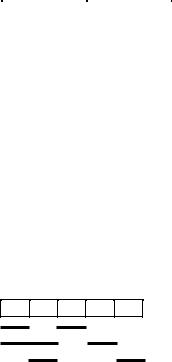
Систему проверок (3.11) можно более наглядно представить в виде рис.3.1.
s1 s2 s3 s4 s5
Первая Вторая Третья
Рис. 3.1. Схема проверок на чётность для кода (5,2)
Первый этап декодирования – обнаружение ошибок – фактически сводится к проведению r проверок на чётность (3.11) в принятой кодовой комбинации. Считается, что ошибок нет, если c=0.
Если c≠0, второй этап – исправление ошибок – также можно провести, пользуясь схемой рис.3.1 и рассматривая различные варианты. Например, если принята комбинация y=11110, то находим c=011 и делаем вывод о наличии ошибок в принятой комбинации. Исходя из возможностей данного кода ( dкод 3), делаем предположение, что произошла однократная ошибка (гаран-
тированно исправлять ошибки более высоких кратностей этот код все равно не может (3.6)). Рассматривая разные варианты расположения этой одиночной ошибки, видим, что наблюдаемый результат c=011 мог быть получен лишь в случае, когда эта ошибка расположена во втором символе, следовательно, х=10110 и a=10.
Чтобы не перебирать различные варианты каждый раз при декодировании очередной кодовой комбинации, полезно заранее заготовить таблицу, в которой перечислить все возможные векторы исправляемых ошибок (однократных в нашем примере) и соответствующие им значения вектора-
70
синдрома (табл. 3.3). Если бы код был способен исправлять ещё и все двукратные ошибки, в эту таблицу следовало бы включить дополнительно C52 10 векторов таких ошибок, в частности 11000, 10100 и т.д.
Таблица 3.3. Таблица соответствия вектора ошибки и синдрома для (5,2)-кода
e |
c |
10000 |
110 |
01000 |
011 |
00100 |
100 |
00010 |
010 |
00001 |
001 |
Из табл. 3.3 видно, что анализируемый код (5,2) действительно способен исправить любую однократную ошибку, поскольку все значения c различны, а каждому c соответствует единственный вектор ошибки e. Легко убедиться, что для двукратных ошибок такого однозначного соответствия уже не будет.
Чтобы завершить обсуждение тех вычислений, которые нужно проводить при кодировании и декодировании линейных блочных кодов, полезно продолжить их формализацию, в частности, ввести для них более компактную форму записи.
Вместо схемы рис. 3.1 удобно использовать проверочную матрицу H, содержащую r строк и n столбцов и состоящую из 0 и 1. Каждая строка соответствует одной проверке на четность, причем положение единиц в этой строке указывает на позиции символов кодовой комбинации, участвующих в данной проверке. Для рассмотренного кода (5,2) такая матрица имеет вид
10100 |
|
|
H 11010 |
. |
|
|
|
(3.12) |
01001 |
||
|
|
|
Если линейный блочный код к тому же является систематическим, матрицу H можно условно разделить на два блока H=(Q,Ir), причем левый блок имеет размеры (r k), а правый блок - это единичная матрица (r r). Для нашего примера
10 |
|
|
100 |
|
|
|
|
|
|
|
|
|
|
Q= 11 |
, |
Ir |
|
|
||
|
010 |
. |
|
|||
|
|
|
|
001 |
|
(3.13) |
01 |
|
|
|
|
||
Операция вычисления синдрома (3.11) имеет следующий вид |
|
|||||
|
c = sHT , |
|
|
(3.14) |
||
где H T - транспонированная матрица H.