Материал: Akhremenko_A_S_-_Politicheskiy_analiz_i_prognozi
130
Глава 4. Статистические методы в политическом анализе
гораздо сильнее, чем высокие. Так, 0,9
2
= 0,81 (значение снижается
всего на 0,09); 0,5
2
= 0,25 (здесь мы теряем уже половину значения);
0,3
2
= 0,09 (более чем трехкратная «потеря веса»). Когда речь идет о
переменных, которые мы можем содержательно интерпретировать
как «определяющие» и «определяемые», значение
г
2
будет показы
вать долю случаев, которые объясняет определяющая переменная.
В нашем примере к о э ф ф и ц и е н т корреляции между переменными
«поддержка С П С » и «доля сельского населения» после чистки вы
бросов составил - 0 , 6 5 . К о э ф ф и ц и е н т детерминации составляет со
ответственно - 0 , 6 5
2
= 0,42. Несколько упрощая реальное положе
ние дел, мы можем утверждать, что фактор урбанизации объясняет
примерно 40% вариации переменной «голосование за СПС» по ре
гионам России в 1999 г.
Использование корреляционного анализа для выявления динамики связи
переменных во времени
К о р р е л я ц и о н н ы й анализ м о ж н о использовать не только для обна
ружения связи между п е р е м е н н ы м и , но и для о ц е н к и и з м е н е н и я
этой связи во времени. Так, при изучении проблемы электоральной
активности в регионах России необходимо было убедиться в том,
что уровень активности избирателей является некой стабильной ха
рактеристикой электоральной культуры российских территорий.
И м е ю т с я в виду, разумеется, не абсолютные показатели, которые
существенно колеблются от выборов к выборам. Речь идет об устой
чивости различий в уровне активности избирателей различных ре
гионов России.
Устойчивость пропорционального распределения явки по субъ
ектам Федерации достаточно просто проверяется методом корреля
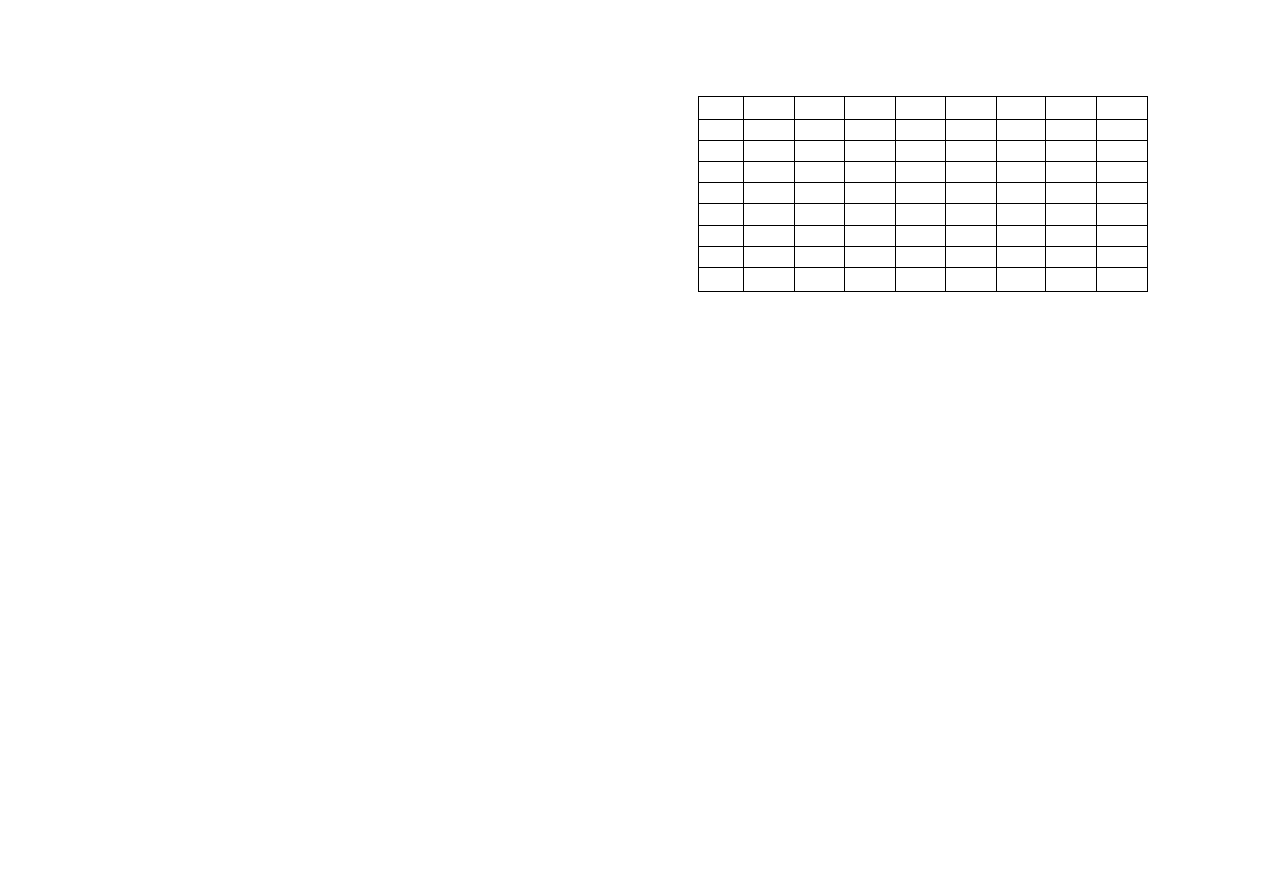
ционного анализа. Приводимая ниже матрица парных корреляций
электоральной активности на федеральных выборах 1991—2004 гг.
довольно четко демонстрирует существующую тенденцию. Статис
тическая связь наиболее сильна внутри одного электорального цик
ла ( 1 9 9 1 - 1 9 9 3 ; 1995-1996; 1999-2000; 2003-2004), между двумя
близкими по времени циклами она несколько слабеет, а по мере уда
л е н и я электоральных циклов стремится к затуханию
1
.
С м . :
Ахременко, А. С.
Электоральное участие и абсентеизм в р о с с и й с к и х реги
онах: з а к о н о м е р н о с т и и т е н д е н ц и и // Вестник МГУ. Сер. 12 П о л и т и ч е с к и е науки
2005. № 3.
4.3. Корреляционный анализ
131
1991
1993
1995
1996'
1999
2000
2003
"2004
1991
1
1993
0,83
1
1995
0,52
0,66
1
1996
0,43
0,47
0,76
1
1999
0,14
0,26
0,61
0,56
1
2000
0,13
0,15
0,34
0,47
0,74
1
2003
0,04
0,13
0,36
0,38
0,81
0,75
1
2004
0,04
0,10
0,11
0,21
0,55
0,66
0,73
1
Отметим, что внутри каждого электорального цикла плотность
корреляции превышает 0,7 (1991-1993: /-= 0,83; 1995-1996:
г=
0,76;
1999—2000:
г=
0,74; 2003—2004: г= 0,73). На максимальной времен
ной дистанции — между президентскими и парламентскими выбора
ми 1991 — 1993 и 2003—2004 гг. — связи нет никакой, коэффициенты
не превышают 0,1. В то же время затухание связи во времени проис
ходит медленно. Так, обращает на себя внимание наличие связи, хоть
и неплотной, между уровнем электоральной активности на парла
ментских выборах 1995 и 2003 гг.
(г=
0,36). Тот факт, что определен
ная преемственность обнаруживается на протяжении восьми лет, в те
чение которых происходит серьезнейшее «переформатирование»
политического режима и системы федеративных отношений, свиде
тельствует о высокой устойчивости распределения уровня явки по
российским регионам. Таким образом, мы имеем основания считать
уровень активности/абсентеизма одной из составляющих электораль
ной культуры территорий.
Другие коэффициенты корреляции
Как было о т м е ч е н о , к о э ф ф и ц и е н т к о р р е л я ц и и П и р с о н а является
наиболее р а с п р о с т р а н е н н ы м к р и т е р и е м связи интервальных и
нормально распределенных п е р е м е н н ы х . Но что делать, если мы
имеем п е р е м е н н ы е , существенно о т к л о н я ю щ и е с я от нормального
распределения? И л и переменные не интервальные, но при этом
являются м е т р и ч е с к и м и (порядковые переменные с большим чис
лом категорий)?
1
Здесь рассматривается значение я в к и для первого тура президентских выборов
1996 г. Проблема к о л е б а н и й явки от первого ко второму туру анализируется отдельно.
9-
132
Глава 4. Статистические методы в политическом анализе
В этих ситуациях рекомендуется вычислять
коэффициенты корре
ляции рангов,
наиболее известным из которых является
коэффициент
Спирмана.
Ранговая корреляция оперирует логикой порядкового
уровня: принимаются во внимание не абсолютные значения, а отно
шения порядка (возрастания и убывания). В какой-то мере ранговую
корреляцию можно считать усложненной версией расчета показателя
гамма (у), который мы рассматривали в качестве стандартной меры
связи порядковых переменных.
К о э ф ф и ц и е н т корреляции Спирмана колеблется в том же интер
вале, что и к о э ф ф и ц и е н т Пирсона — от 0 до ±
1
. П р и н ц и п ы интерпре
тации значений коэффициента также идентичны. Дополнительно
стоит отметить, что ранговая корреляция не чувствительна к выбро
сам, так как не чувствительна к абсолютным значениям вообще.
4.4. Дисперсионный анализ
Дисперсионный анализ
(англ.
ANalysis Of VAriance, ANOVA) является
одним из основополагающих статистических методов. Важность уме
ния работать с его алгоритмами определяется не только теми возмож
ностями, которые он предоставляет исследователю для самостоятель
ного анализа данных. Как и в случае с корреляционным анализом,
изучение дисперсий переменных входит во многие более сложные
статистические методы.
Дисперсионный анализ служит для проверки гипотезы о
статистической значимости различий между средними величинами в
нескольких группах наблюдений.
Например, по результатам социологи
ческого исследования мы выявили две группы респондентов: при
нявших участие в последних федеральных выборах (группа
1)
и про
игнорировавших голосование (группа 2). Проведя описательный
статистический анализ обеих групп, мы обнаружили, что они суще
ственно различаются по средним значениям переменной «возраст».
Группа «активных избирателей» в среднем значительно старше, чем
группа «абсентеистов». Ниже в таблице представлены исходные дан
ные (разумеется, в реальном исследовании объемы выборок должны
быть существенно больше
1
). Переменная «возраст» является интер
вальной. Переменная «участие в выборах» относится к номинальным
дихотомическим переменным и принимает всего два значения: «при-
1
В д и с п е р с и о н н о м анализе выборки д о л ж н ы извлекаться случайно из генеральных
н о р м а л ь н о распределенных совокупностей.
4.4. Дисперсионный анализ
133
нял участие» («активные избиратели», код
1)
или «не принял учас
тия» («пассивные избиратели», код 2).
Возраст
Активные избиратели
(код 1)
Возраст
П а с с и в н ы е избиратели
(код 2)
38
1
23
2
76
1
50
2
41
1
19
2
57
1
34
2
82
1
45
2
63
1
22
2
47
1
33
2
58
1
18
2
64
1
22
2
71
1
45
2
49
1
27
2
43
1
37
2
Среднее в группе I: 57,42
Среднее в группе 2: 31,25
Теперь попытаемся ответить на вопрос: не является ли различие
между средними в двух группах случайным? Насколько вероятно,
что активные избиратели в среднем старше, чем пассивные, и в ге
неральной совокупности? Вопрос отнюдь не праздный. Убедившись
в существовании значимых различий между средними, мы сможем
оперировать п е р е м е н н ы м и «возраст» и «участие в выборах» в терми
нах зависимости. Зная же значения независимой переменной («воз
раст») — с определенной долей статистической вероятности пред
с к а з ы в а т ь з н а ч е н и е группирующей п е р е м е н н о й «участие в
выборах». И н ы м и словами, «возраст» может играть роль
переменной-
предиктора
(предсказывающего фактора) при отнесении объекта к
одному из классов группирующей переменной.
Сформулируем две гипотезы —
нулевую
и
альтернативную.
В соот
ветствии с нулевой гипотезой различия средней являются случайны
ми, зависимость между переменной «возраст» и переменной «участие
в выборах» отсутствует. Альтернативная гипотеза основана на проти
воположном утверждении.
Вычислительная логика дисперсионного анализа базируется на
разбиении общей дисперсии (вариации) переменной на две компо
ненты, одна из которых обусловлена случайностью, а другая связана с
134
Глава 4. Статистические методы в политическом анализе
различием средних значений. В качестве меры «случайной ошибки»
выступает сумма дисперсий переменной внутри каждой группы, ко
торая затем сравнивается с общей дисперсией (дисперсией перемен
ной без учета значений группирующей переменной). Проиллюстри
руем эту логику на нашем примере
1
.
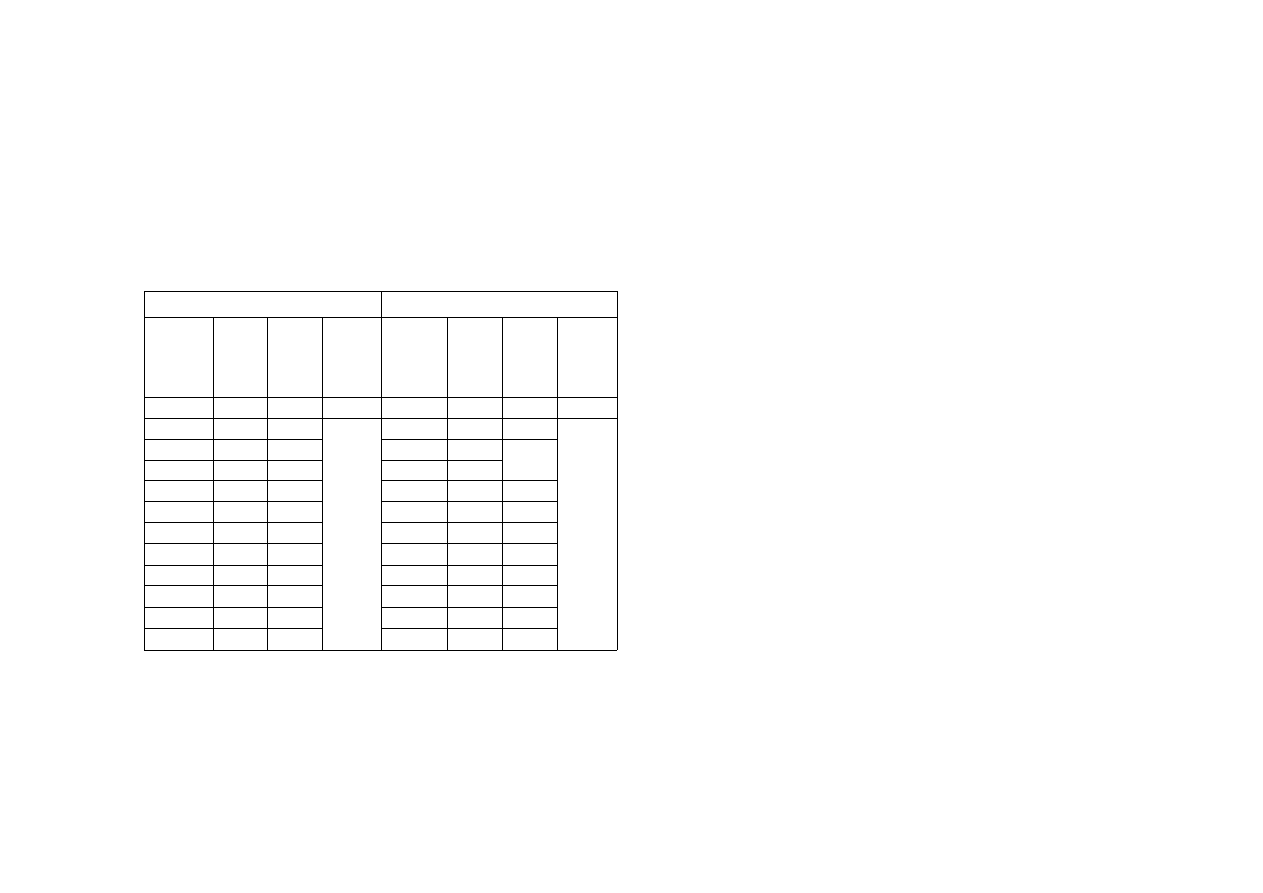
1. Вычисляем отклонения от средней для группы активных изби
рателей (из средней вычитаем значения переменной).
2. Возводим все полученные значения в квадрат.
3. Суммируем все квадраты отклонений.
4. Повторяем те же операции для группы 2.
Активные избиратели
2
Пассивные избиратели
Значение
перемен
ной «воз
раст»
Откло
нения
Квадра
ты от
клоне
ний
Сумма
квадра
тов от
клоне
ний
(SS)
Значение
перемен
ной «воз
раст»
Откло
нения
Квадра
ты от
клоне
ний
Сумма
квадра
тов от
клоне
ний
(SS)
38
19,42
377,01 2242,917
23
8,25
68,06
1356,25
76
-18,58 345,34
50
-18,75
351,56
41
16,42
269,51
19
12,25
150,06
57
0,42
0,17
34
-2,75
7,56
82
-24,58 604,34
45
-13,75
189,06
63
-5,58
31,17
22
9,25
85,56
47
10,42
108,51
33
-1,75
3,06
58
-0,58
0,34
18
13,25
175,56
64
-6,58
43,34
22
9,25
85,56
71
-13,58
184,51
45
-13,75
189,06
49
8,42
70,84
27
4,25
18,06
43
14,42
207,84
37
-5,75
33,06
Теперь можно рассчитать один из элементов итоговой дисперси
о н н о й статистики — сумму квадратов ошибки (дисперсию ошибки
или остаточный компонент), которая в статистических программах,
' Разумеется, в реальных исследованиях все вычисления будет выполнять компью
тер: модули дисперсионного анализа присутствуют во всех статистических программах.
Особенно полезно будет пройти вычислительный алгоритм дисперсионного анализа,
используя программу MS Excel, где для всех указанных действий имеются соответству
ющие функции.
2
Здесь и далее числа округлены до второго знака после запятой.
4.4. Дисперсионный анализ
135
как правило, обозначается
SS-еттот
(sum of squares error). Складываем
сумму квадратов отклонений для группы 1 и группы 2 и получаем
3599,17.
Далее необходимо вычислить общую вариацию переменной отно
сительно единой средней (в нашем случае — 44,3). Действуем таким
же образом, как ранее, — вычисляем сумму квадратов отклонений,
однако теперь уже без учета разделения наблюдений на две группы.
Общая сумма квадратов отклонений составит в нашем случае 7707,33.
Вычитаем сумму квадратов отклонений ошибки из общей суммы
квадратов отклонений и получаем второй элемент итоговой статис
тики дисперсионного анализа — так называемую «сумму квадратов
эффекта» (обозначается ^-effect, в нашем случае — 4108,16). Это
межгрупповая дисперсия — вариация зависимой переменной, «очи
щенная» от случайного компонента, связанного с внутригрупповой
изменчивостью.
Именно отношение межгрупповой дисперсии к дисперсии ошиб
ки (внутригрупповой дисперсии) покажет статистическую значи
мость средней, точнее — значимость различия между средними значе
н и я м и в двух группах. Чем больше о т н о ш е н и е межгрупповой
дисперсии к внутригрупповой, тем большей значимостью обладает
различие средних. Другими словами, чем меньше доля случайных
ошибок, тем выше статистическая значимость.
В дисперсионном анализе отношение дисперсий показывает
кри
терий Фишера,
или
F-критерий
(/^-отношение). Он проверяет, дей
ствительно ли отношение дисперсий значимо больше 1. Для вычисле
ния F-статистики используются показатели Л/5-error и MS'-effect —
средние квадраты эффекта и ошибки (Mean Square). Это те же
SS-
error и ^-effect, но преобразованные с поправкой на объем совокуп
ности (число значений, принимаемых переменной). В нашем приме
ре MS-effect = SS-effect = 4108,16;
MS-tnox
= 163,59 (значение
55-error — 3599,17, разделенное на число случаев в выборке — 22);
F=
25,1, т.е. существенно выше единицы.
Полезным показателем в ^-статистике является также показатель
р,
отражающий значимость f-критерия. Это вероятность того, что при
данном значении /^-критерия верна нулевая гипотеза. В обычном слу
чае нулевая гипотеза отвергается при /?<0,05. В нашем случае
р =
0,00005, и мы можем с уверенностью отвергнуть нулевую гипотезу и
принять альтернативную.
Итоговая статистика для выбранного нами примера выглядит сле
дующим образом:
136
Глава 4. Статистические методы в политическом анализе
Показатель
Интерпретация
Значение
SS-effect
Межгрупповая дисперсия
4108,16
55-error
Дисперсия ошибки
3599,16
MS-effect
Межгрупповая дисперсия, скорректированная на
объем выборки (в нашем случае без коррекции)
4108,16
MS-error
Дисперсия ошибки, скорректированная на объем
выборки
163,59
F
Отношение межгрупповой дисперсии
(MS-effecl)
и
дисперсии ошибки (MS-error)
25,11
P
Вероятность принятия нулевой гипотезы при дан
ном значении
F
0,000051
К а к и в случае с к о р р е л я ц и о н н ы м анализом, интерпретацию
итоговой статистики полезно предварить (или дополнить) визуаль
ным анализом вариации переменной. Кроме гистограмм нормаль
ного распределения, полезно будет ознакомиться с
диаграммой раз
маха
(или
коробчатой диаграммой).
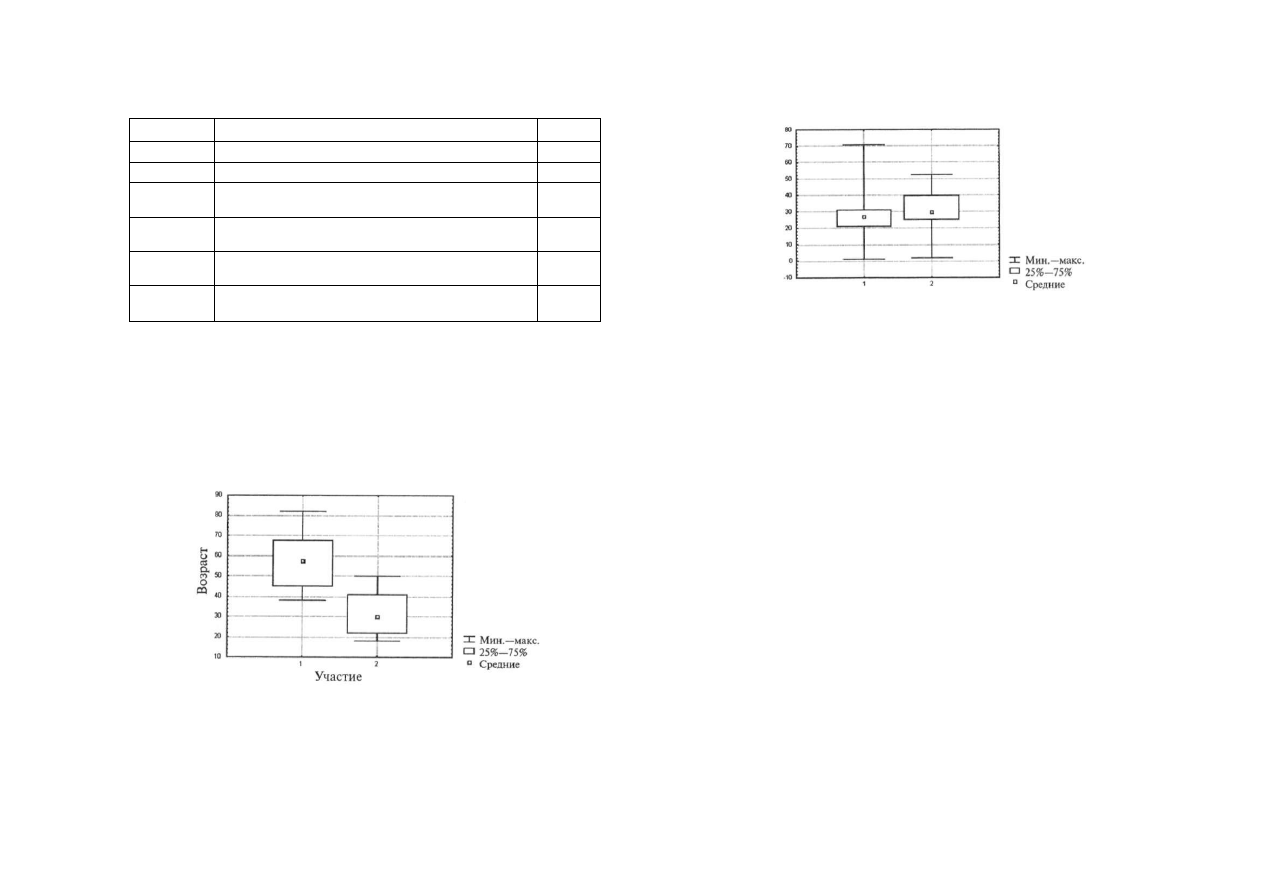
Для взятого нами примера она
такова:
На диаграмме видно, что вариации переменной в двух группах чет
ко «разведены» в пространстве и «следуют» за средними. Уже на осно
вании визуального ее анализа можно предположить, что нулевая ги
потеза будет отвергнута. А вот типичный случай, когда отвержение
нулевой гипотезы вызывает большие сомнения:
4.4. Дисперсионный анализ
137
С помощью дисперсионного анализа можно также изучать влия
ние двух независимых переменных на зависимую, и в этом случае ис
пользуется
двухфакторный метод.
«Принципиальная схема» двухфак-
торного дисперсионного анализа в целом не очень отличается от
однофакторного. В то же время ряд существенных его особенностей
следует отметить. Во-первых, двухфакторный дисперсионный анализ
оперирует только номинальными и порядковыми переменными. Во-
вторых, он принимает в расчет возможное взаимодействие независи
мых переменных в их влиянии на зависимую. В силу этого формулиру
ется три нулевые гипотезы: 1) первый фактор не влияет на зависимую
переменную; 2) второй фактор не влияет на зависимую переменную;
3) взаимодействие факторов 1 и 2 в их совместном влиянии на зависи
мую переменную равно 0.
В примере для однофакторного дисперсионного анализа мы
изучали связь между независимой переменной «возраст» и зависимой
переменной «участие в выборах». Добавим еще одну независимую пе
ременную — «пол». Это номинальная дихотомическая переменная,
принимающая два значения: «мужской» (1) и «женский» (2). Пере
менную «возраст» необходимо преобразовать из интервальной шкалы
в порядковую. С этой целью выделим возрастные группы: от 18 до 35
лет (1), от 35 до 50 лет (2), старше 50 (3). Итак, мы получили две фак
торные и одну зависимую переменную:
1. Возраст, значения 1 (младший), 2 (средний), 3 (старший).
2. Пол, значения 1 (мужской), 2 (женский).
3. Участие в выборах, значения 1 (участие), 2 (неучастие).
Предположим, мы имеем следующие исходные данные (пример
учебный):
138
Глава 4. Статистические методы в политическом анализе
Возраст
Участие
Пол
Возраст
Участие
Пол
1
1
1
2
2
1
1
1
2
2
2
1
1
1
2
2
2
1
1
1
2
2
2
1
1
1
2
2
2
1
2
1
3
1
1
1
2
1
3
1
1
1
2
1
3
1
1
- 1
2
2
3
1
1
2
2
3
1
1
2
1
1
3
2
1
2
1
2
3
2
1
2
1
2
2
2
1
2
1
2
3
2
1
2
1
2
3
2
1
Полезно представить исходные данные через комбинации сочета
ний значений независимых переменных. Это удобно делать в форме
таблицы, где в ячейках будут отображены соответствующие частоты
зависимой переменной для состояний независимых переменных.
Участие 1
Участие 2
Возраст 1. Пол 1
1
4
Возраст 1. Пол 2
3
2
Возраст 2. Пол 1
1
4
Возраст 2. Пол 2
4
1
Возраст 3. Пол 1
4
1
Возраст 3. Пол 2
5
0
Глядя на таблицу, можно сформулировать некоторые предположе
ния (альтернативные гипотезы):
• возраст влияет на участие в выборах (чем старше избиратель, тем
он активнее);
• пол влияет на участие в выборах (женщины ходят на выборы ак
тивнее мужчин);
• сочетание пола и возраста влияет на участие в выборах. Актив
ность мужчин с возрастом растет более интенсивно, чем активность
ж е н щ и н .
4.5. Регрессионный анализ
139
Проверяем наши нулевые и альтернативные гипотезы с помощью
дисперсионного анализа.
^/-effect MS-effect
df-егтот MS-егтот
F
Р-
значение
Возраст
2
0,636893
24
0,184722 3,44784 0,048279
Пол
1
1,250228
24
0,184722 6,768153 0,015649
Возраст—пол
2
0,116215
24
0,184722 0,629132 0,541618
/^значение для переменной «возраст» равно 0,04, для переменной
«пол» — 0,01. В обоих случаях мы вправе отвергнуть нулевую гипоте
зу и признать наличие влияния, так как /КО,05. А вот в третьем случае,
где речь идет о взаимодействии факторных переменных, наше пред
положение не набрало достаточного статистического веса: при
р =
0,54 нулевая гипотеза остается в силе.
4.5. Регрессионный анализ
Целью регрессионного анализа является измерение связи меж
ду зависимой переменной и одной (парный регрессионный анализ) или не
сколькими (множественный) независимыми переменными.
Независимые
переменные называют также факторными, объясняющими, опреде
ляющими, регрессорами и предикторами. Зависимую переменную
иногда называют определяемой, объясняемой, «откликом». Чрезвы
чайно широкое распространение регрессионного анализа в эмпири
ческих исследованиях связано не только с тем, что это удобный ин
струмент тестирования гипотез. Регрессия, особенно множественная,
является эффективным методом моделирования и прогнозирования.
Объяснение п р и н ц и п о в работы с регрессионным анализом
начнем с более простого — парного метода.
Парный регрессионный анализ
Первые действия при использовании регрессионного анализа будут
практически идентичны предпринятым нами в рамках вычисления
коэффициента корреляции. Три основных условия эффективности
корреляционного анализа по методу Пирсона — нормальное распре
деление переменных, интервальное измерение переменных, линейная
связь между переменными — актуальны и для множественной регрес
сии. Соответственно, на первом этапе строятся диаграммы рассеяния,
проводится статистически-описательный анализ переменных и вы-