Материал: для поступления в магистратуру
6
Процедура ветвления состоит в разбиении области допустимых решений на подобласти меньших размеров. Процедуру можно рекурсивно применять к подобластям. Полученные подобласти образуют дерево, называемое деревом поиска или деревом ветвей и границ. Узлами этого дерева являются построенные подобласти.
Процедура нахождения оценок заключается в поиске верхних и нижних границ для оптимального значения на подобласти допустимых решений.
Метод ветвей и границ — общий алгоритмический метод для нахождения оптимальных решений различных задач оптимизации, особенно дискретной и комбинаторной оптимизации. По существу, метод является вариацией полного перебора с отсевом подмножеств допустимых решений, заведомо не содержащих оптимальных решений.
Метод ветвей и границ был впервые предложен в 1960 году Ленд и Дойг для решения задач целочисленного программирования.
Воснове метода ветвей и границ лежит следующая идея (для задачи минимизации): если нижняя граница для подобласти A дерева поиска больше, чем верхняя граница какой-либо ранее просмотренной подобласти B, то A может быть исключена из дальнейшего рассмотрения (правило отсева). Обычно, минимальную из полученных верхних оценок записывают в глобальную переменную m; любой узел дерева поиска, нижняя граница которого больше значения m, может быть исключен из дальнейшего рассмотрения.
Если нижняя граница для узла дерева совпадает с верхней границей, то это значение является минимумом функции и достигается на соответствующей подобласти.
Общая идея метода может быть описана на примере поиска минимума и максимума функции f(x) на множестве допустимых значений x. Функция f от x может быть произвольной природы. Для метода ветвей и границ необходимы две процедуры: ветвление и нахождение оценок (границ).
Вотличии от метода перебора, который ищет допустимое решение конкретной задачи, метод ветвей и границ ищет оптимальное решение, т.е. допустимое решение с наилучшим значением целевой функции.
Метод ветвей и границ требует:
1) Способ получения для каждого узла дерева границ наилучшего значения функции для всех решений (эта граница должна быть нижней для задачи минимизации и верхней для задачи максимизации).
2) Значения наилучшего решения, полученного к этому моменту.
Если такая информация доступна, то можно сравнивать значения границ узла со значением полученного к этому моменту решения. Если значения границ не лучше значения ужу имеющегося наилучшего решения, то такой узел является бесперспективным и его обработка может быть завершена.
Динамическое программирование
Часто, в случае большого числа повторений решения одной и той же подзадачи, можно получать эффективные алгоритмы с помощью табличной техники, называемой динамическим программированием. Динамическое программирование предполагает последовательное решение всех подзадач исходной задачи в порядке возрастания их размера с запоминанием ответов в специальной таблице по мере их получения. Преимущество этого метода по сравнению с рекурсивным алгоритмом состоит в том, что раз уж подзадача решена, ее ответ размещен в таблицу ивдальнейшемникогданевычисляетсяповторно.Ответподзадачиберетсяизтаблицыкаждыйраз, когда он нужен для нахождения решения подзадачи большего размера. Понятно, что эта техника позволяет получать эффективные алгоритмы в тех случаях, когда объем хранимой в таблице информации оказывается не слишком большим.
Динамическое программирование обычно придерживается двух подходов к решению
задач:
нисходящее динамическое программирование: задача разбивается на подзадачи меньшего размера, они решаются и затем комбинируются для решения исходной задачи. Используется запоминание для решений уже решенных подзадач.
восходящее динамическое программирование: все подзадачи, которые впоследствии понадобятся для решения исходной задачи просчитываются заранее и затем используются для
7
построения решения исходной задачи. Этот способ лучше нисходящего программирования в смысле размера необходимого стека и количества вызова функций, но иногда бывает нелегко заранее выяснить, решение каких подзадач нам потребуется в дальнейшем.
Быстрый поиск: бинарный и последовательный поиски в массивах, хеширование
Под поиском в массиве будемпониматьзадачунахожденияиндекса, по которому в массиве располагается некоторый заданный элемент.
Если заранее известна некоторая информация о данных, среди которых ведется поиск, например, известно, что массив данных отсортирован, то удается сократить время поиска,
используя бинарный поиск.
Итак, требуется определить место Х в отсортированном (например, в порядке возрастания) массиве А. Делим пополам и сравниваем Х с элементом, который находится на границе этих половин. Отсортированность А позволяет по результату сравнения со средним элементом массива исключить из рассмотрения одну из половин.
Каждое сравнение уменьшает диапазон поиска приблизительно в два раза. Следовательно, общее количество сравнений имеет порядок O (logN).
Последовательный поиск – тривиальный алгоритм поиска, заключается в последовательном переборе элементов массива до тех пор, пока не будет обнаружен искомый или не будут просмотрены все элементы массива. В случае, когда нет никакой дополнительной информации о характере расположения элементов в массиве, такой алгоритм представляется единственно возможным. Нетрудно подсчитать, что, в худшем случае, для поиска в массиве, состоящем из N элементов, потребуется N операций сравнения.
Хэшированиепредставляет собойпреобразованиелюбогообъемаинформации в уникальный набор символов, который присущ только этому массиву входящей информации.
Этот набор символов и будет называться хэшем.
У хэш-функции есть несколько обязательных свойств:
•Хэш всегда уникален для каждого массива информации. Однако иногда случаются так называемые коллизии, когда для разных входных блоков информации вычисляются одинаковые хэш-коды.
•При самом незначительном изменении входной информации ее хэш полностью меняется.
•Хэш-функция необратима и не позволяет восстанавливать исходный массив информации из символьной строки. Это можно сделать, только перебрав все возможные варианты, что при бесконечном количестве информации требует много времени и денег.
•Хэширование позволяет достаточно быстро вычислить нужный хэш для достаточно большого объема информации.
•Алгоритм работы хэш-функции, как правило, делается открытым, чтобы при необходимости можно было оценить ее стойкость к восстановлению начальных данных по выдаваемому хэшу.
•Хэш-функция должна уметь приводить любой объем данных к числу заданной длины.
Использование деревьев в задачах поиска: бинарные и случайные бинарные, оптимальные и сбалансированные деревья поиска
Случайные бинарные деревья поиска
Случайные деревья поиска представляют собой упорядоченные бинарные деревья поиска, при создании которых элементы (их ключи) вставляются в случайном порядке.
Присозданиитакихдеревьевиспользуетсятотжеалгоритм,чтоипридобавлениивершины в бинарное дерево поиска. Будет ли созданное дерево случайным или нет, зависит от того, в каком порядке поступают элементы для добавления. Примеры различных деревьев, создаваемых при различном порядке поступления элементов приведены ниже.
8
+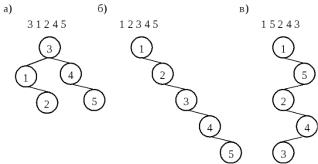
Рисунок 3.15 – Случайные и вырожденные деревья поиска При поступлении элементоввслучайномпорядкеполучаемдерево сминимальнойвысотой
h (см. рис. 3.15.а), а соответственно минимизируется время поиска элемента в таком дереве, которое пропорционально O(log n). При поступлении элементов в упорядоченном виде (см. рис. 3.12.б) или в несколько необычном порядке (см. рис. 3.12.в) происходит построение вырожденных деревьев поиска (оно вырождено в линейный список), что нисколько не сокращает время поиска, которое составляет O(n).
Бинарные (двоичные) деревья
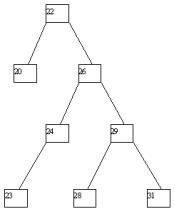
Для организации поиска в основной памяти особое значение имеют упорядоченные двоичные (бинарные) деревья (как, например, на рисунке 10.3). В каждом таком дереве естественно определяются левое и правое поддеревья. Двоичное дерево называется идеально сбалансированным, если число вершин в его левом и правом поддеревьях отличается не более, чем на 1 (легко видеть, что при соблюдении этого условия длины пути до любой листовой вершины дерева отличаются не больше, чем на 1). Примеры идеально сбалансированных деревьев показаны на рисунке 10.5.
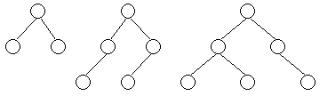 Рис. 10.5.
Рис. 10.6.
Двоичные деревья обычно представляются как динамические структуры с базовым типом записи T, в число полей которого входят два указателя на переменные типа T.
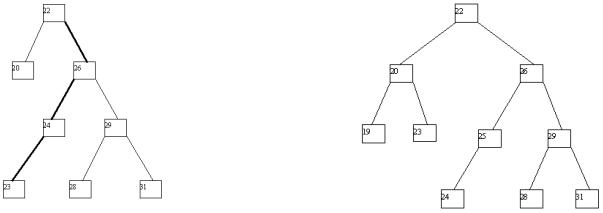
При использовании в целях поиска элементов данных по значению уникального ключа применяютсядвоичныедеревьяпоиска,обладающиетемсвойством,чтодлялюбойвершиныдерева значение ее ключа больше значения ключа любой вершины ее левого поддерева и больше значения ключа любой вершины правого поддерева (рисунок 10.6). Для поиска заданного ключа в дереве поиска достаточно пройти по одному пути от корня до (возможно, листовой) вершины (рисунок 10.7). Высота идеально сбалансированного двоичного дерева с n вершинами составляет не более, чемlogn(логарифмдвоичный),поэтомуприприменениитакихдеревьеввкачестведеревьевпоиска (рисунок 8) потребуется не более log n сравнений.
9
Рис.10.7. Путь поиска ключа по значению “23” Рис. 10.8. Идеально сбалансированное двоичное дерево
Сбалансированные двоичные деревья поиска
Идеально сбалансированные деревья представляют, в большей степени, чисто теоретический интерес, поскольку поддержание идеальной сбалансированности требует слишком больших накладных расходов. В 1962 г. советские математики Адельсон-Вельский и Ландис предложили менее строгое определение сбалансированности деревьев, которое в достаточной степени обеспечивает возможности использования сбалансированных деревьев при существенно меньших расходах на поддержание сбалансированности.
Такие деревья принято называть АВЛ-деревьями (в соответствии с именами их первооткрывателей).
По определению, двоичное дерево называется сбалансированным (или АВЛ) деревом в том и только в том случае, когда высоты двух поддеревьев каждой из вершин дерева отличаются не более, чем на единицу. При использовании деревьев, соответствующих этому определению, обеспечивается простая процедура балансировки при том, что средняя длина поиска составляет O(log n), т.е. практически не отличается от длины поиска в идеально сбалансированных деревьях.
Известно, что оценкой стоимости поиска в АВЛ-дереве, а также выполнения операций включения и исключения ключей является O(log n), т.е. эти деревья при поиске ведут себя почти так же хорошо, как и идеально сбалансированные деревья, а поддержка балансировки при включениях и исключениях обходится гораздо дешевле.
Деревья оптимального поиска
При поиске в двоичном дереве одни элементы могут искаться чаще, чем другие, то есть существуют вероятности Pk поиска k-го элемента и для различных элементов эти вероятности неодинаковы. Можно сразу предположить, что поиск в дереве в среднем будет более быстрым, если те элементы, которые ищутся чаще, будут находиться ближе к корню дерева.
Дерево поиска называется оптимальным, если его цена минимальна или, другими словами, оптимальное бинарное дерево поиска – это бинарное дерево поиска, построенное в расчете на обеспечение максимальной производительности при заданном распределении вероятностей поиска требуемых данных.
Существует подход построения оптимальных деревьев поиска, при котором элементы вставляются в порядке уменьшения частот, что дает в среднем неплохие деревья поиска. Однако этот подход может дать вырожденное дерево поиска, которое будет далеко от оптимального.
Еще один подход состоит в выборе корня k таким образом, чтобы максимальная сумма вероятностей для вершин левого поддерева или правого поддерева была настолько мала, насколько это возможно. Такой подход также может оказаться плохим в случае выбора в качестве корня элемента с малым значением pk.
Процедура построения дерева оптимального поиска достаточно сложна и опирается на тот факт, что любое поддерево дерева оптимального поиска также обладает свойством оптимальности. Поэтомуизвестныйалгоритмстроитдерево"снизу-вверх",т.е.отлистьевккорню.Сложностьэтого алгоритма и расходы по памяти составляют O(n2). Имеется эвристический алгоритм, дающий дерево, близкое к оптимальному, со сложностью O(n*log n) и расходами памяти - O(n).
Такимобразом,созданиеоптимальныхдеревьевпоискатребуетбольшихнакладныхзатрат, что не всегда оправдывает выигрыш при быстром поиске.
Уровни моделей и этапы проектирования баз данных Инфологическое моделирование
Базы данных (БД) и системы управления базой данных (СУБД)
Ба́за да́нных — совокупность данных, хранимых в соответствии со схемой данных, манипулирование которыми выполняют в соответствии с правилами средств моделирования данных.
Вклассификацию по модели данных обычно включают:
•иерархические;
•объектные или объектно-ориентированные;
•объектно-реляционные;
•реляционные;
•сетевые;
•функциональные.
Классификация по среде хранения различает базы данных, хранящие данные во вторичной памяти («традиционные»), резидентные (все данные на стадии исполнения находятся в оперативной памяти) и третичные, хранящие данные на отсоединяемых устройствах массового хранения — на основе магнитных лент или оптических дисков. При этом во всех классах так или иначе используются все среды хранения, например, для резидентных баз данных СУБД записывает в постоянную память журналы предзаписи, а для традиционных баз используется кэш в оперативной памяти.
Также базы данных могут классифицироваться по содержимому, например, могут быть географическими, историческими, научными, мультимедийными. Длянекоторых форм содержания строятсяспециализированныеСУБД,либодобавляютсяспециализированныевозможности вСУБД общего назначения, среди таковых баз данных:
•пространственные: базы с пространственными свойствами сущностей предметной области, используются в геоинформационных системах;
•временны́е (темпоральные): поддерживают какой-либо аспект времени, не считая времени, определяемого пользователем.
По степени распределённости базы данных подразделяются на централизованные
(сосредоточенные) — полностью поддерживаемые на одном оборудовании, и распределённые. Среди многообразия вариантов распределённых баз данных выделяются:
•сегментированные: разделённые на части под управлением различных экземпляров СУБД по какому-либо критерию;
•тиражированные (реплицированные; англ. replicated database): одни и те же данные разнесены под управление различных экземпляров СУБД;
•неоднородные (англ. heterogeneous distributed database): фрагменты распределённой базы в разных узлах сети поддерживаются средствами более одной СУБД.
Возможны смешанные варианты, например, для одной и той же распределённой базы для
больших объектов используется сегментирование, а для небольших — репликация.
Систе́ма управле́ния ба́зами да́нных, сокр. СУБД (Database Management System) —
совокупность программных и лингвистических средств общего или специального назначения, обеспечивающих управление созданием и использованием баз данных.
СУБД — комплекс программ, позволяющих создать базу данных (БД) и манипулировать данными (вставлять, обновлять, удалять и выбирать). Система обеспечивает безопасность, надёжность хранения и целостность данных, а также предоставляет средства для администрирования БД.
Основные функции СУБД:
•управление данными во внешней памяти (на дисках);
•управление данными в оперативной памяти с использованием дискового кэша;
•журнализация изменений, резервное копирование и восстановление базы данных после сбоев;
•поддержка языков БД (язык определения данных, язык манипулирования данными). Состав СУБД: