Материал: для поступления в магистратуру
11
Обычно современная СУБД содержит следующие компоненты:
•ядро, которое отвечает за управление данными во внешней и оперативной памяти и журнализацию;
•процессорязыкабазы данных, обеспечивающий оптимизациюзапросов наизвлечение и изменение данных и создание, как правило, машинно-независимого исполняемого внутреннего кода;
•подсистему поддержки времени исполнения, которая интерпретирует программы манипуляции данными, создающие пользовательский интерфейс с СУБД;
•сервисные программы (внешние утилиты), обеспечивающие ряд дополнительных возможностей по обслуживанию информационной системы.
Классификация СУБД:
По модели данных
Примеры:
•Иерархические
•Сетевые
•Реляционные
•Объектно-ориентированные
•Объектно-реляционные
По степени распределённости
•Локальные СУБД (все части локальной СУБД размещаются на одном компьютере)
•Распределённые СУБД (части СУБД могут размещаться не только на одном, но на двух и более компьютерах).
По способу доступа к БД
• Файл-серверные
В файл-серверных СУБД файлы данных располагаются централизованно на файл-сервере. СУБДрасполагаетсянакаждомклиентскомкомпьютере(рабочейстанции).ДоступСУБДкданным осуществляется через локальную сеть. Синхронизация чтений и обновлений осуществляется посредством файловых блокировок.
Преимуществом этой архитектуры является низкая нагрузка на процессор файлового
сервера.
Недостатки: потенциально высокая загрузка локальной сети; затруднённость или невозможность централизованного управления; затруднённость или невозможность обеспечения таких важных характеристик, как высокая надёжность, высокая доступность и высокая безопасность. Применяются чаще всего в локальных приложениях, которые используют функции управления БД; в системах с низкой интенсивностью обработки данных и низкими пиковыми нагрузками на БД.
На данный момент файл-серверная технология считается устаревшей, а её использование в крупных информационных системах — недостатком[3].
Примеры: Microsoft Access, Paradox, dBase, FoxPro, Visual FoxPro.
• Клиент-серверные
Клиент-серверная СУБД располагается на сервере вместе с БД и осуществляет доступ к БД непосредственно, в монопольном режиме. Все клиентские запросы на обработку данных обрабатываются клиент-серверной СУБД централизованно.
Недостаток клиент-серверных СУБД состоит в повышенных требованиях к серверу. Достоинства: потенциально более низкая загрузка локальной сети; удобство
централизованного управления; удобство обеспечения таких важных характеристик, как высокая надёжность, высокая доступность и высокая безопасность.
Примеры: Oracle Database, Firebird, Interbase, IBM DB2, Informix, MS SQL Server, Sybase Adaptive Server Enterprise, PostgreSQL, MySQL, Caché, ЛИНТЕР.
• Встраиваемые Встраиваемая СУБД — СУБД, которая может поставляться как составная часть некоторого
программного продукта, не требуя процедуры самостоятельной установки. Встраиваемая СУБД предназначена для локального хранения данных своего приложения и не рассчитана на коллективное использование в сети.
12
Физически встраиваемая СУБД чаще всего реализована в виде подключаемой библиотеки. Доступ к данным со стороны приложения может происходить через SQL либо через специальные программные интерфейсы.
Примеры:OpenEdge,SQLite,BerkeleyDB,FirebirdEmbedded,MicrosoftSQLServerCompact,
ЛИНТЕР.
Выбор системы управления базами данных
Система управления базами данных (далее СУБД) - система управления базами данных (БД) (DBMS) отвечает за агрегирование данных и их последующее хранение и обработку.
Реляционная модель - представление БД в виде таблиц для действий над записями на языке
SQL.
«Постреляционная СУБД» - наличие в реляционной СУБД файлов управления данными,не вписывающихсявреляционнуюмодель,т.е.объектов.Ранееданныехранилисьтольковалфавитноцифровой форме, классифицировались по стандартным типам (строки, целые числа и т.д.). Теперь сюда включаются и бинарные объекты: изображения, видео и большие фрагменты текста, по которым может происходить поиск.
Различаютреляционныебазыданных, постреляционныеи NoSQL, но еще существуют и их разновидности:
№ |
Тип СУБД |
|
Когда выбирать |
Популярные СУБД данного типа |
||||
1 |
Реляционные |
Нужна транзакционность; высокая нормализация; |
Oracle, MySQL, Microsoft SQL Server, |
|||||
|
|
большая доля операций на вставку |
PostgreSQL, IBM DB2, SQLite |
|
||||
2 |
Ключ-значение |
Задачи кэширования и брокеры сообщений |
Redis, Memcached, etcd |
|
||||
3 |
Документные |
Для хранения объектов в одной сущности, но с |
Couchbase, MongoDB, Amazon DocumentDB |
|||||
|
|
разной структурой; хранение структур на основе |
|
|
|
|
||
|
|
JSON |
|
|
|
|
|
|
4 |
Графовые |
Задачи подобные социальным сетям; системы |
Neo4j, Amazon |
Neptune, |
InfiniteGraph, |
|||
|
|
оценок и рекомендаций |
|
TigerGraph |
|
|
|
|
5 |
Колоночные |
Хранилища данных; выборки со сложными |
Vertica, ClickHouse, Google BigQuery, Sybase |
|||||
|
|
аналитическими вычислениями; количество строк |
\ SAP IQ, InfoBright |
|
||||
|
|
в таблице превышает сотни миллионов |
|
|
|
|
||
6 |
Time series |
Системы мониторинга, сбора телеметрии, и |
InfluxDB, |
Kdb+, |
Prometheus, |
TimescaleDB, |
||
|
|
финансовые системы, с привязкой к временным |
QuestDB, |
AWS |
Timestream, |
OpenTSDB, |
||
|
|
меткам или временным рядам |
GridDB |
|
|
|
||
7 |
Объектные |
Высокопроизводительная |
обработка данных, |
MongoDB |
Realm, InterSystems Caché, |
|||
|
|
имеющих сложную структуру, с использованием |
ObjectStore,ActianNoSQLDB,Objectivity/DB |
|||||
|
|
языков |
объектно |
ориентированного |
|
|
|
|
|
|
программирования |
|
|
|
|
|
|
8 |
Search engine |
Системы полнотекстового поиска |
Apache Solr, Elasticsearch, Splunk |
|||||
9 |
Spatial |
GIS-решения,работасгеометрическимиобъектами |
Oracle Spatial, Microsoft SQL, PostGIS, |
|||||
|
|
|
|
|
SpatialLite |
|
|
|
При выборе типа СУБД следует, прежде всего, исходить из типа решаемых задач, типов обрабатываемых данных, перспектив роста и масштабирования, на популярность и наличие широкого круга разработчиков и средств разработки.
Жизненный цикл базы данных
Жизненный цикл базы данных (ЖЦ БД) – это процедура создания концептуальной схемы базы данных, определения данных, включаемых в базу данных создание программ обновления и обработки данных.
ЖЦ БД – это процесс проектирования, реализации и поддержания системы базы данных. Жизненный цикл базы данных состоит из шести этапов:
1.Предварительное планирование
2.Проверка осуществимости
3.Определение требований
13
4.Концептуальное проектирование
5.Реализация
6.Оценка работы и поддержка базы данных.
Предварительное планирование конкретной системы управления базами данных осуществляется в процессе разработки стратегического плана. Ищутся ответы на следующие вопросы:
1.Сколько используется прикладных программ и какие функции они выполняют?
2.Какие файлы связаны с каждым из этих приложений?
3.Какие новые приложения и файлы находятся в процессе создания?
Собранная информация может быть использована для того, чтобы установить связи между текущими приложениями и определить, как используется информация приложений. Она также помогает определить будущие требования к системе и получить от системы базы данных экономическую выгоду. Информация документируется в виде обобщенной концептуальной модели данных.
Проверка осуществимости включает подготовку отчетов по следующим вопросам:
1.Технологическая осуществимость. Есть ли технология, необходимая для реализации запланированной базы данных?
2.Операционная осуществимость. Располагает ли компания персоналом, средствами и экспертами, необходимыми для успешного осуществления плана создания базы данных?
3.Экономическая целесообразность. Можно ли определить выгоды? Окупается ли запланированная система? Можно ли измерить издержки и выгоду?
Определение требований включаетвыборцелей базыданных,выяснениеинформационных потребностей различных отделов и руководителей компании и требований к оборудованию и программному обеспечению.
Этап концептуального проектирования включает создание концептуальной схемы базы данных. Спецификации разрабатываются в той степени, которая требуется для перехода к реализации. На этом этапе создаются подробные модели пользовательских представлений данных; затем они интегрируются в концептуальную модель, фиксирующую все элементы корпоративных данных, которые будет содержать база данных.
В процессе реализации базы данных выбирается и приобретается СУБД, затем подробная концептуальная модель превращается в проект реализации базы данных; создается словарь данных, база данных наполняется данными, создаются прикладные программы и обучается пользователь.
Оценка включает опрос пользователей с целью выяснения, какие информационные потребности остались неучтенными. В случае необходимости вносятся изменения. Обеспечивается поддержка системы путем внесения изменений и добавления новых программ и элементов данных по мере расширения и изменения потребностей бизнеса.
Уровни моделей и этапы проектирования БД
В процессе научных исследований, посвященных тому, как именно должна быть устроена СУБД, предлагались различные способы реализации. Самым жизнеспособным из них оказалась предложенная американским комитетом по стандартизации ANSI (American National Standards Institute) трехуровневая система организации БД, изображенная на рис. 2.1:
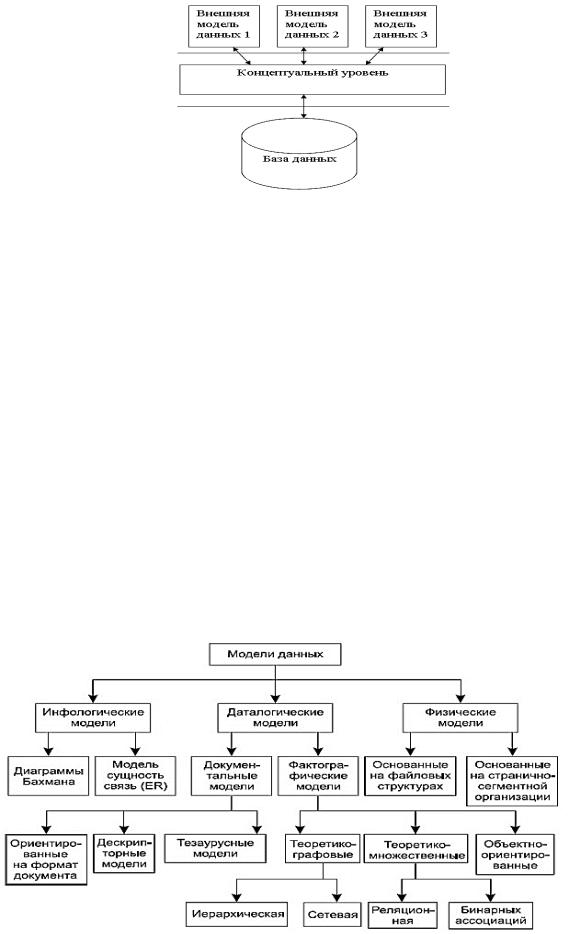
14
Рис. 2.1. Трехуровневая модель системы управления базой данных, предложенная ANSI
1.Уровень внешних моделей - самый верхний уровень, где каждая модель имеет свое «видение» данных. Этот уровень определяет точку зрения на БД отдельных приложений. Каждое приложение видит и обрабатывает только те данные, которые необходимы именно этому приложению. Например, система распределения работ использует сведения о квалификации сотрудника, но ее не интересуют сведения об окладе, домашнем адресе и телефоне сотрудника, и наоборот, именно эти сведения используются в подсистеме отдела кадров.
2.Концептуальный уровень - центральное управляющее звено, здесь база данных
представлена в наиболее общем виде, который объединяет данные, используемые всеми приложениями, работающими с данной базой данных. Фактически концептуальный уровень отражает обобщенную модель предметной области (объектов реального мира), для которой создавалась база данных. Как любая модель, концептуальная модель отражает только существенные, с точки зрения обработки, особенности объектов реального мира.
3. Физический уровень - собственно данные, расположенные в файлах или в страничных структурах, расположенных на внешних носителях информации.
Эта архитектура позволяет обеспечить логическую (между уровнями 1 и 2) и физическую (между уровнями 2 и 3) независимость при работе с данными. Логическая независимость предполагает возможность изменения одного приложения без корректировки других приложений, работающих с этой же базой данных. Физическая независимость предполагает возможность переноса хранимой информации с одних носителей на другие при сохранении работоспособности всех приложений, работающих с данной базой данных. Это именно то, чего не хватало при использовании файловых систем.
Выделение концептуального уровня позволило разработать аппарат централизованного управления базой данных.
Рис. 2.3. Классификация моделей данных В соответствии с рассмотренной ранее трехуровневой архитектурой мы сталкиваемся с
понятием модели данных по отношению к каждому уровню. И действительно, физическая модель данных оперирует категориями, касающимися организации внешней памяти и структур
15
хранения,используемыхвданной операционной среде.Внастоящий моментвкачествефизических моделей используются различные методы размещения данных, основанные на файловых структурах: это организация файлов прямого и последовательного доступа, индексных файлов и инвертированных файлов, файлов, использующих различные методы хэширования, взаимосвязанных файлов. Кроме того, современные СУБД широко используют страничную организацию данных. Физические модели данных, основанные на страничной организации, являются наиболее перспективными.
Наибольший интерес вызывают модели данных, используемые на концептуальном уровне. По отношению к ним внешние модели называются подсхемами и используют те же абстрактные категории, что и концептуальные модели данных.
Кроме трех рассмотренных уровней абстракции при проектировании БД существует ещеодинуровень,предшествующийим.Модельэтогоуровнядолжнавыражатьинформацию о предметной области в виде, независимом от используемой СУБД. Эти модели называются инфологическими, или семантическими, и отражают в естественной и удобной для разработчиков и других пользователей форме информационно-логический уровень абстрагирования, связанный с фиксацией и описанием объектов предметной области, их свойств и их взаимосвязей.
Инфологические модели данных используются на ранних стадиях проектирования для описания структур данных в процессе разработки приложения, а дата-логические модели уже поддерживаются конкретной СУБД.
Этапы проектирования баз данных
Реализацию сложных проектов по созданию информационных систем (ИС) принято разбивать на стадии анализа, проектирования, кодирования, тестирования и сопровождения. Известно, что исправление ошибок, допущенных на предыдущей стадии, обходится примерно в 10 раз дороже, чем на текущей, следовательно, наиболее критическими являются первые стадии проекта – анализа и проектирования.
Процесс разработки БД можно разбить на несколько этапов:
•Исследование предметной области;
•Инфологическое моделирование;
•Даталогическое проектирование;
•Даталогическое моделирование;
•Проектирование на физическом уровне.
Инфологическое моделирование
Данный этап заключается в создании концептуальной модели данных для анализируемой части предприятия. Модель данных создается на основе информации, записанной в спецификациях требований пользователей. Концептуальное проектирование базы данных абсолютно не зависит от таких подробностей ее реализации, как тип выбранной целевой СУБД, набор создаваемых прикладных программ, используемые языки программирования, тип выбранной вычислительной платформы, а также от любых других особенностей физической реализации. При разработке концептуальная модель данных постоянно подвергается тестированию и проверке на соответствие требованиям пользователей. Созданная концептуальная модель данных предприятия является источником информации для этапа логического проектирования базы данных.
Концептуальная модель строится с использованием стандартных языковых средств, обычнографических,напримерER-диаграмм(диаграмм«Сущность-связь»).Такаямодельстроится без ориентации на какую-либо конкретную СУБД.
Основные элементы данной модели:
1.Описание объектов предметной области и связей между ними.
2.Описание информационных потребностей пользователей (описание основных запросов к БД).
3.Описание алгоритмических зависимостей между данными.