Материал: для поступления в магистратуру
101
на производительность, надежность, стоимость и другие ее характеристики, а также решаются задачи обоснования выбора варианта структурной и функциональной организации системы и оптимальных параметров и внешних характеристик входящих в ее состав устройств ЭВМ, т.е. выполняется структурная и параметрическая оптимизация ВС.
Единицей измерения производительности компьютера является время: компьютер, выполняющий тот же объем работы за меньшее время является более быстрым. Время выполнения любой программы измеряется в секундах. Часто производительность измеряется как скорость появления некоторого числа событий в секунду, так что меньшее время подразумевает большую производительность.
Однако в зависимости от того, что мы считаем, время может быть определено различными способами.Наиболеепростойспособопределениявремениназываетсяастрономическимвременем, временем ответа (response time), временем выполнения(execution time) или прошедшим временем (elapsed time). Это задержка выполнения задания, включающая буквально все: работу процессора, обращения к диску, обращения к памяти, ввод/вывод и накладные расходы операционной системы. Однако при работе в мультипрограммном режиме во время ожидания ввода/вывода для одной программы, процессор может выполнять другую программу, и система не обязательно будет минимизировать время выполнения данной конкретной программы.
Для измерения времени работы процессора на данной программе используется специальный параметр - время ЦП (CPU time), которое не включает время ожидания ввода/вывода или время выполнения другой программы. Очевидно, что время ответа, видимое пользователем, является полным временем выполнения программы, а не временем ЦП. Время ЦП может далее делиться на время, потраченное ЦП непосредственно на выполнение программы пользователя и называемое пользовательским временем ЦП, и время ЦП, затраченное операционной системой на выполнение заданий, затребованных программой, и называемое системным временем ЦП.
Вряде случаев системное время ЦП игнорируется из-за возможной неточности измерений, выполняемых самой операционной системой, а также из-за проблем, связанных со сравнением производительности машин с разными операционными системами. С другой стороны, системный код на некоторых машинах является пользовательским кодом на других и, кроме того, практически никакая программа не может работать без некоторой операционной системы. Поэтому при измерениях производительности процессора часто используется сумма пользовательского и системного времени ЦП.
Вбольшинстве современных процессоров скорость протекания процессов взаимодействия внутренних функциональных устройств определяется не естественными задержками в этих устройствах,азадаетсяединойсистемойсинхросигналов,вырабатываемыхнекоторымгенератором тактовых импульсов, как правило, работающим с постоянной скоростью. Дискретные временные события называются тактами синхронизации (clock ticks), просто тактами (ticks), периодами синхронизации (clock periods), циклами (cycles) или циклами синхронизации (clock cycles).Разработчики компьютеров обычно говорят о периоде синхронизации, который определяется либо своей длительностью (например, 10 наносекунд), либо частотой (например, 100 МГц). Длительность периода синхронизации есть величина, обратная к частоте синхронизации.
Таким образом, время ЦП для некоторой программы может быть выражено двумя способами: количеством тактов синхронизации для данной программы, умноженным на длительность такта синхронизации, либо количеством тактов синхронизации для данной программы, деленным на частоту синхронизации.
Важной характеристикой, часто публикуемой в отчетах по процессорам, является среднее количествотактовсинхронизациинаоднукоманду - CPI(clockcyclesperinstruction).Приизвестном количестве выполняемых команд в программе этот параметр позволяет быстро оценить время ЦП для данной программы.
Таким образом, производительность ЦП зависит от трех параметров: такта (или частоты) синхронизации, среднего количества тактов на команду и количества выполняемых команд. Невозможно изменить ни один из указанных параметров изолированно от другого, поскольку базовые технологии, используемые для изменения каждого из этих параметров, взаимосвязаны: частота синхронизации определяется технологией аппаратных средств и функциональной организацией процессора; среднее количество тактов на команду зависит от функциональной
102
организации и архитектуры системы команд; а количество выполняемых в программе команд определяется архитектурой системы команд и технологией компиляторов. Когда сравниваются две машины, необходимо рассматривать все три компоненты, чтобы понять относительную производительность.
Технология распределенной обработки данных
Распределенная обработка данных – обработка данных, выполняемая на независимых, но связанных между собой компьютерах, представляющих распределенную систему.
Для реализации распределенной обработки данных были созданы многомашинные ассоциации, структура которых разрабатывается по одному из следующих направлений:
-многомашинные вычислительные комплексы;
-компьютерные (вычислительные) сети. Направления в технологиях распределенных систем:
-технология «клиент-сервер»;
-технологии объектного связывания;
-технологии реплицирования.
Технология «клиент-сервер». При реализации данной технологии отступают от одного из основных принципов создания распределенных систем – отсутствия центрального узла. Принцип централизации хранения и обработки данных является базовым принципом технологии клиентсервер.
Один из основных принципов технологии «клиент-сервер» заключается в разделении операций обработкиданныхнатри группы,имеющиеразличнуюприроду. Первая группа – это ввод и отображение данных. Вторая группа объединяет прикладные операции обработки данных, характерные для решения задач данной предметной области.К третьей группе относятся операции хранения и управления данными (базами данных или файловыми системами).
Технологии объектного связывания. С узкой точки зрения, технология объектного связывания данных решает задачу обеспечения доступа из одной локальной базы, открытой одним пользователем, к данным в другой локальной базе (в другом файле), возможно находящейся на другой вычислительной установке, открытой и эксплуатируемой другим пользователем.
Решение этой задачи основывается на поддержке современными «настольными» СУБД
(MS Access, MS FoxPro, dBase и др.) технологии «объектов доступа к данным» — DAO (Data Access Objects). Под объектом понимается интеграция данных и методов их обработки в одно целое (объект), на чем, как известно, основываются технологии объектно-ориентированного программирования. Другими словами, СУБД, поддерживающие DAO, получают возможность внедрять и оперировать в локальных базах объектами доступа к данным, физически находящимся в других файлах, возможно на других вычислительных установках и под управлением других СУБД. Связанные объекты для пользователя ничем не отличаются от внутренних объектов. Пользователь может также открывать связанные во внешних базах таблицы данных, осуществлять поиск, изменение, удаление и добавление данных, строить запросы по таким таблицам и т. д. Связанные объекты можно интегрировать в схему внутренней базы данных, т. с. устанавливать связи между внутренними и связанными таблицами.
Технологии реплицирования
Репликой называют особую копию базы данных для размещения на другом компьютере сети с целью автономной работы пользователей с одинаковыми (согласованными) данными общего пользования.
Основная идея реплицирования заключается в том, что пользователи работают автономно с одинаковыми (общими) данными, растиражированными по локальным базам данных. Производительность работы системы повышается из-за отсутствия необходимости передачи и обмена данными по сети.
Программное обеспечение СУБД для реализации такого подхода соответственно дополняется функциями тиражирования (реплицирования) баз данных.
При этом, однако, возникают проблемы обеспечения одного из основополагающих принципов построения и функционирования распределённых систем, а именно – принципа
103
непрерывности согласованного состояния данных.
Технологии репликации данных в тех случаях, когда не требуется обеспечивать большие потоки и интенсивность обновляемых в информационной сети данных, являются экономичным решением проблемы создания распределенных информационных систем с элементами централизации по сравнению с использованием дорогостоящих клиент-серверных систем.
На практике для совместной коллективной обработки данных применяются смешанные технологии, включающие элементы объектного связывания данных, репликаций и клиентсерверных решений. Развитие и все более широкое распространение распределенных информационных систем является основной перспективой развития автоматизированных информационных систем.
104
Задачи сортировки Анализ сложности и эффективности алгоритмов сортировки
Задачи сортировки
Задачу сортировки следует понимать, какпроцессперегруппировки однотипных элементов структуры данных в некотором определенном порядке. Цель сортировки - облегчить последующий поиск, обновление, исключение, включение элементов в структуру данных.
Разработано множество алгоритмов сортировки, однако нет алгоритма, который был бы наилучшим в любом случае.
Эффективность алгоритма сортировки может зависеть от ряда факторов, таких, как: число сортируемых элементов; диапазон и распределение значений сортируемых элементов; степень отсортированности элементов; характеристики алгоритма (сложность, требования к памяти и тп.); место размещения элементов (в оперативной памяти или на ВЗУ).
Сортируемые элементы часто представляют собой записи, данных определенной структуры. Каждая запись имеет поле ключа, по значению которого осуществляется сортировка, и поляданных.Прирассмотренииалгоритмовсортировкинасинтересуеттолькополеключа,поэтому другие поля опускаются из рассмотрения.
Метод сортировки называется устойчивым, если в процессе сортировки относительное расположение элементов с одинаковыми (равными) ключами не изменяется. Устойчивость сортировки желательна, если речь идет об элементах, уже отсортированных по некоторым другим ключам (свойствам), не влияющим на ключ, по которому сейчас осуществляется сортировка.
Внутренняя и внешняя сортировки
В зависимости от фактора размещения элементов все методы сортировки разбивают на два класса: внутренняя сортировка (сортировка массивов) и внешняя сортировка (сортировка файлов, или сортировка последовательностей).
Внешняя сортировка оперирует с запоминающими устройствами большого объёма, но с доступом не произвольным, а последовательным, т. е. в данный момент мы «видим» только один элемент, а затраты на перемотку по сравнению с памятью неоправданно велики. Это накладывает некоторые дополнительные ограничения на алгоритм и приводит к специальным методам упорядочения, обычно использующим дополнительное дисковое пространство. Кроме того, доступ к данным на носителе производится намного медленнее, чем операции с оперативной памятью.
Алгоритмы сортировки
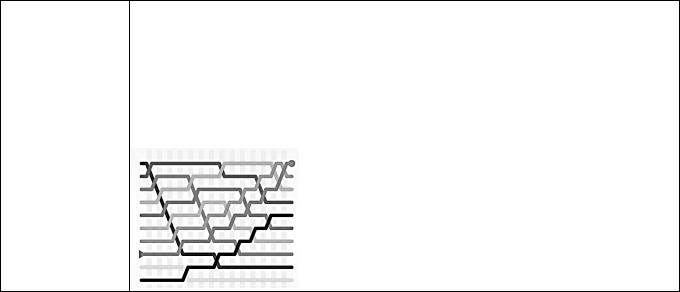
Один из простейших методов сортировки. Заключается в постепенном
смещении элементов с большим значением в конец массива. Элементы последовательно сравниваются попарно, и если порядок в паре нарушен – меняются местами.
Алгоритм проходит по заданному массиву множество раз, каждый раз сравнивая пару соседних друг с другом чисел. Если числа стоят не в том
порядке, в котором должны, он меняет их местами.
Сортировка Элементы сортируемого массива «всплывают», как пузырьки воздуха в воде.
пузырьком
105
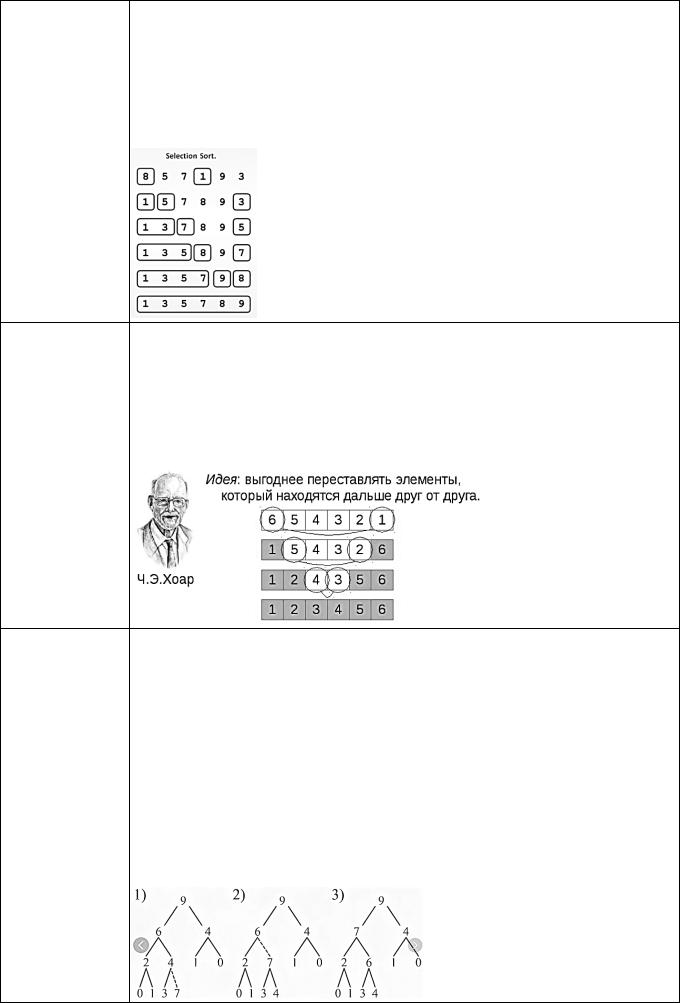
Алгоритм ищет наименьший элемент в текущем списке и производит обмен его
значения со значением первой неотсортированной позиции. То же самое происходит со вторым элементом с наименьшим значением. Цикл повторяется до тех пор, пока все элементы не займут нужную последовательность.
Алгоритм ищет минимальный (или максимальный) элемент сортируемого массива и меняет его местами с первым несортированным элементом. Стандартный поиск минимума для каждого из n элементов – это квадрат.
Сортировка Сложность: O(n2 )
выбором
|
Считается одним из самых быстрых алгоритмов сортировки. Как и сортировка |
|
слиянием, работает по принципу «разделяй и властвуй». Временная сложность |
|
алгоритма может достигать O(n log n). |
|
Ещё один рекурсивный алгоритм. Сначала проводится грубая оценка массива |
|
на основе некоторого элемента, называемого опорным. Все элементы, если |
|
сортируем по возрастанию, большие опорного, перекидываются направо от |
|
него, а все меньшие – налево. Массив делится на две части, каждая из которых |
Быстрая |
сортируется отдельно. |
сортировка |
|
Имея построенную пирамиду, несложно реализовать сортировку. Так как
корневой узел пирамиды имеет самое большое значение, мы можем отделить его и поместить в конец массива. Вместо корневого узла можно поставить последний узел дерева и, просеяв его вниз, снова получить пирамиду. В новом дереве корень имеет самое большое значение среди оставшихся элементов. Его снова можно отделить, и так далее. Алгоритм получается следующий:
1.поменять местами значения первого и последнего узлов пирамиды;
2.отделить последний узел от дерева, уменьшив размер дерева на единицу Сортировка (элемент остаётся в массиве);
кучей |
3. |
восстановить пирамиду, просеяв вниз её новый корневой элемент; |
(Пирамидальная 4. |
перейти к пункту 1; |
|
сортировка) |
По мере работы алгоритма, часть массива, занятая деревом, уменьшается, а в |
|
|
конце массива накапливается отсортированный результат. |
|
|
Процесс просеивания: |
|