Материал: Информационная безопасность и защита информации. учебное пособие. Паринов А.В., Федорков Е.Д
Характер применения блочного шифра для хеширования определяется отношением размера блока используемого криптоалгоритма и разрядности требуемого хеш-результата.
Если указанные выше величины совпадают, то используется схема одноцепочечного блочного шифрования. Первоначальное значение хеш-результата H0 устанавливается равным 0, вся строка-пароль разбивается на блоки байт, равные по длине ключу используемого для хеширования блочного шифра, затем производятся преобразования по реккурентной формуле Hj=Hj-1 XOR EnCrypt(Hj-1,PSWj), где EnCrypt(X,Key) – используемый блочный шифр (рис. 2.21). Последнее значение Hk используется в качестве искомого результата.
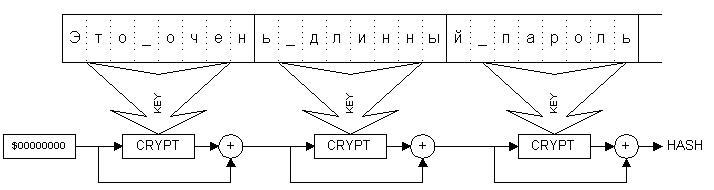 Рис.
2.21
В том случае, когда длина ключа ровно в два раза превосходит длину блока, а подобная зависимость довольно часто встречается в блочных шифрах, используется схема, напоминающая сеть Фейштеля. Характерным недостатком и приведенной выше формулы, и хеш-функции, основанной на сети Фейштеля, является большая ресурсоемкость в отношении пароля. Для проведения только одного преобразования, например, блочным шифром с ключом длиной 128 бит используется 16 байт строки-пароля, а сама длина пароля редко превышает 32 символа. Следовательно, при вычислении хеш-функции над паролем будут произведено максимум 2 "полноценных" криптопреобразования.
Решение этой проблемы можно достичь двумя путями : 1) предварительно "размножить" строку-пароль, например, записав ее многократно последовательно до достижения длины, скажем, в 256 символов; 2) модифицировать схему использования криптоалгоритма так, чтобы материал строки-пароля "медленнее" тратился при вычислении ключа.
По второму пути пошли исследователи Девис и Майер, предложившие алгоритм также на основе блочного шифра, но использующий материал строки-пароля многократно и небольшими порциями. В нем просматриваются элементы обеих приведенных выше схем, но криптостойкость этого алгоритма подтверждена многочисленными реализациями в различных криптосистемах. Алгоритм получил название "Tandem DM" (рис. 2.22):
G0=0; H0=0 ;
FOR J = 1 TO N DO
BEGIN
TMP=EnCrypt(H,[G,PSWj]); H'=H XOR TMP;
TMP=EnCrypt(G,[PSWj,TMP]); G'=G XOR TMP;
END;
Key=[Gk,Hk]
Квадратными скобками (X16=[A8,B8]) здесь обозначено простое объединение (склеивание) двух блоков информации равной величины в один – удвоенной разрядности. А в качестве процедуры EnCrypt(X,Key) опять может быть выбран любой стойкий блочный шифр. Как видно из формул, данный алгоритм ориентирован на то, что длина ключа двукратно превышает размер блока криптоалгоритма. А характерной особенностью схемы является тот факт, что строка пароля считывается блоками по половине длины ключа, и каждый блок используется в создании хеш-результата дважды. Таким образом, при длине пароля в 20 символов и необходимости создания 128 битного ключа внутренний цикл хеш-функции повторится 3 раза.
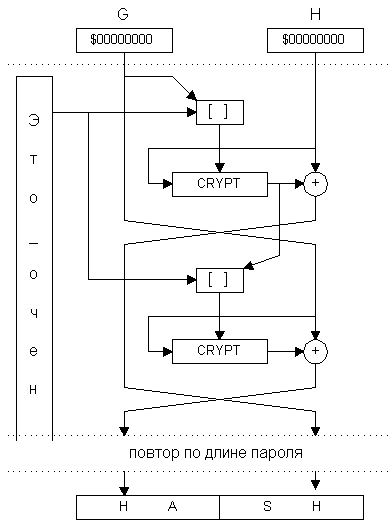 Рис.
2.22
2.3.6. Транспортное кодирование
Поскольку системы шифрования данных часто используются для кодирования текстовой информации : переписки, счетов, платежей электронной коммерции, и при этом криптосистема должна быть абсолютно прозрачной для пользователя, то над выходным потоком криптосистемы часто производится транспортное кодирование, то есть дополнительное кодирование (не шифрование !) информации исключительно для обеспечения совместимости с протоколами передачи данных. Все дело в том, что на выходе криптосистемы байт может принимать все 256 возможных значений, независимо от того был ли входной поток текстовой информацией или нет. А при передаче почтовых сообщений многие системы ориентированы на то, что допустимые значения байтов текста лежат в более узком диапазоне : все цифры, знаки препинания, алфавит латиницы плюс, возможно, национального языка. Первые 32 символа набора ASCII служат для специальных целей. Для того чтобы они и некоторые другие служебные символы никогда не появились в выходном потоке, используется транспортное кодирование. Наиболее простой метод состоит в записи каждого байта двумя шестнадцатиричными цифрами-символами. Так байт 252 будет записан двумя символами 'FC'; байт с кодом 26, попадающий на специальный символ CTRL-Z, будет записан двумя допустимыми символами '1A'. Но эта схема очень избыточна : в одном байте передается только 4 бита информации. На самом деле практически в любой системе коммуникации без проблем можно передавать около 68 символов (латинский алфавит строчный и прописной, цифры и знаки препинания). Из этого следует, что вполне реально создать систему с передачей 6 бит в одном байте (26<68), то есть кодировать 3 байта произвольного содержания 4-мя байтами из исключительно разрешенных (так называемых печатных) символов. Подобная система была разработана и стандартизирована на уровне протоколов сети Интернет – это система Base64 (стандарт RFC1251).
Процесс кодирования преобразует 4 входных символа в виде 24-битной группы, обрабатывая их слева направо. Эти группы затем рассматриваются как 4 соединенные 6-битные группы, каждая из которых транслируется в одиночную цифру алфавита Base64. При кодировании Base64 входной поток байтов должен быть упорядочен старшими битами вперед. Каждая 6-битная группа используется как индекс для массива 64-х печатных символов. Символ, на который указывает значение индекса, помещается в выходную строку. Эти символы выбраны так, чтобы быть универсально представимыми, и исключают символы, имеющие специальное значение (".", CR, LF). Выходной поток (закодированные байты) должен иметь длину строк не более 76 символов. Все признаки перевода строки и другие символы, отсутствующие в алфавмте, должны быть проигнорированы декодером Вase64. Среди данных в Base64 символы, не перечисленные в алфавите, переводы строки и т.п. должны говорить об ошибке передачи данных, и соответственно программа-декодер должна оповестить пользователя о ней. Если в хвосте потока кодируемых данных осталось меньше чем 24 бита, справа добавляются нулевые биты до образования целого числа 6-битных групп. А до конца 24-битной группы может оставаться только от 0 до 3-х недостающих 6-битных групп, вместо каждой из которых ставится символ-заполнитель "=". Поскольку весь входной поток представляет собой целое число 8-битных групп (т.е. просто байтных значений), то возможны лишь следующие случаи:
Входной поток оканчивается ровно 24-битной группой (длина файла кратна 3). В таком случае выходной поток будет оканчиваться четырьмя символами Base64 без каких-либо дополнительных символов.
"Хвост" входного потока имеет длину 8 бит. Тогда в конце выходного кода будут два символа Base64 с добавлением двух символов "=".
"Хвост" входного потока имеет длину 16 бит. Тогда в конце выходного потока будут стоять три символа Base64 и один символ "=".
Так как символ "=" является хвостовым заполнителем, его появление в теле письма может означать только то, что конец данных достигнут. Но опираться на поиск символа "=" для обнаружения конца файла неверно, так как если число переданных битов кратно 24, то в выходном файле не появится ни одного символа "="
значение |
код |
значение |
код |
значение |
код |
значение |
код |
0 |
А |
16 |
Q |
32 |
g |
48 |
w |
1 |
В |
17 |
R |
33 |
h |
49 |
x |
2 |
С |
18 |
S |
34 |
i |
50 |
y |
3 |
D |
19 |
T |
35 |
j |
51 |
z |
4 |
E |
20 |
U |
36 |
k |
52 |
0 |
5 |
F |
21 |
V |
37 |
l |
53 |
1 |
6 |
G |
22 |
W |
38 |
m |
54 |
2 |
7 |
H |
23 |
X |
39 |
n |
55 |
3 |
8 |
I |
24 |
Y |
40 |
o |
56 |
4 |
9 |
J |
25 |
Z |
41 |
p |
57 |
5 |
10 |
K |
26 |
a |
42 |
q |
58 |
6 |
11 |
L |
27 |
b |
43 |
r |
59 |
7 |
12 |
M |
28 |
c |
44 |
s |
60 |
8 |
13 |
N |
29 |
d |
45 |
t |
61 |
9 |
14 |
O |
30 |
e |
46 |
u |
62 |
+ |
15 |
P |
31 |
f |
47 |
v |
63 |
/ |
64 (=)-символ заполнитель
Общая схема симметричной криптосистемы с учетом всех рассмотренных пунктов изображена на рис. 2.23
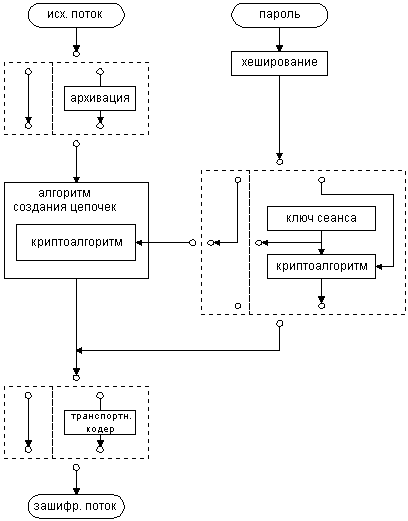 Рис.
2.23
2.4. Асимметричные криптоалгоритмы
2.4.1. Общие сведения об асимметричных криптоалгоритмах
Симметричные криптосистемы, рассмотренные нами в предыдущих главах, несмотря на множество преимуществ, обладают одним серьезным недостатком, о котором Вы, наверное, еще не задумывались. Связан он с ситуацией, когда общение между собой производят не три-четыре человека, а сотни и тысячи людей. В этом случае для каждой пары, переписывающейся между собой, необходимо создавать свой секретный симметричный ключ. Это в итоге приводит к существованию в системе из N пользователей N2/2 ключей. А это уже очень "приличное" число. Кроме того, при нарушении конфиденциальности какой-либо рабочей станции злоумышленник получает доступ ко всем ключам этого пользователя и может отправлять, якобы от его имени, сообщения всем абонентам, с которыми "жертва" вела переписку.
Своеобразным решением этой проблемы явилось появление асимметричной криптографии. Эта область криптографии очень молода по сравнению с другими представителями. Первая схема, имевшая прикладную значимость, была предложена всего около 20 лет назад. Но за это время асимметричная криптография превратилась в одно из основных направлений криптологии и используется в современном мире также часто, как и симметричные схемы.
Асимметричная криптография изначально задумана как средство передачи сообщений от одного объекта к другому (а не для конфиденциального хранения информации, которое обеспечивают только симметричные алгоритмы). Поэтому дальнейшее объяснение мы будем вести в терминах "отправитель" – лицо, шифрующее, а затем отпраляющее информацию по незащищенному каналу, и "получатель" – лицо, принимающее и восстанавливающее информацию в ее исходном виде. Основная идея асимметричных криптоалгоритмов состоит в том, что для шифрования сообщения используется один ключ, а при дешифровании – другой.
Кроме того, процедура шифрования выбрана так, что она необратима даже по известному ключу шифрования – это второе необходимое условие асимметричной криптографии. То есть, зная ключ шифрования и зашифрованный текст, невозможно восстановить исходное сообщение – прочесть его можно только с помощью второго ключа – ключа дешифрования. А раз так, то ключ шифрования для отправки писем какому-либо лицу можно вообще не скрывать – зная его, все равно невозможно прочесть зашифрованное сообщение. Поэтому ключ шифрования называют в асимметричных системах "открытым ключом", а вот ключ дешифрования получателю сообщений необходимо держать в секрете – он называется "закрытым ключом". Напрашивается вопрос : "Почему, зная открытый ключ, нельзя вычислить закрытый ключ ?" – это третье необходимое условие асимметричной криптографии – алгоритмы шифрования и дешифрования создаются так, чтобы, зная открытый ключ, невозможно вычислить закрытый ключ.
В целом система переписки при использовании асимметричного шифрования выглядит следующим образом. Для каждого из N абонентов, ведущих переписку, выбрана своя пара ключей : "открытый" Ej и "закрытый" Dj, где j – номер абонента. Все открытые ключи известны всем пользователям сети, каждый закрытый ключ, наоборот, хранится только у того абонента, которому он принадлежит. Если абонент, скажем, под номером 7 собирается передать информацию абоненту под номером 9, он шифрует данные ключом шифрования E9 и отправляет ее абоненту 9. Несмотря на то, что все пользователи сети знают ключ E9 и, возможно, имеют доступ к каналу, по которому идет зашифрованное послание, они не могут прочесть исходный текст, так как процедура шифрования необратима по открытому ключу. И только абонент № 9, получив послание, производит над ним преобразование с помощью известного только ему ключа D9 и восстанавливает текст послания. Заметьте, что если сообщение нужно отправить в противоположном направлении (от абонента 9 к абоненту 7), то нужно будет использовать уже другую пару ключей (для шифрования ключ E7, а для дешифрования – ключ D7).
Как мы видим, во-первых, в асимметричных системах количество существующих ключей связано с количеством абонентов линейно (в системе из N пользователей используются 2*N ключей), а не квадратично, как в симметричных системах. Во-вторых, при нарушении конфиденциальности k-ой рабочей станции злоумышленник узнает только ключ Dk : это позволяет ему читать все сообщения, приходящие абоненту k, но не позволяет вывадавать себя за него при отправке писем. Кроме этого, асимметричные криптосистемы обладают еще несколькими очень интересными возможностями, которые мы рассмотрим через несколько разделов