Дипломная (вкр): Исследование методов и реализация алгоритма моделирования распространения информации в социальных сетях
Продолжим
анализ задачи. При увеличении  от нуля
общая ЦФ приобретает значение
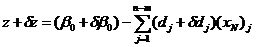 . (2.12)
Решение
 остается оптимальным до тех пор, пока выполняются
условия:
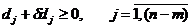 . (2.13)
Обобщим описанный выше метод в виде пошагового алгоритма:
Шаг
0. Найти решение начальной ЗЛП при  .
Шаг
1. Если  для всех
 (
 - множество индексов небазисных переменных), текущий
решение остается оптимальным при всех сколь угодно больших
 , Стоп. Иначе найти
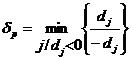 и
соответствующее
 .
Шаг
2. Если  , то мы определили все решения в заранее заданном
диапазоне изменения параметра
 , Стоп.
Шаг
3. Если  для всех
 (
 - множество индексов базисных переменных), то при
изменении базиса ЦФ становится неограниченным (если в столбце, соответствующей
переменной
 , все коэффициент не положительные, то при всех
 ЦФ неограниченное сверху), Стоп.
Иначе найти переменную, которую выводим из базиса, с помощью выражения
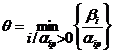 .
Пусть
минимум соответствует индексу  .
Шаг
4. Выполнить операцию замещения: ввести в базис переменную  , вывести из базиса переменную
 .
Шаг 5. Перейти на Шаг 1.
2.2 Анализ базовых требований к информационной системе для эффективной работы алгоритма
Поскольку сценарии использования интерфейсов социальных сетей не предполагают автоматического сбора данных множества пользователей с целью построения социального графа, то возникает ряд проблем:
. Приватность данных - зачастую доступ к данным пользователей разрешён только для зарегистрированных и авторизованных участников сети, что требует поддержки эмуляции пользовательской сессии с помощью специальных учётных записей (аккаунтов).
. Слабая структурированность данных - во многих случаях программные интерфейсы (API) социальных сетей имеют ограниченный функционал, что требует поддержки получения с помощью пользовательского веб-интерфейса статических копий HTML-страниц, корректной обработки их динамической части (включая исполнение асинхронных запросов к серверу социальной сети), извлечения нужных данных с помощью алгоритма и/или шаблона и построения их структурированного представления, удобного для дальнейшей автоматической обработки.
. Ограничения доступа и блокировки - с целью предотвращения несанкционированного автоматического сбора данных и ограничения нагрузки на инфраструктуру сервиса социальной сети владельцы сервисов зачастую вводят явные или скрытые ограничения на допустимое количество запросов от одного пользовательского 441 аккаунта и/или IP-адреса в единицу времени, что требует учёта количества посылаемых запросов, а также поддержки динамической ротации используемых для сбора данных пользовательских аккаунтов и IP-адресов.
. Размерность данных обуславливает необходимость в параллельном методе сбора данных, а также в методах получения репрезентативной выборки пользователей социальной сети (сэмплирование). В связи с постоянной необходимостью получения больших наборов данных из социальных сетей, был разработан фреймворк для сбора данных из различных интернет-сервисов.
Разработанный инструмент поддерживает скачивание данных из социальных сетей Facebook, Twitter, Hunch. Реализовано несколько способов получения репрезентативных выборок пользователей социальных сетей: сэмплирование методом обхода в ширину (breadth-first search, BFS) [1], по Метрополису- Гастингсу (Metropolis-Hastings Random Walk, MHRW) [3] и методом «лесного пожара» (Forest Fire, FF) [2].
Реализован механизм автоматического выбора учетной записи социальной сети для каждого запроса, а также поддержка прокси-соединений. Это обеспечивает устойчивость к блокировкам по IP - адресам и учетным записям. Кроме того, фреймворк поддерживает многопоточное скачивание. Одной из ключевых особенностей разработанного фреймворка является возможность быстро реализовать новые сценарии скачивания и методы сэмплинга.
Для оценки производительности фреймворка были проведены эксперименты, в которых скачивались профили пользователей социальных сетей Twitter, Facebook и Hunch. Были достигнуты следующие показатели:
· Facebook: более 500 профилей в час (один поток);
· Twitter: более 3000 профилей в час (один поток);
· Hunch: более 100 профилей в час (один поток).
Генерация случайных социальных графов. Несмотря на наличие средств для сбора данных из социальных сетей и большого количества доступных наборов данных, актуальной является задача создания моделей случайных социальных графов и инструментов для генерации случайных графов с заданным набором свойств. Для достоверного тестирования методов анализа социальных данных они должны быть применены к множеству наборов данных с различными свойствами.
К примеру, методы поиска сообществ пользователей в социальном графе могут показывать существенно различные результаты в зависимости от 442 размера исходного графа, средней степени вершины, коэффициента кластеризации и других структурных свойств. Сбор необходимых для достоверного тестирования реальных данных затруднён не только вследствие временных затрат на скачивание и обработку больших массивов слабоструктурированной информации, но и в силу сложности управления процессом сбора с целью получения набора данных с конкретным набором свойств. Размер графа, 106 вершин Размер графа, 103 вершин.
Результаты тестирования времени генерации случайных графов с заданной структурой сообществ. Вверху: на кластерах Amazon EC2 с различным количеством рабочих узлов типа m1.large: зелёная линия - 2 узла, жёлтая линия - 4 узла, красная линия - 8 узлов, синяя линия - 16 узлов.
Внизу: на одном компьютере. 443 Были разработаны модель и оригинальный метод для генерации случайных графов, обладающих основными свойствами социальных сетей (распределение степеней, диаметр, коэффициент кластеризации и т.д.) и заданной структурой сообществ пользователей. Для каждого пользователя осуществляется генерация атрибутов профиля, социальных связей, сообществ и текстовых сообщений.
Предложенный метод имеет распределённую реализацию на основе фреймворка Apache Spark1, что позволяет создавать случайные графы большой размерности для тестирования производительности и точности методов анализа социальных данных.
Кроме того, в контентных сетях (Twitter, YouTube) пользовательский профиль часто ограничен набором базовых атрибутов, недостаточным для решения многих задач, предполагающих персонализацию результатов. Таким образом, актуальны методы частичной идентификации авторов сообщений по значениям их демографических атрибутов.
В частности, в системах интернет-маркетинга и рекомендаций особую важность представляет определение демографических атрибутов пользователя для таргетированного продвижения товаров и услуг в группах пользователей с одинаковыми значениями атрибутов. Помимо интернет-сервисов, такие демографические характеристики находят применение в различных дисциплинах: социология, психология, криминология, экономика, управление персоналом и др.
Демографические атрибуты можно условно разделить на категориальные (пол, национальность, раса, семейное положение, уровень образования, профессия, трудоустроенность, религиозные и политические взгляды) и численные (возраст, уровень доходов). Условность разделения связана с тем, что значения численного атрибута можно отобразить в набор категорий и в дальнейшем рассматривать этот атрибут как категориальный. В частности, значения возраста можно разделить на несколько возрастных категорий, что часто применяется на практике.
Разработанный метод определения демографических атрибутов пользователей сети Twitter по текстам их сообщений обладает следующими особенностями:
. Широкий набор поддерживаемых атрибутов: пол, возраст, семейное положение, религиозные и политические взгляды.
. Широкий набор поддерживаемых языков: русский, английский, испанский, немецкий, французский, итальянский, португальский, корейский, китайский.
. Полностью автоматический метод сбора и разметки корпусов сообщений пользователей интернета для всех поддерживаемых атрибутов и языков.
Выводы по второй главе
В данном разделе была сформулирована содержательная и математическая постановки задачи составления плана производства с учетом динамики рыночных цен на продукцию и определено, что она относится к классу задач параметрического программирования. Была также сформулирована вспомогательная задача определения коэффициентов параметрической составляющей целевой функции предыдущей задачи.
Выполнено строительство вспомогательной задачи к задаче линейного программирования. Приведено подробное описание алгоритмов решения задачи параметрического программирования и задачи определения параметрической составляющей, в основе которых лежит применение симплекс-метода.
При анализе социальных данных, были разработаны соответствующие алгоритмические и инфраструктурные решения, позволяющие учитывать их размерность.
Проанализированы существующие методы и реализации алгоритма моделирования распространения информации в социальных сетях.
Проанализировано математическое описание алгоритма моделирования распространения информации в социальных сетях.
При разработке модели «поиска кратчайшего пути», была определена эффективность его работы в контексте среды социальной сети Twitter. Отмечена высокая скорость обработки класса запросов типа POST.
Генерация графа из 1 миллиарда вершин заняла около 2 часов на кластере
Amazon EC2 со 100 рабочими узлами типа m1.large. 4. Определение демографических
атрибутов пользователей. При заполнении своего профиля в социальной сети
пользователи зачастую по ошибке или преднамеренно не заполняют некоторые поля
либо дают ложную информацию о фактах своей биографии, интересах и
предпочтениях.
3. Программная реализация алгоритма моделирования распространения информации в социальной сети «Twitter»
.1 Описание и анализ технологий для реализации задачи моделирования алгоритма
Выбор стека технологий начнем с требований к аппаратной части, а также к программным компонентам с точки зрения нагрузки. Облачные технологии обеспечивают удобный сетевой доступ к общему пулу распределенных конфигурируемых вычислительных и программных ресурсов и устройств хранения информации, которые могут быть оперативно предоставлены и освобождены с минимальными эксплуатационными затратами и / или обращениями к провайдеру. Потребители облачных вычислений могут значительно уменьшить расходы на содержание собственной инфраструктуры информационных технологий, а также динамично реагировать на изменения вычислительных потребностей в моменты пиковой нагрузки, используя свойство вычислительной эластичности (Elastic computing) облачных услуг.
Среди различных форм организации и предоставления таких услуг, к которым относятся Saas (Software as a Service), Paas (Platform as a Service) и Iaas (Infrastructure as a Service), последняя является наиболее гибким решением, позволяющие разворачивать распределены «виртуальные офисы» и формировать программное окружение аналогичное тому, которое установлено на персональном компьютере или локальном сервере. Фундаментальный сдвиг в самой природе обработки информации. Она смещается в сторону модели Utility Computing, то есть предоставление вычислительных ресурсов по принципу коммунальных услуг, предполагает, во-первых, выполнение большинства вычислительных задач в специализированных дата-центрах, и, во-вторых, доставку полученных результатов по каналам Internet аналогично электрической энергии.
Это обусловило стремительный рост, внедрение и использование приложений, функционирующих на основе модели облачных вычислений в различных областях деятельности человека: от научных исследований и средств массовой информации к почтовым сервисам, корпоративных компьютерных систем, систем электронной коммерции и информационных Web-ресурсов.
Концепция разработки и развертывания облачной инфраструктуры базируется результатах анализа существующих решений и собственных исследований.
Традиционные архитектуры облачных систем предусматривают их построение на базе многоуровневой сетевой инфраструктуры виртуальных центров обработки данных (ЦОД) [8] и поддержки в виде программной платформы с набором сервисов. Типичная архитектура любого облачного ЦОД имеет иерархическую структуру, состоящую из 3 основных уровней:
Уровня ядра (Core). На этом уровне работают маршрутизаторы или коммутаторы 3 уровня, которые составляют основу всей сети дата-центра с высокоскоростными портами (10/40/100 GbЕ) для маршрутизации потоков между WAN и сети дата-центра.
Уровня агрегации (Aggregation или Distribution). На этом уровне также функционируют коммутаторы 3 уровня, основное назначение которых - распределение нагрузки между локальными сетями дата-центра.
Уровня доступа (Access). На этом уровне располагаются конечные точки (сервера, рабочие станции и др.) И сетевое оборудование, связывает конечные точки с уровнем агрегации. На уровне доступа функционируют кластера дата-центров, состоящих из множества физических серверов и большого количества виртуальных машин на каждом из них. На этом же уровне чаще всего располагается общая сеть хранения данных SAN (Storage Area Network). Группа, состоящая из взаимосвязанных компонентов хранения данных, вычислительных и сетевых ресурсов, которые работают совместно на уровне доступа, чтобы предоставить сервис или приложение клиенту называется точкой доставки или POD (Point of delivery).
 Высокая
готовность виртуального ЦОД достигается за счет дублирования сетевых устройств
на каждом уровне и использования резервных маршрутов и методов балансировки
нагрузки.
Компоненты низкого уровня - сервера, которые объединяются в кластер. На каждом физическом сервере функционирует несколько виртуальных машин, то есть на одном физическом сетевом интерфейсе есть несколько виртуальных, обменом между которыми управляет программный компонент гипервизор (Virtual Machine Monitor / Hypervisor).
Облачные IT-инфраструктуры учебного заведения включают в себя следующие компоненты:
· ядро облака - ядро всей IT-инфраструктуры;
· персональные компьютеры в лабораториях, являются узлами облака.
Ожидаемая эволюция портала имеет две составляющие: развитие функционала и привлечения участников. Даже не прикасаясь финансовой, имеем многое реализовать. В общем, планируются следующие уровни использования и возможностей:
· социальная сеть для коммуникаций и поиска контактов;