Дипломная (вкр): Исследование методов и реализация алгоритма моделирования распространения информации в социальных сетях
Примененные алгоритмы поиска кратчайшего пути используются для эффективного выбора свободного и самого ближайшего сервера передачи и обработки данных.
Анализ выражений 2.1 - 2.8 свидетельствует, что их условно можно разделить на два типа: "жесткие". Нарушение "жестких" условиях приводит к распределению, который не может быть реализован физически, поэтому значение функции приспособленности для этого случая равна нулю и соответствующая особь в дальнейшем исключается из расчетов.
Нарушение "мягких" условиях приводит к ситуации, когда распределение может быть реализован физически, однако задачу по отношению к соответствующему объекту не будет выполнено. Поэтому для таких объектов функция локальной эффективности принудительно устанавливается равной нулю, однако соответствующие особи с дальнейшей эволюции не исключаются и могут выступать родителями для формирования следующего поколения.
Такую регулятивную функцию и выполняет коэффициент kj. Общее количество генов в хромосоме соответствует количеству объектов поражения. Каждый ген содержит значение количества боевых единиц, назначаются на соответствующий объект. Такая структура хромосомы отвечает полиалельному варианта генетического алгоритма (ГА), который и был использован для решения задачи.
Переходя к практической модели данных, определим значения для ввода и апробации интерфейса и функциаональности системы, работающей на основе генетического алгоритма.
Опубликуем в аккаунте твиттер посты со следующим содержанием: «1», «2»,
«3». Пост с текстом «2» будет опубликован, когда кто-либо «лайкнет» пост 1.
Пост с текстом «3» будет опубликован, когда кто-либо лайнет пост 2.
4.3 Описание результатов эксперимента
Анализ данных может быть получен как в автоматическом режиме так и в ручном. Программа может сама проанализировать собранную информацию и представить в наглядном виде. Эта возможность реализована по следующим категориям:
В результате работы приложения, полученная информация обрабатывается, после чего представляется в удобном виде. Категории, по которым автоматически обрабатывается информация: возраст, пол, местонахождение, образование, модель поведения в социальных медиа. Если возникает необходимость получить анализ любого другого направления, например, род занятий, интересы, потребительские предпочтения, цели пользования Интернетом и т.д., тогда необходим определенный порядок действий:
• загрузить базу данных XML с сервера на локальный компьютер;
• импортировать XML в Microsoft Access, используя штатный механизм Access;
• с помощью средств Microsoft Access сделать выборку;
• обработать выборку с помощью Microsoft Access или Microsoft Excel.
Для обработки данных с Microsoft Access можно использовать и любые другие программные средства, которые могут быть полезными для других задач.
В общем информация внутри XML базы данных хранятся в таком
виде:
<UserInfo>
<Код> 1 </ Код>
<id_vk> 1702950 </ id_vk>
<Name> Батырбек </ Name>
<SecondName> Айналимов </ SecondName>
<BD> 27.05.1990 </ BD>
<Sex> 1 </ Sex>
<Contry> Россия </ Contry>
<City> Волжский </ City>
<Param1> 1 </ Param1>
...
<Param20> 5 </ Param20>
</ UserInfo>
Но мешая убыточности XML файлов и их большой размер, теги максимально сокращены, отсутствуют атрибуты, а дополнительные параметры сгруппированы в одно поле, которое отсутствует для записей, описывающих пользователя, который не прошел анкетирование.
Таким образом конечный XML файл выглядит следующим образом:
<? xml version = "1.0" encoding = "UTF-8"?>
<dataroot xmlns: od = «urn: schemas-microsoft-com: officedata» xmlns: xsi = "#"863940.files/image076.gif">
Рисунок 22 - Мои Заметки
Авторизируемся в системе (рисунок 23).
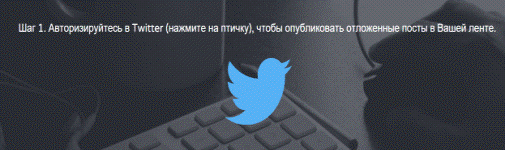
Рисунок 23 - Авторизация в системе
Авторизируемся в Twitter
(рисунок 24).
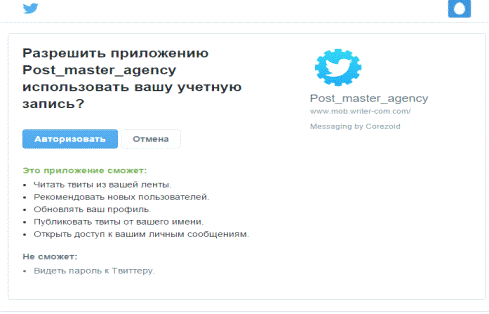
Рисунок 24 - Авторизация в системе Twitter
Нажмем кнопку «Добавить сообщение», чтобы подготовить формы для ввода
трех постов (рисунок 25).
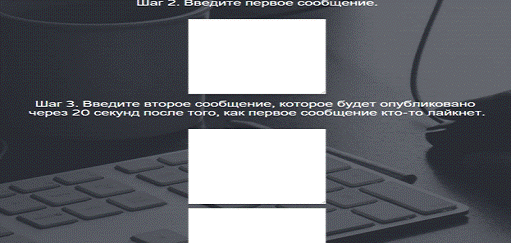
Рисунок 25 - Добавление нового поля ввода
Введем текст постов и дополнительно загрузим 500 постов через Dashboard системы Corezoid (рисунок 26).
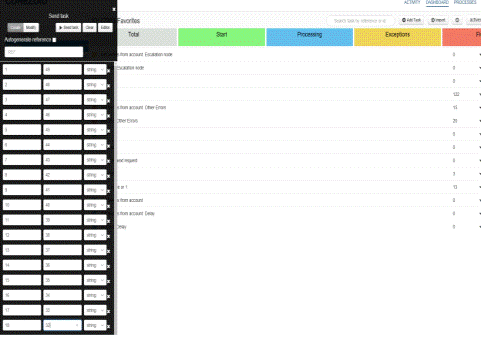
Рисунок 26 - Ввод текста сообщений
Нажмем кнопку «Публиковать» (рисунок 27).
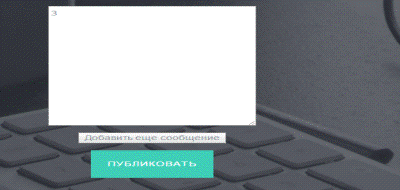
Рисунок 27 - Публикация сообщений
Дейстивтельно, публикация первых постов происходила после «лайка» каждого
предыдущего поста (рисунок 28).
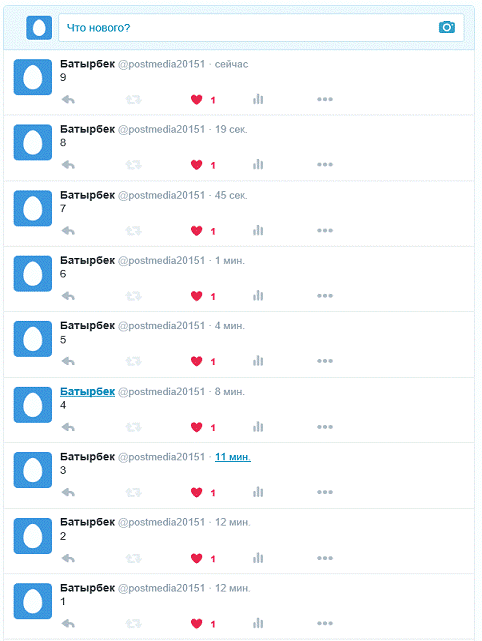
Рисунок 28 - Публикация первых постов
Пятьсотый пост также был успешно опубликован спустя неделю, когда
пользователь поставил лайк на предыдущем посте (рисунок 29).
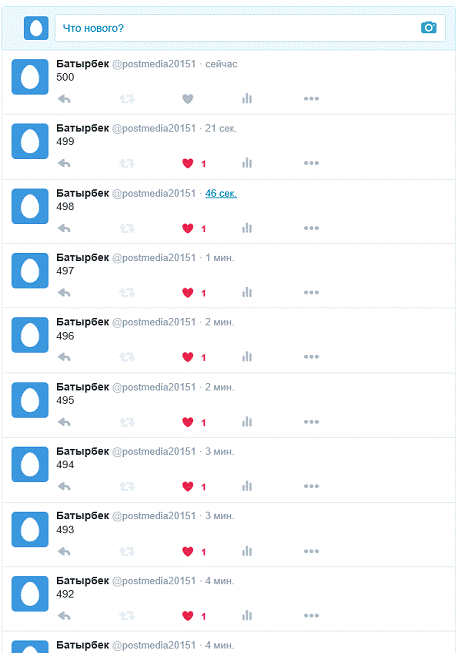
Рисунок 29 - Публикация последних постов
Нагрузочное тестирование системы было выполнено в течение
недели после публикации первого поста. Для этого была измерена нагрузка на
центральный процессор сервера в течение публикации 500 постов. Полученный
график нагрузки отображен на рисунке 30.
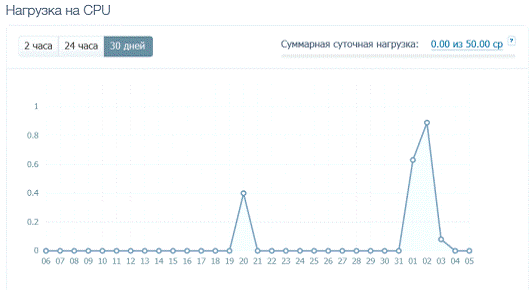
Рисунок 30 - Нагрузка на центральный процессор сервера публикаций Corezoid
Как видно из графика, изображенного на рисунке 36, суммарная суточная нагрузка на центральный процессор при публикации 500 сообщений не превышает 1 cp, а соответственно стоит отметить эффективность генетического алгоритма постинга сообщений.
В результате проведенной апробации были получены ожидаемые результаты. Отклонений в работе системы относительно рассчетных данных не выявлено.
Выводы по четвёртой главе
В результате проведенной апробации был проведен практический расчет эффективности работы системы по алгоритмам, применённым для решения задачи.
Практическая часть тестирования основывалась на создании и успешном выполнении тестовой публикации медиа-плана. В течение всего периода тестирования оценивались показатели качества интерфейса системы.
Анализ выражений 2.1 - 2.8 свидетельствует, что их условно можно разделить на два типа: "жесткие". Нарушение "жестких" условиях приводит к распределению, который не может быть реализован физически, поэтому значение функции приспособленности для этого случая равна нулю и соответствующая особь в дальнейшем исключается из расчетов.
Нарушение "мягких" условиях приводит к ситуации, когда распределение может быть реализован физически, однако задачу по отношению к соответствующему объекту не будет выполнено. Поэтому для таких объектов функция локальной эффективности принудительно устанавливается равной нулю, однако соответствующие особи с дальнейшей эволюции не исключаются и могут выступать родителями для формирования следующего поколения.
Такую регулятивную функцию и выполняет коэффициент kj. Общее количество генов в хромосоме соответствует количеству объектов поражения. Каждый ген содержит значение количества боевых единиц, назначаются на соответствующий объект. Такая структура хромосомы отвечает полиалельному варианта генетического алгоритма (ГА), который и был использован для решения задачи.
Процесс оптимизации заключается в многократном генерировании (по некоторым правилам) вариантов векторов независимых переменных и определении для значений функции приспособленности. За оптимальное решение принимается вектор переменных, которому соответствует наибольшее значение функции среди всех рассчитанных. Для проверки возможности практического использования разработанного подхода в среде программирования была создана серверная программа, которая позволяет решать задачу оптимизации с помощью ГА.
Отбор "отцов" для скрещивания осуществлялся по турнирной схеме с двумя участниками. Формирование следующего поколения осуществлялось по элитной схеме, когда лучший генотип принудительно переносился в следующее поколение. Модификация генотипа осуществлялась с помощью равномерного кроссовера с вероятностью 0,9, мутации с вероятностью 0,95 и инверсии с вероятностью 0,2. Количество особей в популяции составляла 50, а количество поколений - 250. Время расчетов на ЭВМ Intel-166 - 0,57 с. Дополнительная настройка параметров ГА не производилась.
Сравнение результатов расчетов по этим методам свидетельствует, что
использование ГА позволило найти более эффективный вариант распределения, чем
метод динамического программирования (в данном случае, на 1,6%), что
свидетельствует о потенциально высокой вычислительной эффективности ГА.
Заключение
Каждый год появляется множество как универсальных, так и нишевых социальных сервисов и для активных пользователей Интернет типично иметь несколько профилей в различных социальных сетях. Несмотря на то, что существуют попытки по обеспечению единого способа взаимодействия между различными социальными платформами (например, OpenSocial3), они не получили широкого применения, а новые социальные сервисы продолжают появляться. Идентификация пользователя в различных социальных сетях позволяет получить более полную картину о социальном поведении данного пользователя в сети Интернет. Обнаружение аккаунтов, принадлежащих одному человеку, в нескольких социальных сетях, позволяет получить более полный социальный граф, что может быть полезно во многих задачах, таких как информационный поиск, интернет-реклама, рекомендательные системы и т.д.
Поскольку поиск аккаунтов пользователя в различных сетях в общем случае требует наличия актуальных данных обо всех пользователях данных сетей, целесообразно ограничить пространство поиска ближайшими соседями какого-либо пользователя, аккаунты которого в исследуемых сетях известны. Таким образом, задача идентификации пользователей в различных социальных сетях в локальной перспективе подразумевает сопоставление аккаунтов пользователей в рамках списков контактов некоторого центрального пользователя в различных социальных сетях.
Такая задача часто возникает при работе с контактами пользователей в социальных мета- сервисах, которые, в частности, могут служить для объединения новостных потоков в поддерживаемых социальных сервисах или предоставления единой системы обмена сообщениями. Подобная задача возникает также при использовании функции автоматического объединения контактов из различных источников (телефонная книга, социальные сети, мессенджеры), распространённой в современных мобильных устройствах.
Был применен метод решения задачи идентификации пользователей Twitter, что сводится к возможности управления аккаунтом последнего для осуществления активности в виде новых сообщений с привязкой к условиям информационной среды. В рамках данной работы такими условиями являются время и интерес пользователей Twitter к опубликованному сообщению.
Сформулированы актуальные направления дальнейших научных исследований в области разработки ИС и приложений БД.
Разработанное программное обеспечение упрощает взаимодействия менеджера рекламного агентства с социальной сетью Twitter при решении задачи медиапланирования.
Одной из доминирующих тенденций развития социальных сетей как социокультурного феномена является более глубокое понимание особенностей социального поведения человека и, как следствие, создание новых средств для самовыражения, а также обмена информацией и опытом. При этом наличие большого количества корпоративных аккаунтов у одной управляющей компании производит значительную нагрузку на менеджера рекламного агентства ввиду необходимости отслеживания интереса пользователей к публикациям.
Облачные технологии привели к действительно революционных изменений в области информационных технологий и их использования во всех составляющих университетской жизни, развития учебного процесса, научно-технологических проектов, сотрудничества с ИТ-индустрией и индустрией высоких технологий вообще. Ученые, преподаватели, студенты не только успешно изучают и исследуют инструментарий облачных вычислений, но и принимают непосредственное участие в реальных разработках для аэрокосмической, транспортной, энергетической и других критических и коммерческих отраслей, где облачные ИТ-инфраструктуры.
По этой причине в рамках выполнения бакалаврской работы было спроектировано и разработано программное обеспечение, автоматизирующие задачу отслеживания интереса пользователей Twitter к публикуемым сообщениям. Результатом отслеживания является публикация нового сообщения из медиаплана, когда интерес пользователей достигнет минимум один «лайк» в терминологии сети Twitter.
Важно, что эти разработки направлены на совершенствование всех элементов коммерческого процесса, его динамической и рациональной информатизации с использованием частных и корпоративных облачных решений, предоставления образовательных, консалтинговых и инжиниринговых услуг.
В бакалаврской работе получены следующие новые теоретические и практические результаты:
· выполнено построение сигналов для каждого токена (последовательности символов) с использованием информации о частоте его появления в корпусе в различные моменты времени;
· осуществлено применение вейвлетного анализа к полученным сигналам;
· произведено удаление незначительных токенов с использованием автокорреляции сигналов;
· выполняется построение матрицы кросс-корреляции сигналов токенов;
· осуществляется поиск событий как наборов токенов путём кластеризации полученной матрицы;
· выполняется поиск сообщений, описывающих каждое событие, с помощью метода мульти-документного реферирования по документам, содержащим токены из каждого набора.
· программный продукт не требует данных о пользователях и доступа к внешним базам знаний;
· реализована возможность инкрементальной обработки при поступлении новых сообщений по разработанному алгоритму.
Если же веса ребер могут быть отрицательными, то необходимо применять алгоритм Беллмана-Форда, время работы которого О (nm). Если необходимо найти расстояния между всеми парами вершин графа, граф является разряженным и все ребра имеют неотъемлемые веса, то можно выполнить n раз алгоритм Дейкстры.
Если же граф является разряженным, но в нем могут быть ребра с отрицательными весами, то необходимо использовать алгоритм Джонсона. Если необходимо найти расстояния между всеми парами вершин, веса ребер могут быть отрицательными и граф не является разряженным (m стремится к n2), то необходимо использовать алгоритм Флойда-Уоршола.
Ни один из приведенных алгоритмов не может быть применен для графов, которые содержат негативные циклы. Однако алгоритм Беллмана-Форда (как и алгоритм Джонсона), а также алгоритм Флойда-Уоршола могут выявить такие циклы.
Примененные алгоритмы поиска кратчайшего пути используются для эффективного выбора свободного и самого ближайшего сервера передачи и обработки данных.
Разумно ожидать дальнейшего расширения пользовательской модели и функционала социальных сетей, что приведёт к появлению новых типов данных в виде объектов и связей социального графа и, как следствие, возможности более эффективно решать задачи, связанные с обработкой персональной информации.
Сравнение результатов расчетов по этим методам свидетельствует, что использование генетического алгоритма позволило найти более эффективный вариант распределения, чем метод динамического программирования (в данном случае, на 1,6%), что свидетельствует о потенциально высокой вычислительной эффективности генетического алгоритма.
Кроме рассмотренных вопросов, существует несколько научно-технологических задач, требующих решения.