Курсовая работа (т): Исследование проблемы автокорреляции (первого порядка) случайных отклонений с помощью теста Сведа-Эйзенхарта и статистики Дарбина-Уотсона, а также графических методов
Исследование проблемы автокорреляции (первого порядка) случайных отклонений с помощью теста Сведа-Эйзенхарта и статистики Дарбина-Уотсона, а также графических методов
МИНИСТЕРСТВО ОБРАЗОВАНИЯ РЕСПУБЛИКИ БЕЛАРУСЬ
БЕЛОРУССКИЙ ГОСУДАРСТВЕННЫЙ УНИВЕРСИТЕТ
Экономический факультет
Кафедра аналитической экономики и
эконометрики
КУРСОВОЙ ПРОЕКТ
По теме: Исследование проблемы
автокорреляции (первого порядка) случайных отклонений с помощью теста
Сведа-Эйзенхарта и статистики Дарбина-Уотсона, а также графических методов
Студентки 3 курса А.В. Пашкевич
дневного отделения «Международный менеджмент»
Минск, 2013
Содержание
Введение
1. Теоретическое и статистическое обоснование модели
1.1 Теоретическое описание модели
1.2 Статистическое обоснование модели
2. Построение и анализ эконометрической модели
2.1 Статистическая адекватность и проверка модели на мультиколлинеарность
2.2 Исследование автокорреляции графическим методом
2.3 Исследование автокорреляции с помощью статистики Дарбина-Уотсона
2.4 Исследование автокорреляции с помощью теста Сведа-Эйзенхарта
2.5 Исследование модели с помощью теста Бреуша-Годфри и анализ гетероскедастичности
3. Корректировка автокорреляции случайных отклонений
Заключение
Приложение А
Приложение Б
Приложение В
Приложение Г
Приложение Д
Введение
Данный курсовой проект подразумевает под собой построение экономической модели и, в соответствии с темой, её исследование на автокорреляцию первого порядка и коррекцию на основании полученных данных.
Понятие экономической модели, а именно модели множественной линейной регрессии, возникает тогда, когда мы говорим об воздействии нескольких экзогенных факторов (Х ≥ 2) на эндогенную переменную. Под регрессией понимается функциональная зависимость между объясняющими переменными (Х) и условным математическим ожиданием (средним значением) зависимой переменной которая строится с целью предсказания (прогнозирования) этого среднего значения при фиксированных значениях первых.
Целью курсового проекта является выполнение эконометрического моделирования в соответствии с выбранной темой на основании выбранных данных.
В качестве оцениваемых параметров я использовала оборот розничной торговли в текущих ценах под воздействием средней номинальной заработной платы, инвестиций в основной капитал и импорта товаров и услуг.
Выборку производила по временным поквартальным данным с 2004 по 1ый квартал 2013 года. В качестве исследуемой страны я выбрала Россию.
Соответствующие статистические данные представлены в приложении 1.
Для анализа модели будет использоваться эконометрический пакет Eviews. При помощи теста Сведа-Эйзенхарта, статистики Дарбина-Уотсона и графического метода будут проверены остатки построенной модели на наличие автокорреляции.
Итак, первоначальная модель множественной линейной регрессии переменной Y будет основываться на следующих объясняющих переменных X1, X2, Х3:
X1 - IMPORT, импорт товаров и услуг, млрд. руб
X2 - INVEST, инвестиции в основной капитал, млрд (трлн) руб
Х3 - ZP, средняя номинальная зарплата, руб/месяц
Наша зависимая переменнаяY обозначает:
Y - Rozn, оборот розничной торговли в текущих ценах, млрд.руб
Для достижения поставленной цели были поставлены следующие задачи:
построение исходной модели
оценка общего качества регрессии
анализ нарушения предпосылок МНК
выявление автокорреляции при помощи теста Сведа-Эйзенхарта
выявление автокорреляции при помощи статистики Дарбина-Уотсона
выявление автокорреляции при помощи графических методов
корректировка модели
1. Теоретическое и статистическое обоснование модели
.1 Теоретическое описание модели
Практически любой экономический показатель ощущает на себе влияние
нескольких других факторов. Линейная регрессия находит широкое применение в
эконометрике в виде четкой эконометрической интерпретации ее параметров. В
рамках нашей темы, мы будем говорить об множественной линейной регрессии.
Теоретическое линейное уравнение регрессии имеет вид:
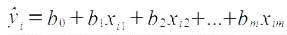
Построение линейной регрессии сводится к оценке ее параметров - b0, b1, b2, bm. Оценки параметров линейной регрессии могут быть найдены разными методами. Классический подход к оцениванию параметров линейной регрессии основан на методе наименьших квадратов (МНК). [1, стр.91-100]
Существует ряд предпосылок относительно случайного отклонения, при выполнении которых по МНК получаются наилучшие результаты.
Предпосылки МНК (условия Гаусса−Маркова):
1.
Математическое ожидание случайного отклонения  равно
нулю:(
 ) = 0
для всех наблюдений.
Данное условие означает, что случайное отклонение в среднем не оказывает влияния на зависимую переменную. В каждом конкретном наблюдении случайный член может быть либо положительным, либо отрицательным, но он не должен иметь систематического смещения.
.
Дисперсия случайных отклонений постоянна:(
 ) = D(
 ) =
 для любых
наблюдений i и j.
Здесь мы говорим о гомоскедастичности отклонений модели (в случае соблюдения предпосылки) или о гетероскедастичности отклонения модели
.
Случайные отклонения и являются
независимыми друг от друга для i ≠ j. Выполнимость данной предпосылки
предполагает, что отсутствует систематическая связь между любыми случайными
отклонениями. Другими словами, величина и определенный знак любого случайного
отклонения не должны быть причинами величины и знака любого другого отклонения.
Поэтому, если данное условие выполняется, то говорят об отсутствии
автокорреляции.
. Случайное отклонение должно быть независимо от объясняющих переменных. Обычно это условие выполняется автоматически при условии, что объясняющие переменные не являются случайными в данной модели. Следует отметить, что выполнимость данной предпосылки не столь критична для эконометрических моделей.
. Модель является линейной относительно параметров.
Рассмотрим подробнее автокорреляцию случайных отклонений как нарушение предпосылки МНК.
Автокорреляция - это взаимосвязь последовательных элементов временного или пространственного ряда данных. В эконометрических исследованиях часто возникают и такие ситуации, когда дисперсия остатков постоянная, но наблюдается их ковариация. Это явление называют автокорреляцией остатков.
Если существует корреляция между последовательными значениями некоторой независимой переменной, то будет наблюдаться и корреляция последовательных значений остатков. Автокорреляция может быть также следствием ошибочной спецификации эконометрической модели. Кроме того, наличие автокорреляции остатков может означать, что необходимо ввести в модель новую независимую переменную.
Автокорреляция остатков может быть вызвана несколькими причинами имеющими различную природу:
) наличие ошибок измерения в значениях результативного признака;
) модель не учитывает несколько второстепенных факторов, совместное влияние которых на результат существенно ввиду совпадения тенденций их изменения или фаз циклических колебаний;
) модель может не включать фактор, оказывающий существенное воздействие на результат, влияние которого отражается в остатках, вследствие чего последние могут оказаться автокоррелированными. Очень часто этим фактором является фактор времени t. Кроме того, в качестве таких существенных факторов могут выступать лаговые значения переменных, включенных в модель;
) неправильная спецификация функциональной формы модели. В этом случае следует изменить форму связи факторных и результативного признаков, изменить переменные, а не использовать специальные методы расчета параметров уравнения регрессии при наличии автокорреляции остатков.[1, с. 228]
Обнаружить автокорреляцию в модели можно различными способами:
.Графический метод;
.Метод рядов Сведа-Эйзенхарта;
.Критерий Дарбина-Уотсона;
.Тест Бреуша-Годфри;
.Графики автокорреляционных функций.
.2 Статистическое обоснование модели
Итак, как уже говорилось ранее, модель множественной линейной регрессии будет содержать следующие переменные:
X1 - IMPORT, импорт товаров и услуг, млрд. руб2 - INVEST, инвестиции в основной капитал, млрд (трлн) руб
Х3 - ZP, средняя номинальная зарплата, руб/месяц
Y - Rozn, оборот розничной торговли в текущих ценах, млрд.руб
Оборот розничной торговли - стоимость товаров, проданных населению за наличный расчет для личного потребления или использования в домашнем хозяйстве. В оборот розничной торговли не включается стоимость товаров, отпущенных из розничной торговой сети юридическим лицам (в том числе организациям социальной сферы, спецпотребителям и т.п.) и индивидуальным предпринимателям, и оборот общественного питания.
Этот показатель формируется под влиянием множества факторов. Главным из них является спрос потребителей, который в свою очередь зависит от изменения доходов населения (показатель ZP). Мы предполагаем, что при увеличении доходов населения соответственно будет наблюдаться и увеличение оборота розничной торговли.
Объем товарооборота должен обосновываться, с одной стороны, спросом, который необходимо прогнозировать, а с другой стороны - должен формироваться с учетом критериев выгодности, так как от него зависят финансовое состояние предприятия и работников.
Поэтому я предполагаю, что инвестиции в основной капитал (показатель INVEST) сыграют положительную роль в создании и воспроизводстве основных средств (новое строительство, расширение, приобретение оборудования и т. д.), а это позволит улучшить качество и объем выпускаемой продукции, что приведет к увеличению оборота розничной торговли.
Я считаю, что влияние импорта товаров и услуг (показатель IMPORT) будет оказывать положительный эффект на оборот розничной торговли, так как с увеличением импорта увеличивается и персональный спрос на предлагаемые товары и услуги.
Итак, на основе данных по России в период с первого квартала 2004 года по первый квартал 2013 года, представленных в Приложении А, мы получаем следующие расчеты в программе Eviews 5 (рис. 1.1):
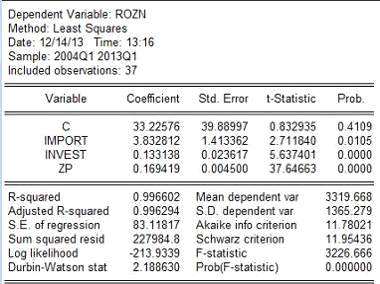
Рисунок 1.1 - Расчеты модели
Примечание - Источник: собственная разработка.
По этим данным строим регрессионную модель и анализируем её впоследствии:
ROZN = 33.23 + 3.83 IMPORT + 0.13 INVEST + 0.17 ZP
автокорреляция регрессия гетероскедастичность
2. Построение и анализ эконометрической модели
2.1 Статистическая адекватность и проверка модели на мультиколлинеарность
Задача состоит в оценке параметров множественной линейной регрессии, а также проверке как индивидуальной статистической значимости коэффициентов, так и общего качества модели.
1. Гипотеза о статистической значимости коэффициента детерминации.
Для характеристики общего качества модели регрессии вводится величина, называемая коэффициент детерминации, равный в нашем случае R2 = 0.996602. Эта величина показывает, какую долю общей вариации эндогенной переменной Rozn объясняет построенная модель. Иными словами, модель объясняет до 99% правильности модели, а 1% составляют ошибки.
Анализ происходит на основе F-статистики, для этого выдвигаются две гипотезы:
Н0: R2= 0 [статистически незначим]
Н1: R2 ≠ 0 [статистически значим]
Вначале определяем наблюдаемую точку:
Fн = (R2/m) / (1- R2/ n-m-1) = 3226.198
Затем сравниваем её с критической: F0.05;3;33 = 2.92. Мы видим, что Fн> Fкр. Эти результаты говорят о том, что мы принимаем гипотезу Н1 о значимости коэффициента.
Однако R2 увеличивается при введении в модель экзогенной переменной, даже если последняя не коррелирует с переменной Rozn ( это показывает коэффициент при ней). Следовательно, необходимо проверить на значимость коэффициенты при объясняющих переменных.
2. Гипотеза о статистической значимости коэффициентов.
Анализ происходит на основе Т-статистики, для этого выдвигаются две
гипотезы:
Н0: bi = 0
Н1: bi ≠ 0
Наши наблюдаемые параметры:
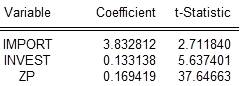
Наша критическая точка высчитывается по таблице распределения Стьюдента:
t 0.025;33= 2.042.
Она больше, чем наблюдаемые t-статистики, следовательно мы принимаем гипотезу Н1 о том, что коэффициенты являются статистически значимыми , а значит, переменные IMPORT, INVEST и ZP влияют на Rozn .
3. Проверка модели на мультиколлинеарность.
Cуществуют некоторые признаки наличия мультиколлинеарности в модели:
1. Коэффициент детерминации R2 высок, все объясняющие переменные в модели значимы, однако коэффициент “с” имеет низкую t-статистику (0.83).
2. Анализ коэффициента корреляции
Таблица 1
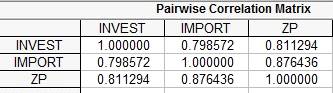
Чем ближе коэффициент к |1|, тем теснее линейная связь. При величине коэффициента корреляции менее 0,3 связь оценивается как слабая, от 0,31 до 0,5 - умеренная, от 0,51 до 0,7 - значительная, от 0,71 до 0,9 - тесная, 0,91 и выше - очень тесная. Как мы видим, связь между переменными тесная.
Один из методов выявления - это метод инфляционных факторов VIF. Вычисляется по формуле:
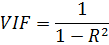 ,
где R2 - коэффициент детерминации вспомогательной модели.
Для этого строятся вспомогательные модели регрессии для каждой экзогенной
переменной на остальные (см. Приложение В) Итак, мы рассчитали, что:
VIF( IMPORT) = 4.77
VIF (INVEST) = 3.24
VIF (ZP) = 5.06
Отсюда можно заключить, что мультиколлинеарность в модели почти не определяется, так как по
разным источникам можно утверждать о её присутствии в модели при VIF >5 или
при VIF >10.