Материал: Математическое и имитационное моделирование проблемно-ориентированных информационных технологий. Проскурин Д.К., Сысоев Д.В
ИНФОРМАЦИОННЫЕ ТЕХНОЛОГИИ В СТРОИТЕЛЬНЫХ, СОЦИАЛЬНЫХ И ЭКОНОМИЧЕСКИХ СИСТЕМАХ
низованные заранее определенным образом |
возможностей, связанных с дисковой подси- |
||||
или не имеющие заранее определенной мо- |
стемой. Горизонтальная модель, которая |
||||
дели данных, которые также свойственны |
присуще большим данным, подразумевает |
||||
большим данным. [3]. |
|
распределение сессий пользователей по раз- |
|||
Еще одним критерием сравнения вы- |
ным серверам, а также распределение дан- |
||||
ступает модель хранения и обработки дан- |
ных по разным серверам базы данных, что |
||||
ных. Вертикальная модель используется в |
обеспечивает высокую производительность |
||||
традиционных базах данных, она предпола- |
системы, при этом не приводя к снижению |
||||
гает наращивание мощности сервера и его |
отказоустойчивости [4]. |
||||
|
|
|
|
Таблица 1 |
|
|
Сравнительный анализ традиционной базы и с Big Data |
||||
|
Характеристика |
Традиционная |
Big Data |
|
|
|
база данных |
|
|||
|
|
|
|
||
|
Объем информации |
От гигабайт до терабайт |
От петабайт до эксабайт |
|
|
|
|
|
|
|
|
|
Структурированность |
|
|
Структурирована, |
|
|
Структурирована |
полу структурирована, |
|
||
|
данных |
|
|||
|
|
|
не структурирована |
|
|
|
|
|
|
|
|
|
Модель хранения |
Вертикальная модель |
Горизонтальная модель |
|
|
|
и обработки данных |
|
|||
|
|
|
|
|
|
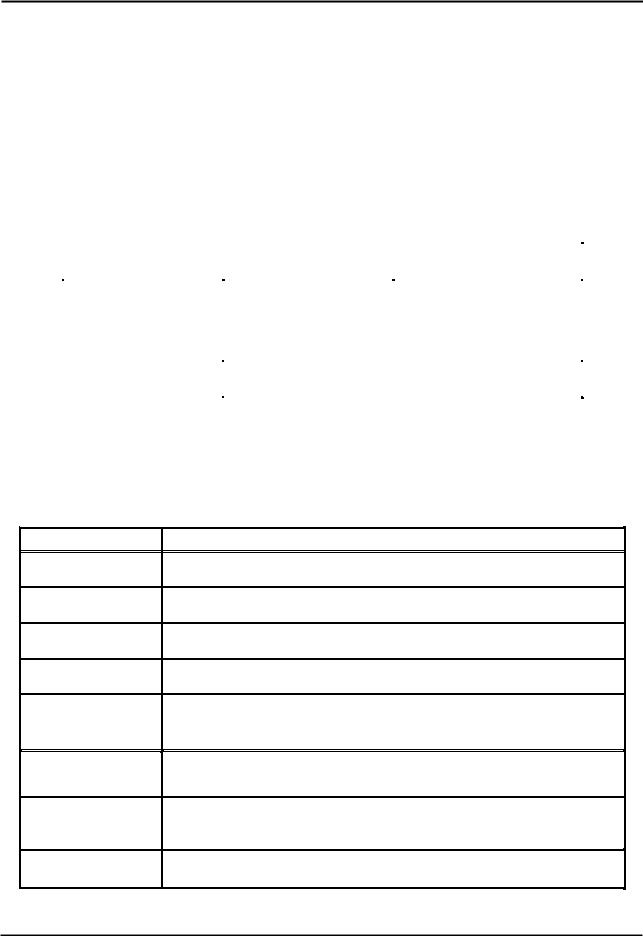
Big data ежегодно захватывают все новые и новые сферы деятельности.
Области использований и возможные
варианты решения тех или иных задач с применением технологий Big data представлены в табл. 2.
Таблица 2
Применение технологий Big Data в различных сферах
Отрасль
Торговля
Банковская отрасль
Медицина
Телекоммуникация
Страхование
Технологии Big Data
Управление поставками товара, хранением и продажей, прогнозирование спроса товара.
Анализ кредитоспособности заемщика и предложение индивидуальных банковских услуг для каждого клиента.
Прогнозирование возможных «волн» заболеваний и сбор данных о пациенте.
Прогнозирование оттока абонента и управление им, подбор выгодных тарифных планов и привлекательных опций
Персонализация страховых полисов, Оценка рисков при формировании страховых тарифов, Предупреждение страховых случаев
Образование
Промышленность
Логистика
Помощь студентам с профориентацией: анализ их способностей и помощь при выборе обучения и будущей профессии
Определение условий, при которых чаще всего происходит брак изделий и затрачивается больше всего времени, Оптимизация работы на отдельных этапах
Планирование маршрута и времени доставки для избегания простоев транспорта
50
ВЫПУСК № 3 (21), 2020 |
ISSN 2618-7167 |
В современном мире предприятиям необходимо обрабатывать большие объемы неструктурированных данных различного типа: текст, аудио, видео, изображение, где информация часто обновляется и поступает из разных источников. Именно технологии больших данных позволяют хранить, структурировать, выявлять ценную и нужную информацию и использовать полученные данные при принятии каких-либо решений.
По прогнозам аналитической компании IDC, к 2025 году общемировой объем данных вырастет в 10 раз и достигнет 163 зеттабайт [5].
Поэтому можно предположить, что в связи с увеличением объема информации, традиционные базы данных почти полностью будут заменены Big Data, поскольку они позволяют извлекать необходимую информацию из огромного массива данных за максимально короткие сроки и принимать эффективные управленческие решения.
Если несколько лет назад технологии анализа Big Data были актуальны в основном только для крупных компаний, обладавших техническими и финансовыми возможностями наладить сложную систему работы с большими данными, то уже сегодня техно-
логии больших данных становятся доступными представителям среднего и малого бизнеса.
Таким образом, несмотря на определенные сложности, технологии Big data являются одним современных трендов развития информационных технологий.
Библиографический список
1.Парамонов И.Ю., Смагин В.А., Косых Н.Е., Хомоненко А.Д.: Методы и модели исследования сложных систем и обработки больших данных: монография / В.А.Смагн, Н.Е. Хомонен-
ко. – СПб.: ЛАНЬ, 2020. –236 с.
2.Советов Б.Я., Цехановский В.В.: Информационные технологии: теоретические основы: учебное пособие. – 2-е изд. – СПб.: ЛАНЬ,
2017. – 448 с.
3.Москивитин А.А: Данные, информация, знания: методология, теория, технологии: Моно-
графия. – СПб.: ЛАНЬ, 2019. – 236с.
4.Вейцман В.М. Проектирование информационных систем: учебное пособие / В.М. Вейцман. – СПб: Лань, 2019. –316 с.
5.Сайт «Forbes»: Будущее Big Data: к 2025 году 60% мировых данных будет создавать бизнес. URL: https://www.forbes.ru /tehnologii /341869-budushchee-big-data-k-2025-godu-60- mirovyh-dannyh-budet-sozdavat-biznes
Информация об авторах |
Information about the authors |
Марданова Алия Марсовна – магистрант, Казанский государ- |
Aliya M. Mardanova, master's student, Kazan state power engineering |
ственный энергетический университет (420066, Россия, г. Казань, |
University (420066, Russia, Kazan, Krasnoselskaya str. 51), |
ул. Красносельская 51), тел.: 8-843-519-4264 |
ph.: 8-843-519-4264 |
Будникова Иветта Константиновна – кандидат технических наук, |
Ivetta K. Budnikova, candidate of technical Sciences, associate Profes- |
доцент кафедры инженерной кибернетики, Казанский государ- |
sor of the Department of engineering Cybernetics, Kazan state power |
ственный энергетический университет (420066, Россия, г. Казань, |
engineering University ( 420066, Russia, Kazan, Krasnoselskaya str. 51), |
ул. Красносельская 51), е-mail: AliyMsm@mail.ru |
e-mail: AliyMsm@mail.ru |
51
ИНФОРМАЦИОННЫЕ ТЕХНОЛОГИИ В СТРОИТЕЛЬНЫХ, СОЦИАЛЬНЫХ И ЭКОНОМИЧЕСКИХ СИСТЕМАХ
УДК 004
ПРОГРАММНЫЙ ПРОЕКТ ПО СИНТАКСИЧЕСКОМУ АНАЛИЗУ ТЕКСТОВЫХ ФАЙЛОВ СРЕДСТВАМИ ЯЗЫКА С++
М.А. Семенов, Р.С. Зарипова
Казанский государственный энергетический университет
Аннотация: в статье рассматриваются алгоритмические приѐмы поиска и извлечения необходимой информации из текстового файла средствами строковых функций на языке С++. Предложенный алгоритм позволяет эффективно выбрать из текста на русском языке слова, начинающиеся и заканчивающиеся на одну букву. При построении проекта использованы методы работы с символьными динамическими массивами, а также методы передачи массивов в функции как по ссылке, так с помощью указателя. Подобные алгоритмы могут найти применения в рамках различного рода анализа текстовых файлов, в частности при шифровании и дешифровании
Ключевые слова: анализ текстов, поиск слов, извлечение информации, вывод на консоль, CodeBlocks, C++
PROGRAM PROJECT ON SYNTACTIC ANALYSIS OF TEXT FILES
BY MEANS OF C++ LANGUAGE
M.A. Semenov, R.S. Zaripova
Kazan State Power Engineering University
Abstract: the paper deals with algorithmic methods of searching and extracting necessary information from text file by means of string functions in C++ language. The proposed algorithm allows to effectively select words starting and ending with one letter from the text in Russian. Methods of work with symbolic dynamic arrays as well as methods of arrays transfer into functions by reference and pointer are used at project construction. Such algorithms may find applications within various types of text file analysis, in particular, at encryption and decoding
Keywords: text analysis, word search, information extraction, console output, CodeBlocks, C++
Рассмотрим 14 методы алгоритмизации и обоснуем их применение на основе контрольного примера. Первый этап работы – это составление контрольного примера и формирование основных этапов алгоритма. Это позволит пошагово рассмотреть, как работает программа, и какие действия она совершает при обработке входных данных.
Текст контрольного примера следующий: «Поп музыка – единственный жанр, который не любит мой отец». Этот текст содержится в файле ―1.txt‖, который должен быть предварительно помещѐн в директорию, где находится исполняемый файл.
При данном вводе, программа выведет в консоль следующий текст:
"Ваш файл содержит в себе следующий текст:
"Поп музыка – единственный жанр, который не любит мой отец"
© Семенов М.А., Зарипова Р.С., 2020
Подходящих слов: 2 Слова на букву д: дед, 1 шт.
Слова на букву п: Поп, 1 шт."
Этот конкретный пример содержит в себе искомые слова, но если на вход программы поступит текст, в котором их не будет, в консоль будет выведено следующее сообщение:
"Слов, начинающихся и заканчивающихся на одну букву, нет!"
Входные данные берутся из текстового файла, поэтому для реализации программы будут применены методы работы с файлами *.txt. Так же будут использованы методы ввода/вывода для работы с консолью. Хранение данных в процессе выполнения алгоритма будет осуществляться с помощью массивов, а для непосредственной работы с ними будут использованы циклические методы.
Один из требований к программе является подсчѐт количества искомых слов. Для
52
ВЫПУСК № 3 (21), 2020 |
ISSN 2618-7167 |
этого в программе будет введѐн счѐтчик. Са- |
На основании второго массива форми- |
ма программа состоит из 3 основных функ- |
руется вывод. Это происходит путѐм цикли- |
ций, параметры в которые передаются с по- |
ческого вывода на окно консоли следующих |
мощью указателей. |
данных: буквы, количества слов, начинаю- |
Ввод и вывод всех данных осуществля- |
щихся и заканчивающихся на неѐ и списка |
ется с консоли. Формально входные и вы- |
этих слов. После того, как все слова обрабо- |
ходные данные можно описать следующим |
таны, программа завершается. |
образом: |
Проанализируем результаты работы |
Входные данные: текстовый файл, ко- |
программы. Отладка производилась путѐм |
торый считывает в переменную s. |
проверки качества выполнения заявленных |
Выходные данные: комментарии ком- |
функций. |
пьютера в зависимости от ситуации. |
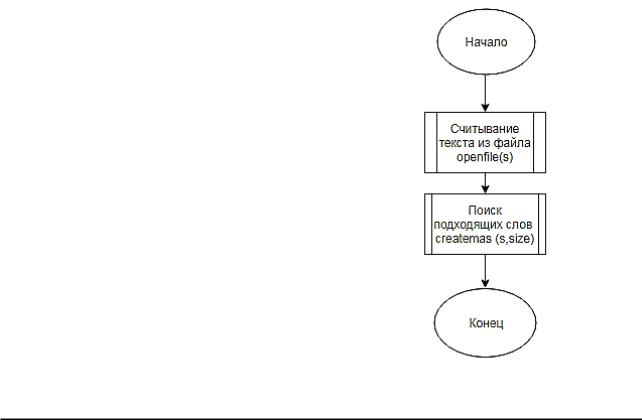
Главная функция представлена на |
Для реализации программы был ис- |
блок-схеме (рис. 1). |
пользован язык программирования C++ [1]. |
Она отображает все основные этапы |
Программа написана в среде разработки |
работы. В ней использованы функции open- |
CodeBlocks 17.12. |
file и createmas. Openfile принимает пере- |
Оформление программы и сопровож- |
менную s. Она считывает данные из файла и |
дающих блок-схем удовлетворяет всем тре- |
записывает их в переменную. Createmas – это |
бованиям ЕСПД. |
основная функция, которая непосредственно |
Рассмотрим алгоритм работы програм- |
формирует массивы, оформляет вывод и ре- |
мы. После запуска программа сразу же от- |
ализует все основные этапы описанного вы- |
крывает файл для чтения. Данные, содержа- |
ше алгоритма. Она использует функцию let- |
щиеся в нѐм, считываются в переменную. |
tercount для подсчѐта слов на конкретную |
Чтобы пользователь понимал, с каким тек- |
букву. |
стом идѐт работа, данные на этом этапе вы- |
|
водятся на окно консоли. После этого файл |
|
закрывается. |
|
Для обеспечения работы самой про- |
|
граммы создаются два массива. Первый бу- |
|
дет хранить считанный текст, второй нужен |
|
для работы с искомыми словами. Далее зна- |
|
чение переменной, в которую был помещѐн |
|
входной текст, считывается в первый массив. |
|
На данном этапе он состоит из отдельных |
|
символов текста. После этого он разделяется |
|
на лексемы – из символов формируются |
|
полноценные слова, и теперь они будут эле- |
|
ментами массива. |
|
Следующий этап – работа с массивом |
|
слов. В нѐм происходит поиск удовлетворя- |
|
ющих заданию слов путѐм сравнения первой |
|
и последней буквы каждого элемента. Под- |
|
ходящие слова подсчитываются с помощью |
|
счѐтчика и заносятся во второй массив. |
Рис. 1. Блок-схема главной функции |
|
53
ИНФОРМАЦИОННЫЕ ТЕХНОЛОГИИ В СТРОИТЕЛЬНЫХ, СОЦИАЛЬНЫХ И ЭКОНОМИЧЕСКИХ СИСТЕМАХ
Данная работа описывает программу, |
|
Библиографический список |
позволяющую находить в текстовом файле |
|
1. Кривоногова А.Е., Зарипова Р.С. Выбор |
слова начинающиеся и заканчивающиеся на |
|
|
|
языка программирования при обучении инжене- |
|
|
|
|
определѐнную букву и выводить их на кон- |
|
ров / Приборостроение и автоматизированный |
соль. Для этого был разработан алгоритм, |
|
электропривод в топливно-энергетическом ком- |
использующий приемы структурного про- |
|
плексе и жилищно-коммунальном хозяйстве. ма- |
граммирования, в частности, разбиение зада- |
|
териалы IV Национальной научно - практиче- |
чи на 3 функции. Алгоритм визуализирован |
|
ской конференции. Казанский государственный |
словесно-блочной схемой, разработан кон- |
|
энергетический университет. 2019. С. 532-534. |
|
2. Ишмуратов Р.А., Зарипова Р.С. Роль и |
|
трольный пример. Результаты работы про- |
|
|
|
место программных приложений в процессе обу- |
|
шли проверку на полноту программы. Про- |
|
|
|
чения студентов // Состояние и перспективы раз- |
|
грамма работает корректно. Оформление |
|
|
|
вития ИТ - образования: Сборник докладов и |
|
программы и сопровождающей блок-схемы |
|
|
|
научных статей Всероссийской научно - практи- |
|
удовлетворяет всем требованиям Единой си- |
|
|
|
ческой конференции. 2018. С. 320-323. |
|
|
|
|
стеме программной продукции [2]. |
|
|
Информация об авторах |
|
Information about the authors |
|
||
Семенов Максим Андреевич – студент, Казанский государствен- |
|
Maksim A. Semenov, student, Kazan State Power Engineering Univer- |
ный энергетический университет (420066, Россия, г. Казань, ул. |
|
sity (Krasnoselskaya str., Kazan, 420066, Russia), ph.: 8-843-519-4264 |
Красносельская, 51), тел.: 8-843-519-4264 |
|
Rimma S. Zaripova, candidate of technical Sciences, associate Profes- |
Зарипова Римма Солтановна – кандидат технических наук, до- |
|
sor, Kazan State Power Engineering University (Krasnoselskaya str., |
цент, Казанский государственный энергетический университет |
|
Kazan, 420066, Russia), e-mail: zarim@rambler.ru |
(420066, Россия, г. Казань, ул. Красносельская, 51), |
|
|
e-mail: zarim@rambler.ru |
|
|
54