Материал: Методические указания по выполнению лабораторных работ № 9-11 по дисциплине «Системное программное обеспечение». Кремер О.Б
Принципы организации таблиц идентификаторов
Компилятор пополняет записи в таблице идентификаторов по мере анализа исходной программы и обнаружения в ней новых элементов, требующих размещения в таблице. Поиск информации в таблице выполняется всякий раз, когда компилятору необходимы сведения о том или ином элементе программы. Причем следует заметить, что поиск элемента в таблице будет выполняться компилятором существенно чаще, чем помещение в нее новых элементов. Так происходит потому, что описания новых элементов в исходной программе, как правило, встречаются гораздо реже, чем эти элементы используются. Кроме того, каждому добавлению элемента в таблицу идентификаторов в любом случае будет предшествовать операция поиска - чтобы убедиться, что такого элемента в таблице нет.
На каждую операцию поиска элемента в таблице компилятор будет затрачивать время, и поскольку количество элементов в исходной программе велико (от единиц до сотен тысяч в зависимости от объема программы), это время будет существенно влиять на общее время компиляции. Поэтому таблицы идентификаторов должны быть организованы таким образом, чтобы компилятор имел возможность максимально быстро выполнять поиск нужной ему записи таблицы по имени элемента, с которым связана эта запись.
Можно выделить следующие способы организации таблиц идентификаторов:
простые и упорядоченные списки;
бинарное дерево;
хэш-адресация с рехэшированием;
хэш-адресация по методу цепочек;
комбинация хэш-адресации со списком или бинарным деревом.
Простейшие методы построения таблиц идентификаторов
В простейшем случае таблица идентификаторов представляет собой линейный неупорядоченный список, или массив, каждая ячейка которого содержит данные о соответствующем элементе таблицы. Размещение новых элементов в такой таблице выполняется путем записи информации в очередную ячейку массива или списка по мере обнаружения новых элементов в исходной программе.
Поиск нужного элемента в таблице будет в этом случае выполняться путем последовательного перебора всех элементов и сравнения их имени с именем искомого элемента, пока не будет найден элемент с таким же именем. Тогда если за единицу времени принять время, затрачиваемое компилятором на сравнение двух строк (в современных вычислительных системах такое сравнение чаще всего выполняется одной командой), то для таблицы, содержащей N элементов, в среднем будет выполнено N/2 сравнений.
Время, требуемое на добавление нового элемента в таблицу (Tд), не зависит от числа элементов в таблице (N). Но если N велико, то поиск потребует значительных затрат времени. Время поиска (Tп) в такой таблице можно оценить как Тп = O(N). Поскольку именно поиск в таблице идентификаторов является наиболее часто выполняемой компилятором операцией, такой способ организации таблиц идентификаторов является неэффективным. Он применим только для самых простых компиляторов, работающих с небольшими программами.
Поиск может быть выполнен более эффективно, если элементы таблицы отсортированы (упорядочены) естественным образом. Поскольку поиск осуществляется по имени, наиболее естественным решением будет расположить элементы таблицы в прямом или обратном алфавитном порядке. Эффективным методом поиска в упорядоченном списке из N элементов является бинарный, или логарифмический, поиск.
Алгоритм логарифмического поиска заключается в следующем: искомый символ сравнивается с элементом (N+ 1)/2 в середине таблицы; если этот элемент не является искомым, то мы должны просмотреть только блок элементов, пронумерованных от 1 до (N + 1)/2 - 1, или блок элементов от (N + 1)/2 + 1 до N в зависимости от того, меньше или больше искомый элемент того, с которым его сравнили. Затем процесс повторяется над нужным блоком в два раза меньшего размера. Так продолжается до тех пор, пока либо искомый элемент не будет найден, либо алгоритм не дойдет до очередного блока, содержащего один или два элемента (с которыми можно выполнить прямое сравнение искомого элемента).
Так как на каждом шаге число элементов, которые могут содержать искомый элемент, сокращается в два раза, максимальное число сравнений равно 1 + log2 N. Тогда время поиска элемента в таблице идентификаторов можно оценить как Тп = O(log2 N). Для сравнения: при N = 128 бинарный поиск требует самое большее 8 сравнений, а поиск в неупорядоченной таблице — в среднем 64 сравнения. Метод называют «бинарным поиском», поскольку на каждом шаге объем рассматриваемой информации сокращается в два раза, а «логарифмическим» — поскольку время, затрачиваемое на поиск нужного элемента в массиве, имеет логарифмическую зависимость от общего количества элементов в нем.
Недостатком логарифмического поиска является требование упорядочивания таблицы идентификаторов. Так как массив информации, в котором выполняется поиск, должен быть упорядочен, время его заполнения уже будет зависеть от числа элементов в массиве. Таблица идентификаторов зачастую просматривается компилятором еще до того, как она заполнена, поэтому требуется, чтобы условие упорядоченности выполнялось на всех этапах обращения к ней. Следовательно, для построения такой таблицы можно пользоваться только алгоритмом прямого упорядоченного включения элементов.
Если пользоваться стандартными алгоритмами, применяемыми для организации упорядоченных массивов данных, то среднее время, необходимое на помещение всех элементов в таблицу, можно оценить следующим образом:
Tд = O (N * log2 N) + k * O (N2)
Здесь k - некоторый коэффициент, отражающий соотношение между временами, затрачиваемыми компьютером на выполнение операции сравнения и операции переноса данных.
При организации логарифмического поиска в таблице идентификаторов обеспечивается существенное сокращение времени поиска нужного элемента за счет увеличения времени на помещение нового элемента в таблицу. Поскольку добавление новых элементов в таблицу идентификаторов происходит существенно реже, чем обращение к ним, этот метод следует признать более эффективным, чем метод организации неупорядоченной таблицы. Однако в реальных компиляторах этот метод непосредственно также используется редко, поскольку существуют более эффективные методы.
Построение таблиц идентификаторов по методу бинарного дерева
Можно сократить время поиска искомого элемента в таблице идентификаторов, не увеличивая значительно время, необходимое на ее заполнение. Для этого надо отказаться от организации таблицы в виде непрерывного массива данных. Существует метод построения таблиц, при котором таблица имеет форму бинарного дерева. Каждый узел дерева представляет собой элемент таблицы, причем корневым узлом становится первый элемент, встреченный компилятором при заполнении таблицы. Дерево называется бинарным, так как каждая вершина в нем может иметь не более двух ветвей. Для определенности будем называть две ветви «правая» и «левая».
Рассмотрим алгоритм заполнения бинарного дерева. Будем считать, что алгоритм работает с потоком входных данных, содержащим идентификаторы. Первый идентификатор, как уже было сказано, помещается в вершину дерева. Все дальнейшие идентификаторы попадают в дерево по следующему алгоритму:
1. Выбрать очередной идентификатор из входного потока данных. Если очередного идентификатора нет, то построение дерева закончено.
2. Сделать текущим узлом дерева корневую вершину.
3. Сравнить имя очередного идентификатора с именем идентификатора, содержащегося в текущем узле дерева.
4. Если имя очередного идентификатора меньше, то перейти к шагу 5, если равно — прекратить выполнение алгоритма (двух одинаковых идентификаторов быть не должно!), иначе — перейти к шагу 7.
5. Если у текущего узла существует левая вершина, то сделать ее текущим узлом и вернуться к шагу 3, иначе — перейти к шагу 6.
6. Создать новую вершину, поместить в нее информацию об очередном идентификаторе, сделать эту новую вершину левой вершиной текущего узла и вернуться к шагу 1.
7. Если у текущего узла существует правая вершина, то сделать ее текущим узлом и вернуться к шагу 3, иначе — перейти к шагу 8.
18. Создать новую вершину, поместить в нее информацию об очередном идентификаторе, сделать эту новую вершину правой вершиной текущего узла и вернуться к шагу 1. Рассмотрим в качестве примера последовательность идентификаторов GA, Dl, M22, Е, А12, ВС, F. На рисунке 1 проиллюстрирован весь процесс построения бинарного дерева для этой последовательности идентификаторов.
Поиск элемента в дереве выполняется по алгоритму, схожему с алгоритмом заполнения дерева:
1. Сделать текущим узлом дерева корневую вершину.
2. Сравнить имя искомого идентификатора с именем идентификатора, содержащимся в текущем узле дерева.
3. Если имена совпадают, то искомый идентификатор найден, алгоритм завершается, иначе надо перейти к шагу 4.
4. Если имя очередного идентификатора меньше, то перейти к шагу 5, иначе — перейти к шагу 6.
5. Если у текущего узла существует левая вершина, то сделать ее текущим узлом и вернуться к шагу 2, иначе — искомый идентификатор не найден, алгоритм завершается.
6. Если у текущего узла существует правая вершина, то сделать ее текущим узлом и вернуться к шагу 2, иначе — искомый идентификатор не найден, алгоритм завершается.
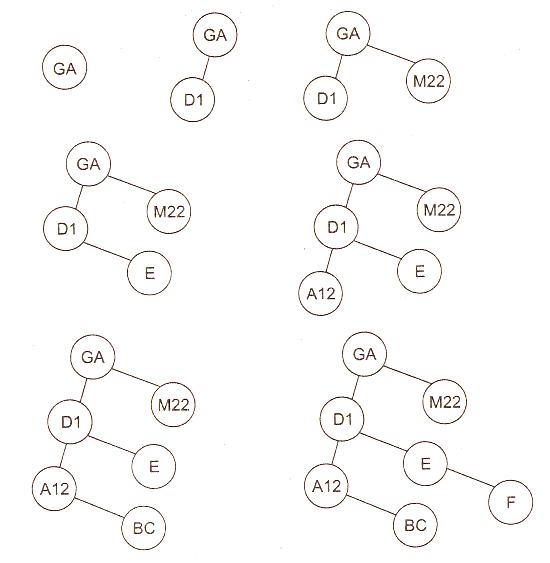
Заполнение бинарного дерева для последовательности идентификаторов GA, D1, М22, Е, А12, ВС, F
Для данного метода число требуемых сравнений и форма получившегося дерева зависят от того порядка, в котором поступают идентификаторы. Например, если в рассмотренном выше примере вместо последовательности идентификаторов GA, D1, М22, Е, А12, ВС, F взять последовательность А12, ВС, D1, Е, F, GA, M22, то дерево выродится в упорядоченный однонаправленный связный список. Эта особенность является недостатком данного метода организации таблиц идентификаторов. Другими недостатками метода являются: необходимость хранить две дополнительные ссылки на левую и правую ветви в каждом элементе дерева и работа с динамическим выделением памяти при построении дерева.
Порядок выполнения работы
Требуется разработать программу, которая может обеспечить сравнение двух способов организации таблицы идентификаторов с помощью выбранных методов.
Программа должна считывать идентификаторы из входного файла, размещать их в таблицах с помощью заданных методов и выполнять поиск указанных идентификаторов по требованию пользователя.
В процессе размещения и поиска идентификаторов в таблицах программа должна подсчитывать среднее число выполненных операций сравнения для сопоставления эффективности используемых методов.
Программа должна обеспечивать работу не менее чем с 200 идентификаторами, допустимая длина идентификатора должна быть не более 32 символов.
Отчет по лабораторной работе должен содержать следующие разделы:
задание по лабораторной работе;
описание выбранных способов поиска;
схемы организации таблиц идентификаторов;
описание алгоритмов поиска в таблицах идентификаторов;
текст программы;
результаты обработки заданного набора идентификаторов (входного файла) с помощью методов организации таблиц идентификаторов;
анализ эффективности используемых методов организации таблиц идентификаторов и выводы по проделанной работе.
Основные контрольные вопросы
Что такое трансляция, компиляция, транслятор, компилятор?
Что входит в таблицу идентификаторов?
ЛАБОРАТОРНАЯ РАБОТА № 11
ПРОЕКТИРОВАНИЕ ЛЕКСИЧЕСКОГО АНАЛИЗАТОРА
Цель работы: изучение основных понятий теории регулярных грамматик, ознакомление с назначением и принципами работы лексических анализаторов (сканеров), получение практических навыков построения сканера на примере заданного простейшего входного языка.
Краткие теоретические сведения
Лексический анализатор (или сканер) - это часть компилятора, которая читает литеры программы на исходном языке и строит из них слова (лексемы) исходного языка. На вход лексического анализатора поступает текст исходной программы, а выходная информация передается для дальнейшей обработки компилятором на этапе синтаксического анализа и разбора.
Функции, выполняемые лексическим анализатором, и состав лексем, которые он выделяет в тексте исходной программы, могут меняться в зависимости от версии компилятора. В основном лексические анализаторы выполняют исключение из текста исходной программы комментариев и незначащих пробелов, а также выделение лексем следующих типов: идентификаторов, строковых, символьных и числовых констант, ключевых (служебных) слов входного языка.
Пример фрагмента текста программы на языке Паскаль и соответствующей ему таблицы лексем:
...
begin
for i:=1 to N do
fg := fg * 0.5;
...
Лексемы программы
Лексема |
Тип лексемы |
Значение |
begin |
Ключевое слово |
X1 |
for |
Ключевое слово |
X2 |
i |
Идентификатор |
i : 1 |
:= |
Знак присваивания |
S1 |
1 |
Целочисленная константа |
1 |
to |
Ключевое слово |
X3 |
N |
Идентификатор |
N : 2 |
Если предположить, что последовательность идентификаторов в исходной программе является статистически неупорядоченной (что в целом соответствует действительности), то можно считать, что построенное бинарное дерево будет невырожденным. Тогда среднее время на заполнение дерева (Tд) и на поиск элемента в нем (Tп) можно оценить следующим образом:
Tд = N * O(log2 N)
Tп = O( log2 N)
Несмотря на указанные недостатки, метод бинарного дерева является довольно удачным механизмом для организации таблиц идентификаторов. Он нашел свое применение в ряде компиляторов. Иногда компиляторы строят несколько различных деревьев для идентификаторов разных типов и разной длины.