Дипломная (вкр): Методы и алгоритмы семантического поиска информации в системах поддержки пользователей
Методы и алгоритмы семантического поиска информации в системах поддержки пользователей
Содержание
Введение
. Семантический поиск информации в интернет-ориентированных системах поддержки пользователей
.1 Системы семантического поиска информации
.1.1 Система ABBY Compreno
.1.2 Система Exactus
.1.3 Поисковый алгоритм «Королёв»
.1.4 Система IBM Watson
.1.5 Система Inbenta
.2 Методы семантического поиска информации в области интернет ресурсов
.3 Метод семантической обработки информации на основе интенсиональной логики
.4 Постановка задач научно-квалификационной работы
. Расширение метода семантической обработки информации на основе интенсиональной логики в предметной области систем поддержки пользователей
.1 Формально-математические основания метода анализа предложений на естественном языке
.2 Модернизация метода интенсиональной логики для систем поддержки пользователей
.2.1 Построение дерева предложения для последующего семантического анализа и выделения сущностей
.2.2 Перевод вопроса на естественном языке в формулу формальной семантики
.2.3 Адаптация алгоритма поиска для текстов на русском языке
. Модели и алгоритмы семантического поиска в мультиагентной системе поддержки пользователей
.1 Модель мультиагентной системы семантического поиска информации в системе FAQ
.2 Алгоритм заполнения базы знаний ответов
.3 Алгоритм поиска наибольшего семантического веса ответа
. Экспериментальное исследование прототипа системы технической поддержки пользователей на основе семантического поиска ответов на вопросы
.1 Архитектура системы
.2 Программная реализация экспериментального прототипа
.3 Экспериментальные оценки релевантности и пертинентности запросов
Список источников
Введение
В настоящее время все большую актуальность приобретает проблема обработки и извлечения знаний из больших объемов информации. Несмотря на то, что в глобальной сети Интернет содержится огромное количество данных, далеко не всегда их можно использовать. Даже пользователь, приходящий на конкретный сайт, часто не может найти нужную ему информацию. Тогда мы получаем парадоксальную ситуацию, что нужная информация есть, но воспользоваться ей нельзя.
Попытки решить эту проблему предпринимались и предпринимаются уже достаточно давно. Разные фирмы занимаются обработкой естественно-языковых текстов с разной степенью успешности. Такие гиганты Интернета как Google или Яндекс использую наработки в области обработки естественных языков для обработки поисковых запросов. Но все еще, большую роль при поиске играют алгоритмы, основанные на статистике и частоте употребления слов.
Есть две причины, по которым смысловое содержание текста редко участвует в поиске. Первая - существующие алгоритмы поиска по смыслу несовершенны и сложны в реализации. Вторая - поиск практически всегда должен вестись в рамках какой-то предметной области, которая определяет смысловое содержание. Таким образом, для того, чтобы сделать качественный поиск, требуется большое количество дополнительных сведений о рассматриваемой области, которые сложно получить по одному поисковому запросу, не зная дополнительных сведений. Но, несмотря на это, попытки формализовать текст на естественном языке и определить его смысловое содержание ведутся.
Один из подходов к формализации естественно-языковых текстов предложил американский математик и философ Ричард Монтегю. Он сделал предположение о том, что естественный язык можно описать с помощью стандартных средств математической логики. В итоге ему удалось доказать , что данное предположение применительно к английскому языку.
В представленном исследовании рассказывается о предложенной Монтегю
концепции формальной семантики и о том, как требуется её доработать для текстов
на русском языке. В качестве примера для практической реализации взята область
ответов на вопросы пользователей в системах поддержки клиентов.
1. Семантический поиск информации в интернет-ориентированных системах
поддержки пользователей
.1 Системы семантического поиска информации
.1.1 Система ABBYY Compreno
Система Compreno способна проводить достаточно
глубокий анализ текста. Она проводит полный лексический и семантический анализы
текста, что позволяет с достаточно высокой точностью искать и извлекать из
текста нужную информацию. Применяется для больших информационных систем и
внешних источников. Этапы работы представлены на рис.1.
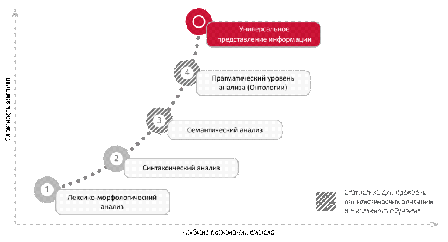
Рисунок 1 - Этапы работы ABBYY Compreno
Основным преимуществом системы является семантический анализ текста.
Система может извлекать из текста данные, отвечающие запросу. По большей части
разработка ABBYY направлена на работу с корпоративными хранилищами для анализа
хранящихся там документов, но она также может использоваться и для анализа
страниц в интернете.
.1.2 Система Exactus
Exactus - это интеллектуальная поисковая система для поиска документов в сети Интернет. Она работает на высокопроизводительной кластерной установке с операционной системой Unix. Архитектура системы создана таким образом, что её мощности можно постоянно наращивать путем добавления дополнительных вычислительных модулей. При этом нагрузка будет балансироваться менеджером распределенных вычислений, который использует виртуальную параллельную машину (PVM). Система реализована на языке C++ и ее можно запускать на большом количестве Unix-подобных операционных систем.
Преимущества Exactus:
- Лингвистическая обработка текста (включает в себя морфологический, синтаксический и семантический анализ)
- Обработка естественно-языковых текстовых запросов
- Расширение механизма поиска по ключевым словам
Работа с данными из самых разнообразных источников
- Автоматическое подключение этих источников
Использование параллельных вычислений
Схема обработки поисковых запросов в системе Exactus представлена на рис. 2.
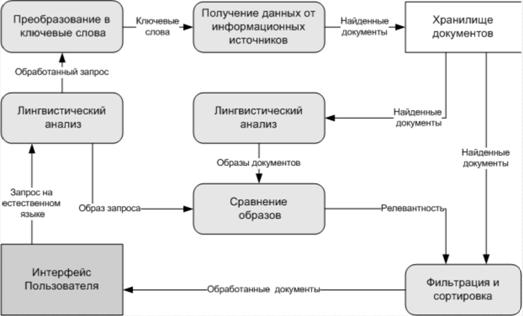
Рисунок 2 Схема обработки поисковых запросов в системе Exactus
Сильной стороной системы Exactus
является качественная интеллектуальная обработка текста. Документы проходят
многоуровневый лингвистический анализ и в структурированном виде сохраняются в
хранилище документов, что в будущем облегчает их поиск.
.1.3 Поисковый алгоритм «Королёв»
В 2017 году Yandex запустил
новый поисковый алгоритм «Королёв». Этот поисковый механизм основывается на
предыдущем алгоритме, который назывался «Палех»[1]. Особенность механизма
поиска состоит в том, что при поиске учитывает смысловое содержание фразы. В
основе алгоритма лежит нейронная сеть, которая сопоставляет смысл поискового
запроса и найденный документ. На рис. 3 представлен график частотного
распределения запросов в Яндексе в виде птицы, у которой есть клюв, туловище и
хвост. «Клюв» - это самые частые запросы, которые задают много, но их
разнообразие не так велико. «Туловище» - запросы средней частотности. «Хвост» -
разнообразные запросы, которые редко повторяются, но разнообразие которых
велико - за счет этого они набирают достаточно большой процент массы от
количества всех запросов.
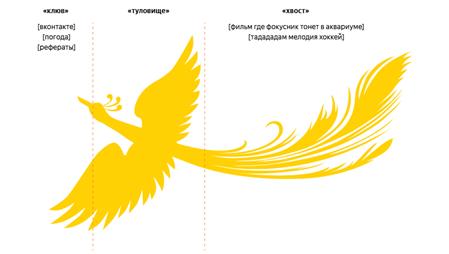
Рисунок 3 - График частотного распределения запросов в «Яндексе»
В ходе работы поискового механизма берутся близкие по содержанию запрос
пользователя и найденный заголовок документа. После этого, производится их
скалярное произведение. Чем больше их скалярное произведение - тем релевантнее
результат поиска поисковому запросу. У «Яндекса» в распоряжении есть огромные
данные поисковых запросов, на основе которых они обучают нейронную сеть таким
образом, чтобы для тестов с похожими смыслами она генерировала похожие вектора,
а для текстов с разными смыслами - разные.
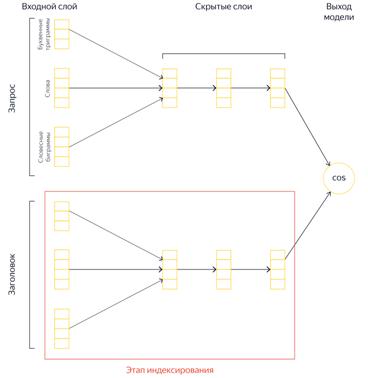
Рисунок 4 - Схема работы алгоритма «Королёв»
Безусловно, механизм поиска, разрабатываемый в «Яндексе» является
перспективным - и самое главное, что этот механизм может дорабатываться и
улучшаться на основе миллионов запросов, которые поступают к нему для
обработки.
.1.4 Система IBM Watson
Одной из систем, занимающихся поиском и анализом контента на естественном языке, а также поиском ответов на вопросы, является IBM Watson. Это система, которая разрабатывается компанией IBM уже на протяжении 15 лет, в которую постоянно вносятся доработки.
Основой IBM Watson является технология DeepQA, которая основана на
статистическом подходе в компьютерной лингвистике. Общий алгоритм работы
системы представлен на рис. 5. Также одной из особенностей системы является -
то, что в качестве базы знаний в ней используется “Википедия”.
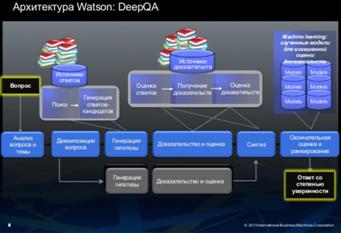
Рисунок 5 - Механизм DeepQA
К преимуществам системы можно отнести ее широкий охват знаний (благодаря
обширной базе знаний), возможность генерировать большое количество гипотез для
конкретного вопроса, опираясь на базу знаний.Watson имеет большую базу знаний и
поэтому она хороша для поиска ответов на самые разные вопросы, но для
узкоспециализированных областей требуются дополнительные и более детальные
сведения, поэтому применительно к ним, требуется ее доработка и адаптация.
Кроме того, система на данный момент работает только с английским языком, что
также сужает круг ее применения.
.1.5 Система Inbenta
Еще одна из подобных систем, которая занимается обработкой текста на естественном языке - Inbenta. Inbenta представляет собой сервис, который интегрируется с сайтом и улучшает поиск по сайту. Улучшение поиска получается за счет предварительного анализа вопроса на естественном языке.
Основные этапы анализа следующие:
Исправление ошибок в введенной фразе
Находит родственные связи между словами(рис.2), удаление “шума”
Определение “семантического веса” каждого слова
Таким образом, Inbenta находит семантически наиболее важные слова и далее
ведет поиск ответа, исходя из этих слов.
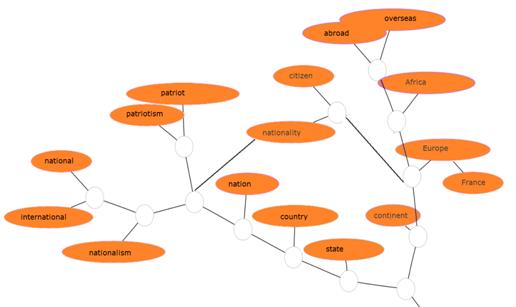
Рисунок 6 - Поиск родственных слов в Inbenta
Преимуществом Inbenta является отсутствие необходимости в базе знаний
предметной области - анализ ведется, опираясь исключительно на лингвистику. В
следствие этого, инструмент можно достаточно легко интегрировать в веб-сервисы,
так как требуется минимальный анализ контента сайта.
.2 Методы семантического поиска информации в области интернет ресурсов
1) Нейронные сети
Этот метод использует «Яндекс» в своем новом поисковом алгоритме «Королёв»[2]. Это новый виток в развитии поисковых систем - после эпохи машинного обучения и алгоритмов PageRank. Задача поиска по смыслу в данном контексте - найти ближайшее соответствие запроса пользователя и заголовка страницы. Для нахождения близости между заголовком документа и запросом пользователя, сначала эти параметры представляются в форме векторов. Чем больше скалярное умножение этих векторов - тем релевантнее документ запросу. К преимуществам метода можно отнести то, что запрос становится устойчивым к переформулированию, к тому же становится возможным найти близкие по содержанию документы, даже если точного совпадения по фразе не было найдено, но смысловое содержание документов близко. Недостатки - это сложность обучения нейронных сетей и требующиеся для этого огромные массивы данных.
) Генетический алгоритм
Использование генетического алгоритма становится возможны при семантическом поиске, так как сам порядок действий пользователя при поиске напоминает эволюционный процесс, который включает в себя нахождение эффективных наборов и сочетаний ключевых слов.
В результате работы генетического алгоритма формируется устойчивая и эффективная популяция поисковых запросов, формируется семантическое ядро документа. Для эффективной работы данного алгоритма также требуется большое количество данных и документов для анализа.
) Построение семантического расширения поискового запроса
Основная идея данного подхода заключается в том, чтобы для каждого поискового запроса строить его семантическое описание, и далее при поиске опираться на него. Алгоритм семантического преобразования включает в себя выделение основных аспектов в вопросе, после его идет построение модели вопроса на основе концептуальных базисов.
) Концепция семантических сетей
В данном подходе говориться о модели поиска, когда каждый документ содержит описание, понятное компьютеру. По этому описанию и ведется поиск. Для поиска строятся RDF-схемы запросов от пользователей.
) Поиск на основе нечетких множеств
Данный подход к поиску включает в себя несколько моделей: основанные на
обобщении нечеткого отношения, основанные на максиминной близости между
нечеткими множествами и другие. Преимущества данных моделей заключается в том,
что текстовый запрос априори является нечеткой информацией, что не принимается
во внимание в большинстве существующих систем поиска.
.3 Метод семантической обработки информации на основе интенсиональной логики
Основоположником этого направления является Ричард Монтегю. Основную мысль он выразил в одной из своих работ “English as a formal lanuage”[3], в которой описывает формализацию английского языка. Цитата из книги: “I reject the contention that an important theoretical difference exists between formal and natural languages. ... In the present paper I shall accordingly present a precise treatment, culminating in a theory of truth, of a formal language that I believe may reasonably be regarded as a fragment of ordinary English. ... The treatment given here will be found to resemble the usual syntax and model theory (or semantics) [due to Tarski] of the predicate calculus, but leans rather heavily on the intuitive aspects of certain recent developments in intensional logic [due to Montague himself]” . Перевод данного отрывка: “Я отвергаю тезис, что формальные и естественные языки существенным образом различаются с теоритической точки зрения.. В настоящей работе я представлю точное описание формального логического языка, который, как я думаю, может с достаточными основаниями рассматриваться как фрагмент обычного английского языка; это описание завершается теорией истинности. Это описание аналогично обычному синтаксису и теории моделей(или семантике) для исчисления предикатов [построенные Тарским], но существенным образом опирается и на некоторые последние результаты в интенсиональной логике [полученные самим Монтегю].”
В своей работе, Монтегю рассматривает формализацию текстов на английском языке. Для решения поставленной задачи требуется формализация текста на русском языке, который по своей структуре достаточно сильно отличается от английского.
Для формализации естественного языка, Монтегю в своих работах использовал 2 подхода:
) Прямой прямое описание синтаксиса естественного языка и интерпретация его в моделях.
) Двухэтапный - использование промежуточного логического языка. В данном методе используется промежуточный логический язык, который близок к естественному. Далее происходит интерпретация с промежуточного языка на естественный. Монтегю предлагает использовать в качестве промежуточного языка язык интенсиональной логики.
В работе будет рассматриваться более подробно второй подход и
непосредственно преобразование фразы в язык интенсиональной логики. Одним из
ключевых этапов преобразования фразы на естественном языке в логическую формулу
является синтаксический анализ предложения. Центральный принцип формальной
семантики говорит о том, что отношение между синтаксисом и семантикой
композиционно. Соответственно, зная синтаксическую структуру предложения, можно
построить его логическую формулу.