Дипломная (вкр): Методы и алгоритмы семантического поиска информации в системах поддержки пользователей
.2.3 Адаптация алгоритма поиска для текстов на русском языке
Существует 5 типов языков по морфологической типологии: аналитические, изолирующие, синтетические, полисинтетические и олигосинтетические. Английский язык относится к аналитическим языкам - т.е. языкам, в которых грамматические отношения передаются в основном через синтаксис. То есть через служебные слова, фиксированный порядок слов, контекст. В противоположность аналитическим языкам существует тип синтетических языков. Особенностью синтетических языков является то, что грамматические значения выражаются в пределах самого слова - то есть формами самого слова.
Флективные языки относятся к категории синтетических и их особенностью является то, что в языках этого типа словоизменение осуществляется с помощью флексий. Русский язык как раз относится к категории флективных языков.
Основываясь на этом доводе, можно сделать вывод, что при определении
взаимосвязей между словами помимо синтаксиса, важную роль играет морфология и
морфологический анализ. Таким образом, требуется адаптация алгоритма Монтегю по
преобразованию фразы на естественном русском языке в формулу формальной семантики.
.2.4 Адаптация алгоритма для систем поддержки пользователей
Вследствие роста сложности ИС, возникает необходимость в создании специальных механизмов для упрощения работы пользователя с ИС. Одним из таких механизмов являются системы технической поддержки. Системы технической поддержки (СТП) - это класс ИС, который обеспечивает помощь пользователю в эффективном взаимодействии с технологическим продуктом либо услугой[7].
Системы технической поддержки выполняют следующие функции:
) Помогают пользователям максимально быстро находить ответы на возникающие в ходе работы вопросы
) Помогают быстро находить и разрешать сбои в работе программного обеспечения
) Производят корректировку развития продукта в соответствии с отзывами пользователей
) Акцентируют внимание на слабых местах системы
) Позволяют определять дополнительные требования к системе
На рис. 8 представлена схема работы службы работы управления ошибками. Первым этапом идет обнаружение инцидента - которое происходит благодаря обращению пользователя, либо сигналу системы мониторинга. Вторым этапом информация об ошибке логируется - записывается время обнаружения ошибки и подробная техническая информация о том, в каких условиях произошла ошибка. Следующий этап - возникшая ошибка определяется одной из существующих категорий, и ей присваивается какой-то приоритет.
В текущей работе рассматривается этап работы, когда сообщение об ошибке поступает от пользователя, и происходит поиск ответа на вопрос по текущей базе знаний. Чаще всего ответ дается вручную специалистами по поддержке пользователей, и СТП является только шлюзом, который передает информацию от одного звена в цепочке - другому. Существуют различные системы по автоматизации этого процесса. Один из примеров - helpdesk системы, в которых происходит сбор, категоризация и отслеживание входящих запросов. Но, в конечном счете, ответ на вопрос дает специалист.
Удобной формой взаимодействия с пользователем является чат, где
пользователь может задавать вопросы на естественном языке. Поэтому было принято
решение сделать поиск ответов на вопросы пользователя именно в форме чата.
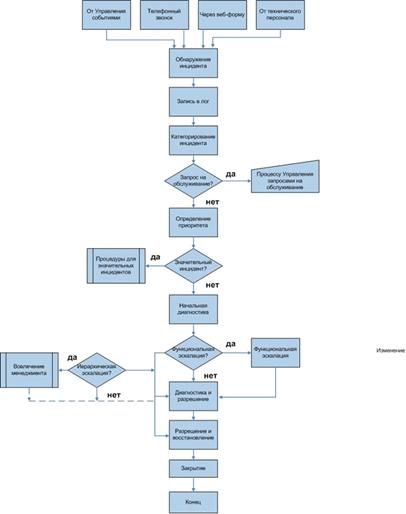
Рисунок 8 - схема управления обработкой ошибок
В текущем докладе рассказывается о возможности исключения специалиста из цепочки ответа пользователю в тех случаях, когда ответ на вопрос уже известен и сформулирован. Основной сложностью в данном вопросе является извлечение нужной информации из запроса пользователя. Когда человек вводит запрос, то он подразумевает некоторое смысловое содержание, и поиск должен происходить непосредственно опираясь на него.
Таким образом, в данной главе была рассмотрена математическая
составляющая перевода фразы на естественном языке в формулу формальной
семантики. Было сказано о двухэтапном преобразовании и правилах логической трансформации.
Также было замечено, что для русского языка важную роль играет морфологический
анализ, на который можно опираться для определения грамматического значения
слова.
3. Модели и алгоритмы семантического поиска в мультиагентной системе
поддержки пользователей
.1 Модель мультиагентной системы семантического поиска информации в
системе FAQ (Frequently asked questions)
Для распределенных интернет-систем хорошо подходит мультиагентная
структура организации[6]. Основной особенностью мультиагентных систем является
то, что решение задач в такой системе происходит с помощью отдельных
самостоятельных программ - так называемых “агентов”. На рисунке 2 представлен
пример структуры системы технической поддержки пользователей на основе
нескольких групп «ВКонтакте», для каждой из которых поисковый запрос
формируется отдельно. Далее мы рассмотрим, что для семантического поиска с
помощью интенсиональной логики требуется предварительный анализ ответов на
вопросы с целью их обработки и представления в виде формул формальной
семантики.
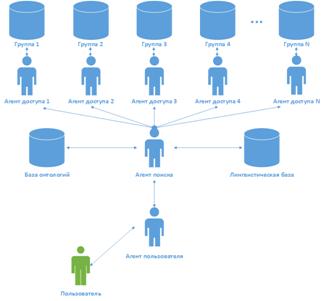
Рисунок 9 - Обобщенная структура агентно-ориентированной системы по вопросам в социальных сетях.
В представленной схеме отображено, что центральным агентом является агент
поиска. Он взаимодействует с агентом пользователя и получает от него запрос.
Далее агент поиска взаимодействует с базой онтологий и лингвистической базой
для обработки и нахождения наиболее подходящего варианта ответа. Агенты доступа
к группам сканируют группы в социальной сети и ищут новые вопросы, которые
затем заносятся в базу отнологий.
.2 Алгоритм заполнения базы знаний
На начальном этапе работы требуется заполнение базы знаний определенной
предметной области. В базу знаний вносятся вопросы и ответы, по которым далее
будет осуществляться поиск. При заполнении каждый вопрос проходит обработку и
записывается в формализованном для поиска виде. Алгоритм заполнения представлен
на рис. 10.
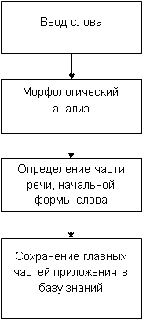
Рисунок 10 - алгоритм заполнения Базы знаний
Первым этапом происходит ввод вопроса и ответа на него. Далее вопрос
проходит морфологическую обработку - определяются часть речь, начальная форма
слова и такие параметры, как падеж или склонений. На основании этих данных,
определяются главные члены предложения, которые и записываются в Базу знаний.
Поиск далее осуществляется непосредственно опираясь на главные члены
предложения, так как они содержат основную смысловую нагрузку предложения.
Часть данного алгоритма также задействована при поиске правильного и наиболее
подходящего ответа на вопрос.
.3 Алгоритм расчета и поиска наибольшего семантического веса ответа
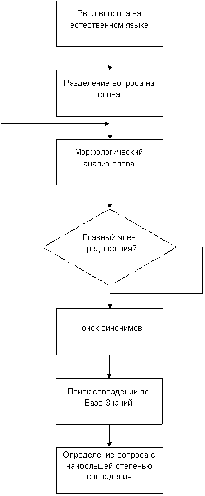
Рисунок 11 - Алгоритм поиска и расчета наибольшего семантического веса
ответа
После заполнения Базы знаний на основе наиболее общих вопросов, можно приступать к поиску. Алгоритм работы поисковой системы представлен на рис. 11. После того, как пользователь ввел вопрос, происходит разделение вопроса на слова. Каждое из этих слов анализируется отдельно. Результатом анализа является нахождение главных частей речи, по которым далее и идет поиск верного ответа. Непосредственно вычисление семантического веса идет на основе сравнения главных частей речи введенного пользователем вопроса и главных частей речи сохраненных в базе знаний вопросов. При совпадении смысла какого-то из слов готового варианта ответа и введенного вопроса, семантический вес увеличивается на условную единицу. Чем большее значение совпадения, тем большим считается значение семантического веса и вариант ответа является наиболее подходящим.
Таким образом, можно сделать вывод о том, что был реализован алгоритм семантического поиска на основе формальной логики Монтегю, с учетом особенностей русского языка. Большую роль при семантическом анализе в случае русского языка играет морфологический анализ, так как русский язык относится к категории флективных. При работе алгоритма большую роль играет насыщенность базы знаний заранее подготовленными вопросами и ответами по предметной области.
Несомненно, поиск не должен строиться только на морфологическом анализе,
но в данной конкретной ситуации, морфологический анализ позволяет достаточно
дешевым способом проверить принадлежность слова той или иной категории
формальной семантики. В следующей главе рассматривается реализация алгоритма и
его тестирование.
4. Экспериментальное исследование прототипа системы поддержки
пользователей на основе семантического поиска ответов на вопросы
.1 Архитектура системы
. Система способна находить ответы находить ответы на вопросы, заданные на естественном языке с достаточной степенью точности.
. Скорость поиска ответа на вопрос разработанной системы больше чем у стандартного раздела с FAQ.
3. Удобство использования системы выше чем у простого раздела с FAQ.
Разработка в текущей версии представляет собой бота, который может отвечать на вопросы по заранее известной предметной области. Знания о предметной области загружаются в систему в виде специально организованной базы знаний.
Для разработки приложения-бота была выбрана платформа Node.js. Эту программную платформу можно использовать в качестве веб-сервера, и она удобна тем, что в ее основе лежит асинхронное и событийно-ориентированное программирование, которое позволяет писать веб-приложения для взаимодействия с пользователем в реальном времени. Это как раз позволяет создавать веб-приложения, которые обмениваются данными с большой частотой - как и в случае с ботом.
В качестве базы данных используется MongoDB. MongoDB - это
документоориентированная система управления базами данных. К преимуществам этой
СУБД можно отнести скорость исполнения запросов, расширяемость и построение по
концепции документа. Построение по концепции документа очень удобно в данном
случае тем, что в будущем позволит изменять и добавлять новые поля в документы,
которые не были предусмотрены изначально.
мультиагентный интерфейс чат бот
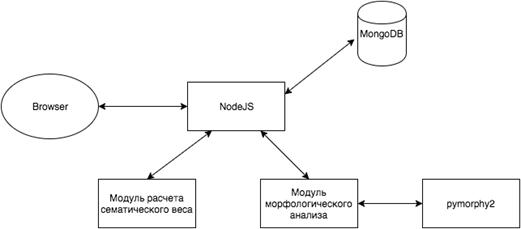
Рисунок 12 - Общая схема веб-приложения
Основная логика приложения находится на сервере под управлением nodejs. Для морфологического анализа подключена библиотека pymorphy2, с помощью которой можно определить базовые категории интенсиональной логики[8]. Первая версия алгоритма сервиса опирается на морфологический анализ. В следствии того, что русский язык относится к категории флективных языков, из данных, полученных после морфологического анализа, можно сделать достаточное количество выводов. Можно определить часть речи, род, число, склонение и т.п. В том числе, на основе этих данных можно с высокой точностью, определить сказуемое и подлежащее.
В основе первой версии алгоритма поиска как раз лежит определение главных
членов предложения. После определения главных членов предложения, происходит
поиск по совпадению в базе данных. Если оба большая часть главных членов
совпадает, то поиск считается успешным.
4.2 Программная реализация экспериментального прототипа
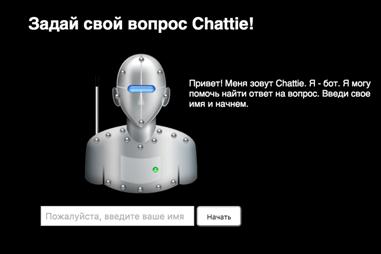
Рисунок 13 - Начальная форма диалога с ботом
На данный момент бот содержит информацию о веб-сервисе SmmBox и может
давать ответы на простейшие вопросы по работе сервиса. Таким образом,
уменьшается нагрузка на службу технической поддержки. Бот запущен на отдельном
сайте и на данный момент происходит тестирование, доработка и обучение бота
вопросам, поступающим по работе сервиса. Вопросы, поступающие по различным
каналам, классифицируются, обрабатываются и распределяются по категориям.
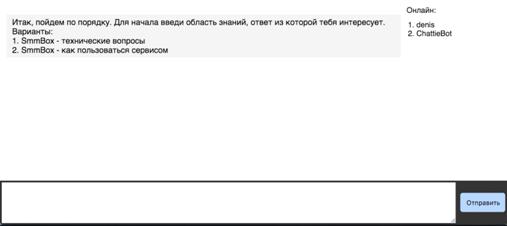
Рисунок 14 - Интерфейс чата с ботом
Основные программные решения, которые использовались при разработке:
"nodejs": "5.0.0",
"express": "4.10.2",
"semantics": "0.9.4",
"socket.io": "1.3.7"
Веб-сервис работает следующим образом:
Человек заходит на страницу поддержки SmmBox
Его встречает бот и предлагает задать вопрос
Человек вводит вопрос на естественном языке
Запрос отсылается на сервер, где обрабатывается и строится его формализованное представление
Первая версия алгоритма сервиса опирается на морфологический анализ. В следствии того, что русский язык относится к категории флективных языков, из данных, полученных после морфологического анализа, можно сделать достаточное количество выводов. Можно определить часть речи, род, число, склонение и т.п. В том числе, на основе этих данных можно с высокой точностью, определить сказуемое и подлежащее.
В основе первой версии алгоритма поиска как раз лежит определение главных
членов предложения. После определения главных членов предложения, происходит
поиск по совпадению в базе данных. Если оба большая часть главных членов
совпадает, то поиск считается успешным. Общая схема работы приложения
представлена на рис.15.
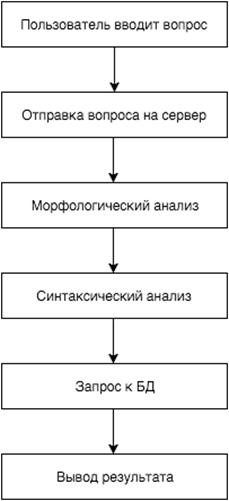
Рисунок 15 - Общий алгоритм работы приложения
Существует большое количество показателей, по которым можно оценивать
эффективность работы системы информационного поиска: это точность, полнота,
выпадение, релевантность и пертинентность. В данном случае нас интересует
последнее свойство - пертинентность. Пертинентность - это соответствие
полученной информации информационной потребности пользователя, т.е. по сути
показатель того, получил ли пользователь ответ на свой вопрос, или нет.
.3 Экспериментальные оценки релевантности и пертинентности запросов
Для тестирования были взяты по 25 вопросов из каждой категории: четко
сформулированные вопросы и вопросы без четкой формулировки.
Таблица 3 - Примеры естественно-языковых вопросов
|
|
Четко сформулированный вопрос |
Вопрос без четкой формулировки |
|
1 |
Как удалить мои фотографии? |
Как возможно удалить старую страницу, если ей уже не пользуются 4 года? |
|
2 |
Как запретить другим людям присылать мне сообщения? |
Кому ни отправляю сообщения в контакте мне пишет: пользователь запретил отправлять себе сообщение в настройках приватности! Что это такое? |
|
3 |
Как добавить пользователя в черный список? |
Здравствуйте, подскажите можно восстановить страницу которую удалила и прошло больше 7 месяцев? |
|
4 |
Как узнать общее количество сообщений? |
Каким образом мои друзья видят мои лайки и комменты в группах, в которых не состоят и не заходят туда? |
|
5 |
Как убрать из новостей все репосты? |
Не загружается изображения в сообщениях и через приложение и через сайт |
|
6 |
Как пригласить друга на сайт? |
Можете вернуть старый стиль ВКонтакте либо оптимизировать работу нового? |
|
7 |
Как пожаловаться на новость? |
Что делать если пропала часть переписки с другом? Как её восстановить? |
|
8 |
Как передать голоса другу? |
Как всё удалить то, что в разделе "Закладки"? |
|
9 |
Какие форматы видеозаписей поддерживает сайт? |
Здравствуйте, не могли бы Вы пожалуйста заблокировать пользователя? |
|
10 |
Как мне стать агентом поддержки? |
Не могу ввести с капчи абракадабру, не разбираю символы, как убрать это при входе? |