Дипломная (вкр): Методы и алгоритмы семантического поиска информации в системах поддержки пользователей
Сравнивались система поиска в социальной сети ВКонтакте и прототип системы с реализованной интенсиональной логикой Монтегю. В результате теста на четко сформулированные вопросы ответы нашлись в 100% случаев. Для вопросов без четкой формулировки, результаты представлены в табл.2.
FAQ
«ВКонтакте» представляет собой вопросы, которые отсортированы по категориям:
доступ к странице, настройки приватности, друзья и подписчики и др. (рис.15).
Кроме того, есть система поиска ответов на вопросы. Вопросы для теста брались
из реальных источников - групп технической поддержки в этих социальных сетях.
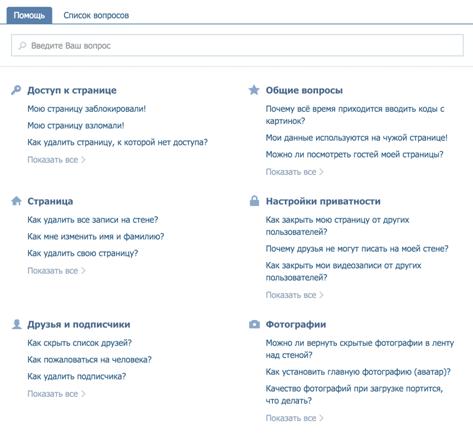
Рисунок 16 - Раздел помощи «ВКонтакте»
По результатам тестирования можно сделать вывод, что система помощи ВКонтакте не предназначена для вопросов на естественном языке. Она хорошо ищет по ключевым словам, но плохо работает с неструктурированными предложениями. Прототип системы с интенсиональной логикой ищет ответы на вопросы на естественном языке лучше, но также еще нуждается в доработке.
Таким образом, в ходе работы были исследованы подходы к анализу текста на естественном языке. Были исследованы принципы работы в существующих системах семантического поиска. Подробно рассматривался подход формальной семантики Ричарда Монтегю, который был адаптирован для текстов на русском языке. На основании теоретических исследований была спроектирована и реализована информационная система, позволяющая проводить анализ текстов на естественном языке.
В качестве основного применения системы рассматривается упрощение работы системы технической поддержки и упрощение работы пользователя с FAQ (frequently asked questions). Как правило, алгоритмы поиска, встроенные сейчас в подобные системы опираются на совпадение слов и игнорируют смысловое содержание.
Основными причинами, почему в качестве применения были выбраны системы поддержки являются следующие:
) Большой объем информации, содержащийся в таких системах, затрудняет поиск ответа на нужный вопрос
) Область поиска ограничена рамками конкретной предметной области, что делает возможным предварительный анализ и структуризацию информации.
В сравнении с подобными алгоритмами извлечения ключевых слов из текста, адаптированных для русского языка, алгоритм показал свое преимущество основываться не только на анализе и извлечении ключевых слов, но и на начальном семантическом анализе. Семантический анализ оказался более структурным и позволил более конкретно понимать смысл, содержащийся в предложении и на основании этого смысла выполнить более точный поиск.
Несомненно, в более широких областях, где будут требоваться большие объемы данных, такие продукты, как Inbenta или IBM Watson будут более выигрышными, но для небольших сайтов, занимающихся конкретной специфической деятельностью, использование бота-консультанта с семантическим анализом входящего текста, видится более перспективным. Такой бот может быть относительно легко построен для предметной области и сможет оказывать необходимую помощь всем посетителям сайта.
Список источников
1. «Блог Яндекса» - Алгоритм «Палех»: как нейронные сети помогают поиску Яндекса [Электронный ресурс] - Режим доступа: https://yandex.ru/blog/company/algoritm-palekh-kak-neyronnye-seti-pomogayut-poisku-yandeksa
2. Хабрахабр. Блог компании Яндекс: Искусственный интеллект в поиске. Как Яндекс научился применять электронные сети, чтобы искать по смыслу, а не по словам. [Электронный ресурс] - Режим доступа: https://habrahabr.ru/company/yandex/blog/314222/
3. Montague, R., «English as a formal language , in B. Visentini et al. (eds.), Linguaggi nella Societa et nella Technica, Milan: Edizioni di Communita, 188-221. Reprinted in Thomason (ed.) 1974, pp. 188-221.
4. Швецов А. В. Летовальцев В. И. Программная формализация естественного языка средствами формальной семантики // Программные продукты и системы №3, 2010 г.
. Летовальцев В. И. Методы и алгоритмы семантической обработки информации в корпоративных хранилищах// 2011, С. 1-235.
. Швецов А.Н., Горбунов Д.П. «Метод семантической обработки информации в интернет-ресурсах на основе интенсиональной логики» // Вузовская наука - региону, 111-113(2015)
. Интуит. Управление службой технической поддержки и инцидентами [Электронный ресурс] - Режим доступа: http://www.intuit.ru/studies/courses/3704/946/lecture/15109
8. Korobov M.: Morphological Analyzer and Generator for Russian and Ukrainian Languages // Analysis of Images, Social Networks and Texts, pp 320-332 (2015).