Материал: Модели и алгоритмы проектирования и разработки систем поддержки принятия инвестиционных решений. Морозов В.П., Баркалов С.А

Внимание! Если размещение файла нарушает Ваши авторские права, то обязательно сообщите нам

мантические сети, не используются [194]. В данной работе для обработки газетных подборок использовалась следующая технология. Для обработки заголовка статьи и одного - двух первых предложений вызывался центральный фрейм. Его ячейки заполнялись понятиями, содержащимися в выделенных лексемах. В зависимости от их значимости некоторые понятия становились термами новых фреймов, ячейки которых заполнялись понятиями из лексем других фрагментов статьи. В процессе заполнения фреймовой структуры трудности вызывали сложные местоимения. В интересах их устранения часть сложных местоимений ограничивалась в использовании на основе стоп-словаря [60].

Анализ других источников информации (интернет, электронные журналы и др.), содержащих описание кризисного состояния внешней среды, показал целесообразность использования фреймов в совокупности с семантической сетью. Как оказалось, ещё одним важным достоинством использования фреймов явилась возможность реализации с их помощью ответов на вопросы. В рамках данной работы развитие этого направления не рассматривалось.

Применительно к описанию кризисного состояния внешней среды использование гибридной модели синтаксического анализа позволило создать базу знаний (БЗ) в виде набора терминологических портретов, характеризующих различные понятия данной предметной области. На основе созданной БЗ объекты данной предметной области идентифицировались и накапливались в соответствующей базе данных.

Ниже приведено несколько правил изБЗ:

1. ЕСЛИ ОБЪЕКТ. АТРИБУТ = “ЛИКВИДНОСТЬ“ И ОБЪЕКТ. ЛИКВИДНОСТЬ = “ОТСУТСТВУЕТ”, ТО

ОБЪЕКТ. ИМЯ = “БАНКРОТ”, И ОБЪЕКТ. АТРИБУТ = “ПОТЕНЦИАЛЬНЫЙ”

2. ЕСЛИ ОБЪЕКТ. АТРИБУТ = “ВВП“ И ОБЪЕКТ. ВВП = “НИЗКИЙ” И

ОБЪЕКТ. АТРИБУТ = “ДОЛГ” И ОБЪЕКТ. ДОЛГ = “ВНЕШНИЙ” И

ОБЪЕКТ. ДОЛГ = “ВЫСОКИЙ”, ТО ОБЪЕКТ. ИМЯ = “КРИЗИС” И

ОБЪЕКТ. КРИЗИС = “ФИНАНСОВЫЙ”.

Подобные правила позволили добавлять фреймы, атрибуты во фреймы, менять значения атрибутов и др.

Применение разработанной семантической матрично - лексической модели анализа текстов в совокупности с базой знаний позволили с определенной точностью идентифицировать в текстовой информации определенные понятия, их атрибуты и связи с другими объектами. В результате появилась потенциальная возможность извлечения дополнительных данных (новых знаний), содержащихся в текстах, что обусловило необходимость разработки соответсвующей модели.

191

3.8. Модель извлечения новых знаний

Модель извлечения новых знаний (МИНЗ) базируется на определении логических цепочек взаимосвязей терминов в массиве текстовых документов и, в случае их наличия, извлечении новых терминов [111].

Под новыми знаниями будем понимать новую дополнительную терминологическую информацию, извлекаемую из текста (текстов).

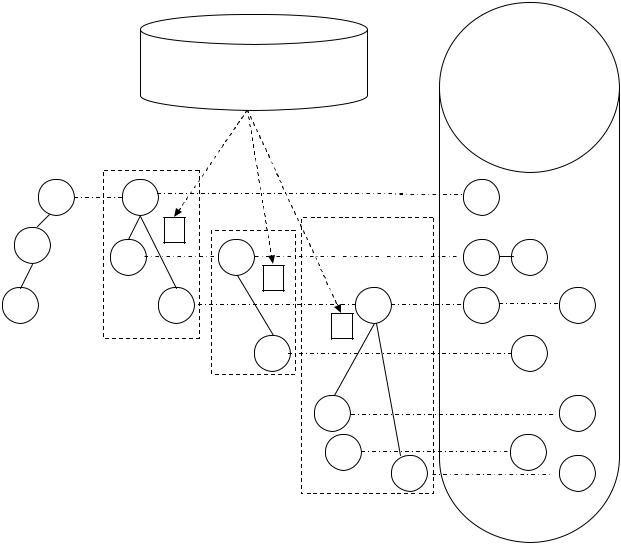
Схема, поясняющая принцип функционирования МИНЗ, приведена на рис. 3.6.

На вход МИНЗ подается набор терминов (Т1, Т2, Т3), для которых необходимо найти дополнительную информацию. Пользователем может быть сформирован набор правил (критериев) отбора новых терминов, содержащихся в БЗ,

БЗ

Т1

Т111


Т111


1


БДДИ

Т2

g1


Т121

Т2121

Т121

Т2121


g12


Т3

Т131

Т3131

Т131

Т3131


g13


Т112


Т112


Т321


Т321


Т34


Т34


Т313


Т313

Рис. 3.6. Схема, поясняющая принцип функционирования МИНЗ

в виде пороговых значений частот их встречаемости в текстах (g11 ,g12 ,g13 ). Кроме того, он может задавать синонимы искомых терминов (например, «жар-

192

гонизмы»), которые не содержатся в используемом словаре [41].

В результате проведенного семантического анализа установлено, что из множества текстов, принадлежащих заданной предметной области (терминологическому портрету информационной системы), в трех текстах (отмечены прямоугольниками с пунктирными границами) найдены восемь терминов (Т111 ,Т121 ,Т131 ,Т2121 ,Т112 ,Т3131 ,Т321 ,Т331 ), имеющих логические цепочки взаимосвязей (представлены на рисунке прямыми штрих-пунктирными линиями) лишь с одним термином (Т1) из трех, поступивших на вход МИНЗ. Термины внутри цепочек имеют n, m–мерную двухуровневую индексацию (n – число текстов, связанных с данным термином, m–число взаимосвязанных терминов). Верхний n– мерный (в приведенной схеме – двойной) индекс указывает на тот факт, что термин текста за номером левого индекса логически связан с термином текста за номером правого индекса. Верхний одинарный индекс указывает на тот факт, что данный термин логически связан с одним из терминов только этого текста. Нижний m–мерный (в приведенной схеме – двойной) индекс указывает на тот факт, что термин текста за номером левого индекса логически связан с термином за номером правого индекса. В анализируемых текстах могут оказаться одиночные термины, не связанные с терминами других текстов. Для них используются верхние и нижние одиночные индексы. Все выявленные термины (связанные и не связанные) хранятся в базе данных дополнительной информации (БДДИ). К каждому из них у пользователя имеется доступ.

Для записи каждого термина в БДДИ имеется три поля: два поля, в которых хранятся верхний и нижний индексы, и текстовое поле, в котором хранится определение данного термина. Для хранения дублирующих терминов используется правило: «Если дублирующий термин одиночный (не содержит логических цепочек с другими терминами) и подобный термин уже содержится в БДДИ, то он исключается из БДДИ. В противном случае он записывается в БДДИ».

Хранение верхнего и нижнего индексов терминов позволило программными средствами Delphi реализовать процедуру восстановления межтекстовых терминологических взаимосвязей (логических цепочек). Данная процедура прошла апробацию [87] и показала себя аналогом подсистемы объяснения, используемой в экспертных системах. Однако для ее реализации не потребовалось применение специального математического аппарата (например, логики предикатов первого порядка и др.) и соответствующих высокоуровневых языков программирования (Пролог, ЛИСП и др.).

Вышеописанная технология терминологического поиска в СППИР нашла свою программную реализацию.

193

3.9. Программная реализация терминологического поиска в системе поддержки принятия инвестиционных решений

В интересах повышения оперативности терминологического поиска в СППИР была разработана система виртуального распределенного терминологического поиска (СВРТП), в дальнейшем с целью сокращения – система [151]. Она представляет собой пакет программ, предназначенных для распределенного поиска информации о терминах, вводимых пользователем, и извлечения связанных с ними новых дополнительных сведений в системах поддержки принятия решений, используемых в интересах снижения неопределенности внешней среды. Особенностью данной системы является возможность реализации терминологического поиска на виртуальных машинах (на локальной виртуальной машине и всети виртуальных машин).

Виртуальная машина представляет собой специальную программу, эмулирующую реальный ПК (BIOS, ЖМД, операционную систему и др.). Она позволяет осуществить обмен данными между локальным ПК, виртуальной машиной и их сетью [35].

Система выступает в ролиинтеллектуального поискового агента (ИПА). Интеллектуальность поискового агента обусловлена наличием процедур, реализующих механизм весовой генерации запросов, эквивалентный механизму пользовательских предпочтений. Разработанный ИПА обладает следующими важными свойствами:

-автономностью;

-интерактивностью;

-рациональностью;

-проактивностью.

Автономность характеризует тот факт, что ИПА самостоятельно выполняет значительную часть своей работы. Во время выполнения работы ИПА не взаимодействует с пользователем и с другими агентами.

Интерактивность подразумевает умение ИПА взаимодействовать с пользователем [144]. Суть взаимодействия заключается в настройке моделей и механизмов ИПА пользователем, получении заданий от него и предоставлении емуполученныхрезультатов.

Рациональность заключается в выполнении определенных действий для достижения поставленной цели и отсутствии противоположных действий, препятствующих ее достижению.

Проактивность предполагает наряду со сбором основной информации (по введенному термину) также сбор дополнительной информации.

ИПА реализует функции передаточного механизма между потребностями пользователя и стандартными поисковыми системами, такими как [150]: Яндекс, Google, Rambler и др., кроме того, ИПА обладает специфическими функциями, такими как:

- построение терминологического портрета предметной области пользователя;
194

-построение терминологического портрета текста;

-селекция основной терминологической информации;

-селекция дополнительных терминов;

-выборка информации по дополнительным терминам;

-ведение терминологической базы данных (БД);

-накопление в базе данных основной и дополнительной терминологической информации;

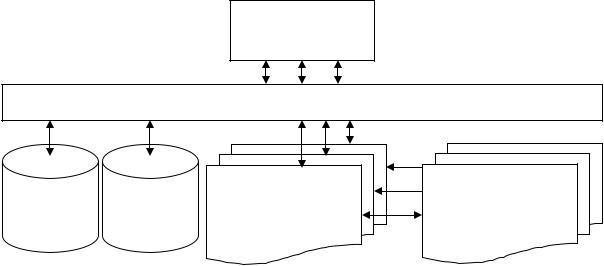
-формирование инсталляционных пакетов исполнительных поисковых агентов для локальных и виртуальных машин. Структурно-функциональная схема ИПА приведена на рис. 3.7. Интерфейс пользователя предназначен для получения заданий от пользо-

вателя и предоставления ему полученных результатов. На начальном этапе функционирования системы на основе интерфейса формируется терминологический портрет предметной области пользователя путем ввода набора терминов и их распределения по различным уровням иерархии.

Интерфейс

пользователя

Модуль управления

База

База

Набор

Стандартные

исполнительных

поисковые

моделей

данных

ПА

системы


Рис. 3.7. Структурно-функциональная схема ИПА

Модуль управления занимает центральное место в системе. Он обеспечивает взаимодействие всех элементов системы и координацию их функционирования в соответствии с заданной логикой (моделью). После запуска системы он автоматически переходит в активное состояние и ожидает команды пользователя. Активное состояние модуля управления предполагает выполнение с определенной периодичностью набора ряда процедур, таких как:

-упорядочение записей в распределенной БД в соответствии с иерархией терминологического портрета предметной области;

-индексирование записей в распределенной БД по иерархическим сегментам терминологического портрета предметной области;

-очистка БД от информации, невостребованной пользователем в течение заданного временного интервала;

-опрос готовности дежурного исполнительного поискового агента.

195

Источник: https://studfile.net/preview/16563833/