Материал: Оптимизация и моделирование в автоматизированных системах
Угроза представляет из себя объект, обычно получаемый из внешней подсистемы. Он содержит несколько специальных полей, тип угрозы, индикатор угрозы, временная отметка, некое описание.
Угроза почти всегда содержит в себе некоторую информацию, которая позволяет идентифицировать устройство, на котором произошло событие, повлекшее появление этой угрозы. Такой информацией может являться уникальный идентификатор устройства, его имя или другая идентифицирующая информация. В блоке 3 производится выборка существующих оповещений из базы данных по идентификатору, полученному из угрозы.
Для каждого полученного оповещения выполняется комплекс проверок с целью идентификации принадлежности угрозы к этому оповещению. Комплекс проверок включает в себя проверку индикатора угрозы и индикатора оповещения. Эта проверка показана в блоке 5. Обычно, анализа индикатора оповещения бывает достаточно чтобы сделать вывод о том, что угроза не имеет отношение к оповещению.
Если связь установлена, тогда необходимо исследовать тип угрозы. Это исследование показано на рисунке в блоке 6.
Если угроза не имеет тип «очистка», то принято обновлять время последнего воспроизведения проблемы. Это обновление показано в блоках 7 и 8.
Если угроза имеет тип «очистка», это означает что оповещение должно считаться исправленным в автоматическом режиме. В текущей реализации, при условии, что угроза имеет тип «очистка», предлагается переносит ь неактивное оповещение в другую таблицу. Это действие показано на рисунке в блоках 9 и 10.
Если ни одно из текущих оповещений не соответствует пришедшей угрозе, тогда необходимо создать новое оповещение на основе данных, полученных из угрозы. Этот процесс показан на рисунке в блоках 11, 12, 13.
Итогом работы алгоритма является обновление, удаление или создание нового оповещения в базе данных. Далее, эти оповещения может проанализировать сетевой инженер на предмет поиска неисправности, для принятия решений или получения статистики.
Представленный алгоритм является минимально необходимым для каждой подсистемы мониторинга и анализа работы оборудования распределенной компьютерной сети телеком-оператора.
Развитие телекоммуникационных технологий это одно из ключевых сфер в жизни современного общества. Поддержка нормального функционирования сетей стала одной из приоритетнейших задач, поэтому в эту структуру сегодня программисты всего мира пытаются встроить алгоритмы с применением новейших технологий, таких как нейронные сети, генетические алгоритмы, методы вероятностного программирования и многие другие.
В действительности, задача поддержания нормального функционирования оборудования в сети и своевременное предупреждение неисправностей — это отличное поле деятельности для алгоритмов с машинным обучением [3]. В
45
крупных телекоммуникационных компаниях за период работы складывается в базу данным огромное количество оповещений. Если использовать эту базу данных как основу для обучения нейронной сети, то можно получить очень качественного помощника для любого сетевого инженера.
Простейшим примером применения этой технологии является root-cause- analysis. Это специальные алгоритмы, предназначенные для построения зависимостей между отдельными оповещениями. Таким образом, система может делать предположения о том, что, например, скорость на интерфейсе А устройства Б равна нулю потому что интерфейс А переведен в положение «выключено». С точки зрения классической системы эти два оповещения не связаны, так как у них не совпадают индикаторы. Пользователь в этом случаи получит два несвязанных оповещения и может потратить время на поиск неисправности основываясь на оповещении, говорящем о нулевой скорости, а не о том, что интерфейс выключен.
Использование нестандартных средств решения этой проблемы приведет к тому, что пользователь будет видеть предполагаемую иерархическую структуру оповещений. Тогда он может быстро оценить масштаб проблемы и, что не менее важно, оперативно найти причину неисправности и ее устранить.
Особенно полезен root-cause-analysis, когда выполняется работа с оповещениями на основе SNMP-трапов от устройств. Очень часто, именно такие оповещения содержат в себе самую полезную информацию и указывают на корень проблемы.
Все вышеперечисленные предположения можно легко уложить в модель нейросети. Чем больше логических цепочек будет вложено при обучении, тем эффективнее будет проводиться анализ причинно-следственных связей. Не исключено порождение новых гипотез. Возможно подключение к анализу раздела «Performance-management» с целью отслеживания влияния значений метрик на появление оповещений.
Литература
1.Самуйлов, К. Е. Сети и телекоммуникации: учебник и практикум для академического бакалавриата / К. Е. Самуйлов, И. А. Шалимов, Д. С. Кулябов.
—Москва: Юрайт, 2018. – 363 с.
2.Уилсон, Эд. Мониторинг и анализ сетей. Методы выявления неисправностей / Эд. Уилсон Лори, 2002. – 350 с.
3.Комашинский, В.И. Нейронные сети и их применение в системах управления и связи / В.И. Комашинский, Д.А. Смирнов. – М.: Горячая линия – Телеком, 2002. – 268 с.
ФГБОУ ВО «Воронежский государственный технический университет», Россия
46
УДК 681.3
Д.В. Романов
РАЗРАБОТКА АЛГОРИТМА ОБНАРУЖЕНИЯ МОШЕННИЧЕСКИХ ДЕЙСТВИЙ ДЛЯ ЛОГИСТИЧЕСКОЙ ПОДСИСТЕМЫ МОНИТОРИНГА АКТИВНОСТИ КЛИЕНТА
На современном этапе развития интернета и логистики многие компании, оказывающие посреднические услуги по доставке и обработке посылок, так или иначе, сталкиваются с фродом – мошенничеством со стороны клиента. Это ведет к тому, что компании несут убытки как финансовые, так и репутационные, и с каждым годом проблема становится все острее. Более 10 лет ведутся разработки в сфере защиты от подобных действий, стали появляться целые анти- фрод-системы, которые обрабатывают каждую такую активность и принимают решение о ее «подозрительности» с точки зрения мошенничества. И в настоящее время наличие подобной системы уже является рыночной необходимостью.
Первоначально такие системы строились на простейших эвристиках (правилах), при срабатывании которых действие клиента блокировалось. Количество таких эвристик может достигать порядка 200, однако зачастую некоторые из них оказываются ничем не подкреплены, часть – дублируют или являются следствие одного из другого [1]. А из-за того, что с каждым годом количество типов махинаций возрастает, их становится все труднее поддерживать, более того идет тенденция к снижению качества подобных проверок, вследствие чего заведомо мошенническая транзакция не отлавливается, а безопасная – попадает на проверку.
С каждым годом увеличивается интерес к искусственному интеллекту как со стороны крупных корпораций, так и у обычных исследователей и разработчиков, и он находит все новые применения. Это явление не обошло стороной и сферу антифрода. И одним из вариантов применения является использование алгоритмов машинного обучения для проверки активности клиентов. Главным преимуществом такого подхода является возможность самообучения как на истории активности, так и вновь поступающих транзакциях.
Одним из самых бюджетных вариантов построения подсистемы проверки являются облачные вычисления, и в частности платформа Microsoft Azure. С ее помощью можно организовать целый веб-сервис по проверке с применением алгоритмов машинного обучения. В этот сервис будет выделена вся логика бизнес-процесса анализа данных и интерпретации результата: является ли данная транзакция подозрительной или нет.
Опишем алгоритм работы облачного веб-сервиса. Клиент взаимодействует в сети с некоторым логистическим сайтом, который частично запоминает все совершаемые действия, а также общедоступные сетевые данные клиента. На определенные действия может потребоваться проверка, и при возникновении
47
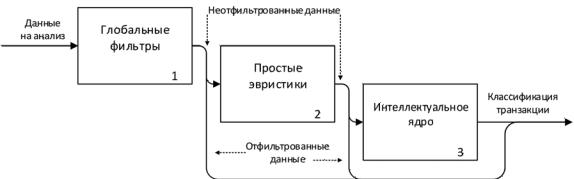
такого случая происходит обращение к нашей облачной подсистеме проверки через интерфейс взаимодействия (API); при этом в нее передаются все собранные данные по клиенту. Подсистема на основании этих данных осуществляет анализ и интерпретирует результат с помощью двухклассовой классификации – является ли действие подозрительным или нет.
События, на которые может потребоваться проверка, определяются исходя из их типа, и какой ущерб может принести подобное действие. Обычно такие проверки связаны с банковскими операциями, а также доступом в личный кабинет клиента и его расчетному счету. Кроме того при изменении каких-либо персональных данных такие проверки также целесообразно проводить, как и общие профилактические для определенного сегмента клиентов.
После того, как подсистема проверки делает вывод о безопасности операции, она передает ответ основному серверу, который непосредственно либо разрешает действие, либо останавливает и помечает пользователя для дополнительной проверки, при этом все его дальнейшие попытки взаимодействия будут заблокированы. В случае логистики для разрешения подобной ситуации происходит общение с клиентом через электронную почту или мессенджеры, и после необходимого подтверждения аккаунт может быть разблокирован.
Учитывая возможный объем подобных проверок, целесообразно повысить производительность подсистемы с помощью несложных инструментов предпроверки.
Рис. 1. Схема проверки данных клиента
Глобальные фильтры представляют собой заранее известный список, при попадании в который транзакция автоматически будет считаться подозрительной [2]. Каждая активность клиента пропускается через весь список, и только если ни одно из них не сработало, она проходит по подсистеме дальше. Перечислим возможные глобальные фильтры для логистиечской сферы:
1)страны авторизации пользователя;
2)страны, заблокированные для операций с лицевым и банковским сче-
том;
3) страны адресов доставки.
48
Простые эвристики – некоторые условия по принципу продукционной модели «ЕСЛИ-ТО», при выполнении хотя бы одной из них транзакция отмечается как небезопасная и тут же блокируется. Эвристики с жесткой логикой не должны быть слишком сложными, упрощение позволит сделать их более прозрачными. Примеры подобных эвристик:
1)добавление большого количества адресов;
2)частый заход из разных мест (по IP-адресу);
3)достижение лимита по денежным средствам;
4)оплата различными способами;
5)несоответствие плательщика карты и данных профиля.
Наличие обоих способов предпроверки позволит существенно сузить круг рассматриваемой активности, сэкономив вычислительные ресурсы. И только после того, как оба барьера будут преодолены, транзакция отправляется для проверки в интеллектуальное ядро.
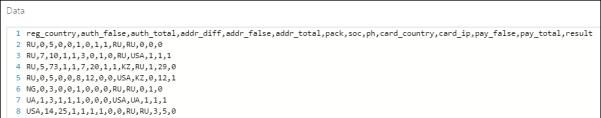
Создавая модель подсистемы, необходимо определить, какие именно данные будут участвовать в анализе. Был определен список основных критериев, которые прямым образом влияют на подозрительность транзакций [1]:
1)reg_country – 2-буквенный код страны клиента;
2)auth_false – кол-во неуспешных попыток авторизации;
3)auth_total – кол-во авторизаций;
4)addr_diff – кол-во адресов, не из региона проживания;
5)addr_false – кол-во адресов в запрещенные страны;
6)addr_total – общее кол-во адресов на аккаунте;
7)pack – успешно доставленных посылок;
8)soc – есть привязка социальных сетей (да/нет в формате 1/0);
9)ph – есть привязанный мобильный телефон (да/нет);
10)card_country – страна банка эмитента;
11)card_ip – страна совершения платежа;
12)pay_false – неудачных попыток оплаты;
13)pay_total – общее кол-во платежей на аккаунте;
14)result – является ли транзакция подозрительной (да/нет).
Рис. 2. Фрагмент тестовой выборки
Для примера расшифруем строку данных:
RU,4,57,1,0,2,0,1,0,USA,DE,1,1,1
49