Материал: Оптимизация и моделирование в автоматизированных системах
Литература
1.Пашуева, И.М. Моделирование и анализ подсистемы управления центрами быстрого реагирования с помощью сетей Петри / И.М. Пашуева, С.М. Пасмурнов // Вестник Воронежского государственного технического университета. 2011. Т. 7. № 9. С.106-109.
2.Пашуева, И.М. Применение сетей Петри в моделировании подсистемы управления центрами быстрого реагирования / И.М. Пашуева, С.М. Пасмурнов // Системы управления и информационные технологии: научно-технический журнал. 2011. №4.1(46). С. 162-166.
3.Пашуева, И.М. Моделирование работы распределенной сети служб быстрого реагирования с использованием функции агрегирования / И.М. Пашуева // Физико-математическое моделирование систем: материалы XIII междунар. семинара. Воронеж, 2015. Ч. 2. С.65-68.
4.Пашуева, И.М. Моделирование процессов принятия оперативных управленческих решений в системе управления центрами служб быстрого реагирования/ И.М. Пашуева // Физико-математическое моделирование систем: материалы XIII междунар. семинара. Воронеж, 2015. Ч. 2. С.69-73.
5.Пашуева, И.М. Имитационной моделирование системы управления центрами служб быстрого реагирования с использованием многокритериальных оценок / И.М. Пашуева // Физико-математическое моделирование систем: материалы XIII междунар. семинара. Воронеж, 2015. Ч. 2. С.74-78.
6.Пашуева, И.М. Моделирование процессов перераспределения экипажей служб быстрого реагирования при возникновении чрезвычайной ситуации на отдельном участке обслуживания // Интеллектуальные информационные системы: материалы конференции, Воронеж, 2018. Ч2. С. 33-36.
7.Пашуева, И.М. Описание и оценка эффективности подсистемы поддержки принятия управленческих решений в условиях неопределенности с применением математической модели на основе оценки рисков на примере работы центра бы-
строго реагирования / И.М. Пашуева, С.М. Пасмурнов, А.В. Бондарев // Вестник Воронежского государственного технического университета, 2017. Т. 13. Вып.
6.С.7-12.
8.Пашуева, И.М. Моделирование процессов управления центром быстрого реагирования в GPSS / И.М. Пашуева // Математическое и компьютерное моделирование, информационные технологии управления: сб. тр. Школы для студентов, аспирантов и молодых ученых «МКМИТУ-2016». Воронеж, 2016. С. 147-152.
9.Пашуева, И.М. Особенности разработки программного комплекса управления центром догоспитальной медицинской помощи. / И.М. Пашуева // Математическое и компьютерное моделирование, информационные техноло-гии управления: сб. тр. Школы для студентов, аспирантов и молодых ученых «МКМИТУ2016». Воронеж. 2016. С. 144-147.
ФГБОУ ВО «Воронежский государственный технический университет», Россия
40
УДК 519.16
Н.В. Старостин, И.Н. Хапаев
ПРОГНОЗ ТРУДОЕМКОСТИ ИНДИВИДУАЛЬНЫХ ЗАДАЧ КОММИВОЯЖЕРА НА ОСНОВЕ МЕТОДОВ МАШИННОГО ОБУЧЕНИЯ
Для современных наукоемких технологий проблема прогнозирования затрачиваемых вычислительных ресурсов при поиске решений сложных задач является актуальной. В работе на примере классической задачи поиска минимального гамильтонова цикла (задачи коммивояжера) на ориентированном графе сделана попытка спрогнозировать трудоемкость решения задачи классическим алгоритмом Литтла [1]. Под трудоемкостью решения индивидуальной задачи будем понимать число порожденных алгоритмом ветвей и границ поискового дерева решений [2]. В работе [3] на основании масштабного вычислительного эксперимента была сформулирована гипотеза о том, что вид распределения трудоемкости на семействах множеств индивидуальных задач не зависит от размера задач. Это дает основание для поиска обобщающих характеристик (набора признаков) классов индивидуальных задач, которые позволят распределить «сложные» задачи от «простых».
Решение проблемы поиска обобщающих характеристик классов индивидуальных задач предлагается осуществлять в три этапа. На первом этапе осуществляется генерация обобщающих характеристик. На втором этапе выполняется генерация множества задач с рассчитанными характеристиками и значениями трудоёмкости. На третьем этапе происходит проверка способности выбранного набора признаков к осуществлению прогнозирования вычислительных издержек на контрольном множестве задач.
Реализация первого этапа предполагает вовлечение исследователя, в задачу которого входит определение возможных обобщающих характеристик. Такими признаками являются, например, размер задачи, распределение значений коэффициентов в исходной матрице расстояний, интервалы значений коэффициентов в строках и столбцах матрицы и т.д. Эти данные и будут явля ться признаками, которые предлагается описывать в виде вещественных векторов (векторы-признаки). В качестве первоначального набора признаков были выбраны векторы-признаки, которые вычислялись по матрице расстояний: 1) вектор минимальных элементов по строкам матрицы расстояний; 2) вектор минимальных элементов по столбцам; 3) вектор дисперсии по строкам; 4) вектор дисперсии по столбцам; 5) вектор, описывающий распределение приведенных значений матрицы расстояний.
Второй этап предполагает наличие структуры генерации и хранения размеченных данных. Была создана инфраструктура, которая обеспечивает генерацию задач, вычисление их трудоёмкости, извлечение заданных вещественных векторов-признаков и сохранение их в базе размеченных данных. В экспери-
41
ментах генерировались задачи на 30 городах, расстояния между городами задавались целочисленными значениями от 1 до 3000. Множество размеченных данных включало 50000 индивидуальных задач с рассчитанными признаками.
Третий этап реализован на базе технологии машинного обучения – проверка прогнозной способности выбранного набора обобщающих характеристик заключается в выборе модели обучения, тренировки, тестирования и оценки качества функционирования прогнозной модели. В качестве моделей обучения были использованы [4]: Fast Tree, Fast Forest, Fast Tree Tweedie, Poisson Regression, Stochastic Dual Coordinate Ascent(SDCA), Generalized Additive Models(GAM). Все размеченные данные были разделены на две группы: обучающая (49000 задач) и контрольная (1000 задач). В качестве метрик оценки обучения были использованы следующие метрики [4]: R2 Score, Absolute Loss, Squared Loss, Root Square Mean Loss (RMS Loss).
Описанный инструментарий реализован на базе .NET Core Framework на языке C#. В качестве хранилища индивидуальных задач выбрана база данных PostgreSQL. Для обучения и тестирования моделей использована библиотека
ML .NET [4].
Результаты вычислительных экспериментов
Модель |
R2 Score |
Absolute Loss |
Squared Loss |
RMS Loss |
Fast Tree |
0,08 |
185,5 |
131802,8 |
363,04 |
|
|
|
|
|
Fast Forest |
0,0008 |
201,2 |
121731,6 |
348,9 |
|
|
|
|
|
Fast Tree Tweedie |
0,01 |
200,7 |
124135,5 |
352,3 |
|
|
|
|
|
Poisson Regression |
0,01 |
203,2 |
124071,0 |
352,2 |
|
|
|
|
|
SDCA |
-0,8 |
319,2 |
223762,8 |
473,03 |
|
|
|
|
|
GAM |
-0,06 |
209,3 |
129503,7 |
359,8 |
|
|
|
|
|
По результатам проведенных экспериментов (см. таблицу) в качестве модели обучения выбрана модель Fast Tree с абсолютной ошибкой 185,5. При тестировании обученной модели на 1000 примерах индивидуальной задачи коммивояжера точность предсказания составила 54%. Тестирование с использованием остальных моделей показывало результаты с точностью менее 50%.
В дальнейшем для увеличения точности предсказания вычислительной сложности индивидуальной задачи коммивояжера планируется прибегнуть к поиску и подбору комбинаций векторов-признаков, на которых обученная модель демонстрирует наибольшую достоверность прогноза.
Перспектива получения технологии выбора достоверных прогнозных моделей оценки трудоемкости труднорешаемых задач открывает широкий спектр возможностей как в теоретическом плане, так и в практическом направлении построения новых приближенных схем решения NP-трудных задач.
42
Литература
1.Little J.D.C., Murty K.G., Sweeney D.W., Karel C. An algorithm for the traveling salesman problem // Operation Research. 1963. №11. P. 792-989.
2.Knuth D.E. Estimating the efficiency of backtracking programs // Mathematics of Computing. 1975. V. 29. P.121-136
3.Головешкин, В.А. Вероятностный прогноз сложности индивидуальных задач коммивояжера на основе идентификации распределения сложности по экспериментальным данным / В.А. Головешкин, Г.Н. Жукова, М.В. Ульянов, М.И. Фомичев // Автоматика и телемеханика. 2018. № 7. C. 149–166.
4.Ресурсы по машинному обучению. Руководство по ML.NET. (web page). – https://docs.microsoft.com/ru-ru/dotnet/machine-learning (accessed April, 2019).
ФГБОУ ВО «Национальный исследовательский Нижегородский государственный университет им. Н.И. Лобачевского», Россия
УДК 681.3
Э.И. Воробьев, А.Н. Корякин
РАЗРАБОТКА АЛГОРИТМА ОБРАБОТКИ ВХОДЯЩИХ ОПОВЕЩЕНИЙ В ПОДСИСТЕМЕ МОНИТОРИНГА И АНАЛИЗА РАБОТЫ ОБОРУДОВАНИЯ
ВРАСПРЕДЕЛЕННОЙ СЕТИ ТЕЛЕКОММУНИКАЦИОННОЙ КОМПАНИИ
Встатье рассматриваются вопросы разработки и последующего улучшения алгоритма функционирования подсистемы оповещений в телекоммуникационной компании.
Каждая современная телекоммуникационная компания не может обходиться без подсистемы мониторинга и анализа работы оконечного оборудования своей сети. Такие системы обычно делятся на «Performance management» и
«Fault management». Performance management включает в себя централизованное отслеживание и использование метрик, полученных с отслеживаемого оборудования [1]. Fault management представляет из себя комплекс программных и аппаратных средств, предназначенных для выполнения действий в случаях отказа. Важнейшей частью подсистемы fault management является механизм оповещений, основная задача которого является довести до сведения системных инженеров о каких-либо аномалиях, произошедших на сети. Большинство современных мониторинговых систем имеют встроенный механизм оповещений.
Источниками оповещений могут являться как правила в Performance management, так и оповещения от внешних систем [2]. Кроме того, источником может являться само устройство, которое отсылает специальный пакет по протоколу SNMP, называемый SNMP-трап. Таким образом, подсистема может полу-
43
чить сразу несколько оповещений, говорящих об одной и той же проблеме. Итогом является то, что сетевой инженер, занимающийся анализом оповещений, будет получать несколько записей, что может вводить в заблуждение. Поэтому, необходимо разработать единый алгоритм обработки оповещений от всех систем, который будет способен отсекать дубликаты. Важно отметить, что некоторые подсистемы мониторинга умеют отправлять оповещения типа «очистка». Они предназначены для того, чтобы сказать внешней системе, что показатели, которые привели к появлению оповещения, вернулись в рамки нормы и проблема может считаться разрешённой в автоматическом режиме.
Очень часто разрешенные оповещения не удаляются из базы данных, а их помечают специальными полями, или перемещают в отдельную таблицу, хранящую историю оповещений.
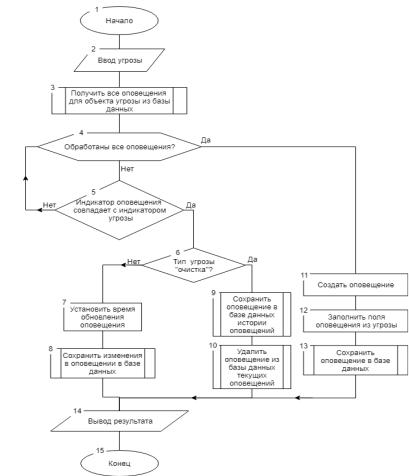
Алгоритм необходимо выполнять каждый раз при приходе оповещения перед добавлением его в базу данных. Разработанный алгоритм показан на рисунке.
Структурная схема алгоритма анализа входящих угроз
На рисунке показана схема, состоящая из 15 блоков. Входными данными для алгоритма является угроза. Ее ввод показан в блоке 2.
44