Контрольная работа: Побудова регресійної залежності хімічного складу і механічних властивостей сталі, оптимізація властивостей з використанням отриманої математичної моделі
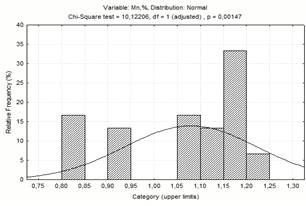
Рисунок 1.2 - Діаграма частотного
розподілу вмісту марганцю
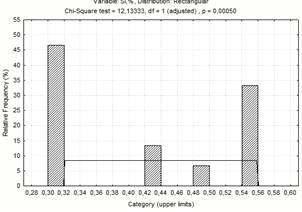
Рисунок 1.3 - Діаграма частотного
розподілу вмісту кремнію
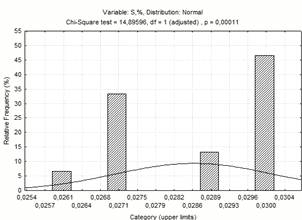
Рисунок 1.4 - Діаграма частотного
розподілу вмісту сірки
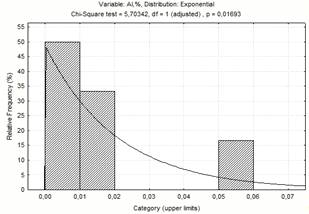
Рисунок 1.5 - Діаграма частотного
розподілу вмісту алюмінію
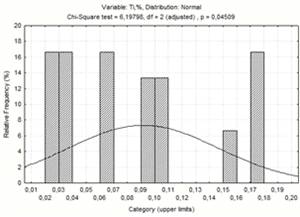
Рисунок 1.6 - Діаграма частотного
розподілу вмісту титану
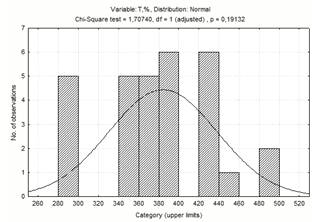
Рисунок 1.7 - Діаграма частотного
розподілу температури
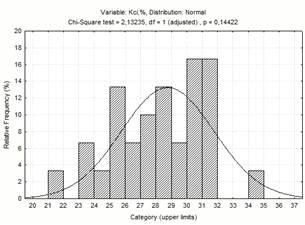
Рисунок 1.8 - Діаграма частотного
розподілу відносного звуження
2. Кореляційний аналіз
Кореляційний аналіз на етапі
попередньої обробки застосовують для визначення ступеня зв’язку факторів між
собою і з властивістю. Оцінка коефіцієнтів у рівнянні регресії методом
найменших квадратів вимагає незалежність факторів. У матеріалознавстві фактори
досить часто зв’язані між собою (наприклад, спільне введення легуючих добавок у
сталь у виді феросплавів). Сильна кореляція між факторами може привести до
перекручених оцінок впливу факторів на властивість (за рахунок взаємної
позитивної кореляції не впливові фактори можуть бути оцінені як впливові,
негативна кореляція взаємно компенсує вплив факторів на властивість). Тому для
вирішення питання про включення того чи іншого фактора в модель необхідно
виконати аналіз даних за допомогою програми кореляційного аналізу. Кількісною
характеристикою ступеня зв’язку в методі кореляційного аналізу с коефіцієнт
парної кореляції r
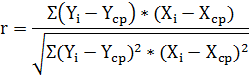
де r - коефіцієнт парної кореляції;ср, xср - середні значення по відповідним перемінним.
Спочатку підготуємо таблицю
кореляційного аналізу, у яку в процесі обчислень занесемо значення коефіцієнтів
парної кореляції (таблиця 2.1). Значимі коефіцієнти позначимо *.
Таблиця 2.1 - Таблиця кореляційного аналізу
|
|
C |
Mn |
Si |
S |
Al |
Ti |
T |
???? |
|
C |
1.00 |
-0.05 |
0.15 |
-0.23 |
-0.17 |
0.52* |
0.48* |
-0.29 |
|
Mn |
-0.05 |
1.00 |
0.61* |
-0.57* |
0.41* |
0.38* |
-0.13 |
0.11 |
|
Si |
0.15 |
0.61* |
1.00 |
-0.13 |
0.67* |
0.39* |
0.05 |
-0.12 |
|
S |
-0.23 |
-0.57* |
-0.13 |
1.00 |
-0.36* |
-0.66* |
0.06 |
-0.01 |
|
Al |
-0.17 |
0.41* |
0.67* |
-0.36* |
1.00 |
0.62* |
-0.16 |
-0.09 |
|
Ti |
0.52* |
0.38* |
0.39* |
-0.66* |
0.62* |
1.00 |
0.15 |
-0.20 |
|
T |
0.48* |
-0.13 |
0.06 |
-0.16 |
0.15 |
1.00 |
0.37* |
|
|
???? |
-0.29 |
0.11 |
-0.12 |
-0.01 |
-0.09 |
-0.20 |
0.37* |
1.00 |
Після розрахунку коефіцієнта парної кореляції необхідно перевірити його статистичну значимість. Для цього по таблиці критичних значень коефіцієнтів парної кореляції для обраного рівня надійності Р=0,95 і числа ступенів волі f=30-2=28 знаходять значення rтабл=0,30. Якщо |rрозр| ≥ rтабл, лінійний зв’язок між цими величинами є статистично значимий. Значимість коефіцієнта парної кореляції можна також перевірити по t - критерію Ст’юдента. Для цього обчислюють і порівнюють з табличним значенням критерію Ст’юдента для обраної надійності Р=0,95 і числа ступенів волі f=30-1=29. Маємо tтабл= 2,04.
Значення r лежать в
інтервалі -1...+1.Чим ближче r до ±1, тим сильніше ступінь лінійного зв'язку
між перемінними. Знак "-" (негативна кореляція) означає, що зі
збільшенням однієї перемінної інша буде зменшуватися. Знак "+" - зі
збільшенням однієї перемінної інша буде також зростати. При r = 1 між
перемінними існує функціональний зв'язок.
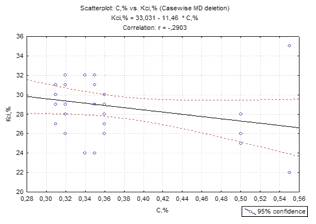
Рисунок 2.1 -
Графік зв’язку між вуглецем та відносного звуження
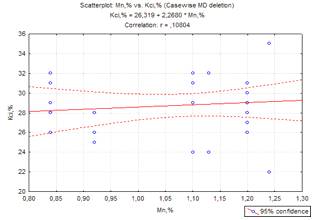
Рисунок 2.2 -
Графік зв’язку між марганцем та відносним звуженням
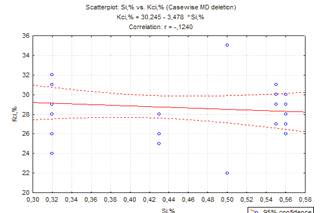
Рисунок 2.3 - Графік зв’язку між
кремнієм та відносним звуженням
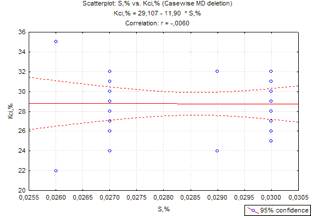
Рисунок 2.4 - Графік зв’язку між
сіркою та відносним звуженням
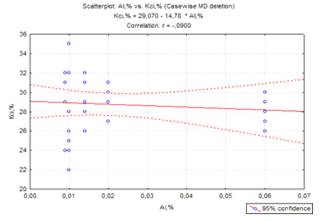
Рисунок 2.5 - Графік зв’язку між
алюмінієм та відносним звуженням
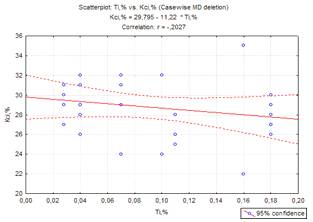
Рисунок 2.6 - Графік зв’язку між
титаном та відносним звуженням
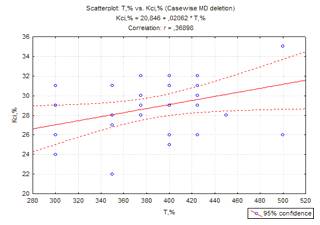
Рисунок 2.7 - Графік зв’язку між
температурою та відносним звуженням
Після перевірки
значимості за даними таблиці кореляційного аналізу будуємо граф кореляційних
зв'язків (рисунок 2.8). Для цього наносимо вершини графа - досліджувані фактори
і властивість, потім з’єднуємо відрізками ті вершини, між якими існує
статистично значимий зв'язок.
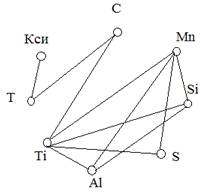
Рисунок 2.8 - Граф
кореляційних зв’язків
3. Розробка регресійної моделі
першого порядку
Розробку
регресійної моделі завжди починають з побудови лінійної моделі, що включає усі
фактори (крім виключених через взаємну кореляцію). Таку математичну модель
називають повною. Під повною регресійною моделлю першого порядку розуміють
залежність виду:
у= bo + b1x1 + b2x2
+ …… + bkxk ± ε
(2.1)
де к - число факторів;
ε - помилка пророкування моделі.
Задача регресійного аналізу полягає в розрахунку за результатами експериментів значень коефіцієнтів bi. Коефіцієнти розраховують на ЕОМ і одночасно зі значеннями коефіцієнтів одержують ряд статистичних характеристик, що описують рівняння в цілому, а також характеризують вплив факторів.
Статичні характеристики, що описують рівняння в цілому:- залишкова сума квадратів;
ε - стандартне відхилення моделі (інтервал відхилення від площини регресії,у якому з заданою надійністю лежать експериментальні значення властивості);- коефіцієнт детермінації, що показує, яка частина варіації властивості пояснюється моделлю (0-100%);- коефіцієнт множинної кореляції,що показує ступінь зв’язку факторів із властивістю. Його значення лежать в інтервалі 0-1,0;- критерій Фішеру моделі;- критерій Ст’юдента моделі, що лежить від R;
залишки - різниця експериментальних і розрахованих по рівнянню значень властивості.
Статичні характеристики, зв’язані з факторами:
∆bi - довірчий інтервал визначення і-го коефіцієнта;- коефіцієнт часткової кореляції.
Регресійний аналіз проводять у визначеній послідовності:
1 перевірка адекватності моделі;
2 перевірка статистичної значимості коефіцієнтів;
3 аналіз моделі і видача рекомендацій з оптимізації властивості.
Адекватність моделі перевіряють по F і t. Якщо Fpозр ≥ Fтабл, то модель є адекватною і її можна використовувати для подальшого аналізу. При аналізі адекватності перевагу варто віддавати F- критерію як більш чуттєвому.
Це означає, що, якщо модель
адекватна по t і неадекватна по F, модель варто вважати неадекватною. У нашому
випадку модель э адекватною, тому що 3.5595>2.6
Таблиця 3.1 - Модель першого порядку при N = 30Summary for Dependent Variable:= 0 ,72875340 R2 = 0,53108151R2 =0,38188018 F(7,22) = 3,5595<01038 Std.Error of estimate: 2,3693
|
Beta |
Std.Err. |
Patrial cor. |
B |
Std.Err. |
t (22) |
p-level |
|
Intercept |
|
|
139.00 |
90.739 |
1.53189 |
0.139803 |
|
C |
-3.83547 |
2.620490 |
-151.46 |
103.484 |
-1.46365 |
0.157433 |
|
Mn |
-1.95888 |
1.781274 |
-41.12 |
37.395 |
-1.09971 |
0.283349 |
|
Si |
3.10465 |
2.626484 |
87.06 |
73.649 |
1.18206 |
0.249802 |
|
S |
-1.12001 |
0.817872 |
-2217.26 |
1619.128 |
-1.3642 |
0.184687 |
|
Al |
-4.29518 |
3.399339 |
-704.93 |
557.906 |
-1.26353 |
0.219623 |
|
Ti |
3.16689 |
2.636016 |
175.32 |
145.928 |
1.20139 |
0.242374 |
|
T |
0.71229 |
0.169652 |
0.04 |
0.009 |
4.19851 |
0.000372 |
Рівняння повної моделі першого
порядку має вигляд:
????
= 139,00 - 151,46C - 41.12Mn + 87.06Si - 2217.26S -704.93Al +175.32Ti+ 0.04T ±
2.3693
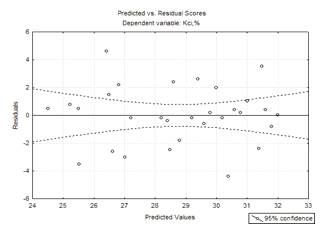
Рисунок 3.1 - Графік
експериментальних значень та залишків для початкової моделі
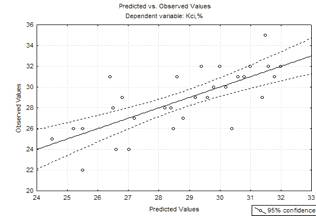
Рисунок 1.2 - Графік
експериментальних та отриманих значень для початкової моделі
Для підвищення якості і вiрогiдностi розробленої моделi необхiдно проаналiзувати залишки - рiзницю мiж експериментальними i розрахованими по моделi значеннями властивостi.
Значення залишкiв повиннi задовольняти наступним вимогам:
- сума залишків повинна дорівнювати нулю. За знаком і величиною відхилення суми від нуля можна визначити розташування поверхні відгуку об'єкта щодо площини регресії. Якщо сума залишків більше нуля, поверхня лежить вище площини регресії, якщо менше нуля - то нижче. Це задовольняє визначити вид перетворення для значень властивості;
- значення ????ехсп - ????розр повинні корелювати між собою. Чим більше коефіцієнт парної кореляції між ними, тим точніше модель відображає результати експерименту;
- значення залишків повинні мати нормальний закон розподілу.
Далі з моделі першого порядку виключили 12й дослід, отримали модель для 29 дослідів. Після чого статистичні характеристики моделі підвищились:Summary for Dependent Variable:= 0,79661372 R2=0 ,63459342R2= 0,51279123 F(7,21)=5,2100<,00147 Std.Error of estimate: 2,1196
Потім видалили 7 дослід, отримали модель для 28 дослідів. Статистичні характеристики моделі також підвищились:Summary for Dependent Variable= 0,83521759 R2= 0,697588 42R2= 0,59174437 F(7,20)=6,5907<,00041 Std.Error of estimate: 1,9320
Далі видалили 9й дослід, отримали модель для 27 дослідів. Статистичні характеристики моделі значно підвищились:Summary for Dependent Variable=0 ,86101418 R2=0 ,74134542R2=0 ,64605162 F(7,19)=7,7796<,00017 Std.Error of estimate: 1,8075
Після цього видалили 5й дослід,
отримали модель для 26 дослідів. Внаслідок послідовного виключення деяких
дослідів модель стала ще кращою, її статистичні характеристики значно
підвищилися. А саме вона має більший критерій Фішеру 10,074 >3.5595 і
коефіцієнт множинної кореляції 0,89254985>0.79661372.
Таблиця 3.2 - Статистичні характеристики покращеної моделі першого порядку N=26Summary for Dependent Variable:= 0,89254985 R2= 0,79664523R2=0 ,71756282 F(7,18)=10,074<,00004 Std.Error of estimate: 1,6462
|
|
Beta |
Std.Err. of Beta |
Patrial. Cor. |
B |
Std.Err. of B |
t (18) |
p-level |
|
intercept |
|
|
|
-13.4691 |
71.071 |
-0.189516 |
0.851809 |
|
C |
0.085723 |
1.938752 |
0.010421 |
3.5087 |
79.354 |
0.044216 |
0.965219 |
|
Mn |
0.856137 |
1.236334 |
0.161088 |
20.1562 |
29.107 |
0.692480 |
0.497473 |
|
Si |
-0.917305 |
1.984998 |
-0.108282 |
-26.0696 |
56.413 |
-0.462119 |
0.649533 |
|
S |
0.134078 |
0.616939 |
0.051157 |
272.3130 |
1253.010 |
0.21327 |
0.830398 |
|
Al |
0.767979 |
2.688286 |
0.067182 |
121.6505 |
425.834 |
0.285676 |
0.778388 |
|
Ti |
-0.547542 |
1.965603 |
-0.065517 |
-30.8925 |
110.900 |
-0.278562 |
0.783756 |
|
T |
0.893194 |
0.118105 |
0.872135 |
0.0582 |
0.008 |
7.562685 |
0.000001 |
Після виключення деяких дослідів
повна модель першого порядку має вигляд:
????
= -13.4691+3.5087C+20.1562Mn - 26.0696Si + 272.3130S + 121.6505Al - 30.8925 +
0.0582 ± 1.6462
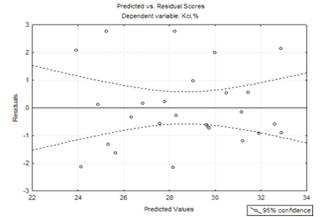
Рисунок 3.3 - Графік
експериментальних значень та залишків кінцевої моделі першого порядку
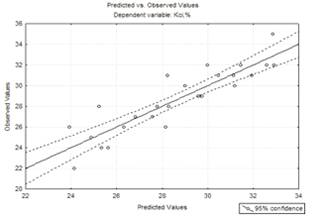
Рисунок 3.4 - Графік
експериментальних та отриманих значень для кінцевої моделі першого порядку
Проранжуємо фактори, розташувавши їх
у порядку зменшення ступеня впливу на властивість. Для цього побудуємо
гістограми ранжирування, на яких розташуємо фактори у порядку зменшення
коефіцієнтів у кодовому масштабі b, які
характеризують ступінь впливу фактора на властивість, і коефіцієнтів часткової
кореляції rxy, що характеризують ступінь зв’язку фактора та властивості і у
деякій мірі доповнюють коефіцієнти у кодовому масштабі. Гістограми ранжирування
представлені на рисунках 2.5 і 2.6.
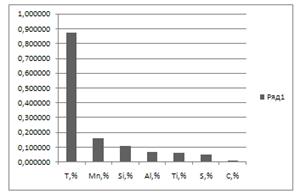
Рисунок 2.5 - Гістограма
ранжирування факторів за коефіцієнтом часткової кореляції для покращеної моделі
першого порядку.
. Розробка регресійної моделі
другого порядку
У матеріалознавстві в більшості випадків більш точно результати експерименту описують нелінійні моделі. Обмежимося неповною моделлю другого порядку.
Ефекти взаємодії
вибирають на пiдставi знань про об’єкт дослідження, з урахуванням графа
кореляційних зв'язків обираємо ефект взаємодії між та Т і С. При перемноженні
модель адекватна (Fрозр>Fтабл).
Таблиця 4.1 - Статистичні характеристики вихідної моделі другого порядку
Regression Summary for Dependent Variable:=0 ,77979743 R2=0 ,60808403R2=0 ,45878271 F(8,21)=4,0729<,00462 Std.Error of estimate: 2,2170
|
|
Beta |
Std.Err. of Beta |
Patrial. Cor. |
B |
Std.Err. of B |
t (21) |
p-level |
|
intercept |
|
|
|
172.38 |
86.483 |
1.99328 |
0.059383 |
|
C |
-5.95304 |
2.664471 |
-0.438238 |
-235.09 |
105.221 |
-2.23423 |
0.036470 |
|
Mn |
-1.94420 |
1.666803 |
-0.246669 |
-40.82 |
34.992 |
-1.16642 |
0.256520 |
|
Si |
3.07456 |
2.457719 |
0.263350 |
86.21 |
68.916 |
1.25098 |
0.224700 |
|
S |
-1.14674 |
0.765419 |
-0.310747 |
-2270.19 |
1515.287 |
-1.49819 |
0.148966 |
|
Al |
-4.28549 |
3.180859 |
-0.282062 |
-703.34 |
522.049 |
-1.34728 |
0.192250 |
|
Ti |
3.19717 |
2.466638 |
0.272169 |
176.99 |
136.552 |
1.29617 |
0.208983 |
|
T |
-0.68426 |
0.705614 |
-0.207028 |
-0.04 |
0.039 |
-0.96973 |
0.343218 |
|
T-C |
3.04375 |
1.498452 |
0.405232 |
0.20 |
0.099 |
2.03126 |
0.055077 |