Материал: Портянкин И. Swing
Уход за деревьями |
455 |
}
// создаем стандартную модель return new DefaultTreeModel(root);
}
// этот слушатель следит за изменением выделения class SelectionL implements TreeSelectionListener { public void valueChanged(TreeSelectionEvent e) {
//получаем источник события — дерево
JTree tree = (JTree)e.getSource();
//добавленные/удаленные пути
TreePath[] paths = e.getPaths(); log.append("Изменено путей: " +
paths.length + "\n");
//выделенные элементы и их номера строк
TreePath[] selected = tree.getSelectionPaths(); int[] rows = tree.getSelectionRows();
//последние элементы в пути
for (int i=0; i<selected.length; i++) { log.append("Выделен: " +
selected[i].getLastPathComponent() + " на строке: " + rows[i] + "\n");
}
// полная информация о пути в дереве if ( selected.length > 0 ) {
TreePath path = selected[0]; Object[] nodes = path.getPath();
for (int i=0; i<nodes.length; i++) { // путь состоит из узлов
DefaultMutableTreeNode node = (DefaultMutableTreeNode)nodes[i];
log.append("Отрезок пути " + i + " : " + node.getUserObject() + " ");
}
}
log.append("\n");
}
}
public static void main(String[] args) { SwingUtilities.invokeLater(
new Runnable() {
public void run() { new TreeSelectionModes(); } });
456 |
ГЛАВА 15 |
}
}
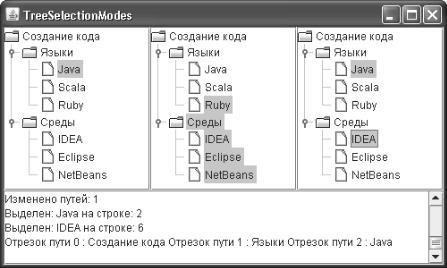
Итак, в примере мы создаем окно, в котором разместится три дерева, каждое со стандартной моделью выделения, но с разным режимом работы этой модели. Для дерева JTree необходимо предоставить данные для отображения, чтобы было что выделять, так что в методе createTreeModel() мы создаем простую модель с корнем и двумя потомками, к которым присоединяются листья, хранящиеся для удобства в массивах. Здесь все просто, фактически повторяется пример для стандартной модели дерева, рассмотренный в предыдущем разделе. Полученную модель мы будем разделять между нашими видами — тремя деревьями, так что в них мы увидим одинаковые данные. В этом примере гораздо интереснее не данные, а то, как эти данные можно выделять. Создав на основе модели первое дерево, мы меняем режим выделения его узлов. Для этого нужно получить используемую деревом модель выделения (методом getSelectionModel()) и сменить режим выделения (методом setSelectionMode()). Три возможных режима выделения узлов дерева описаны константами интерфейса TreeSelectionModel, для первого дерева мы выбираем режим SINGLE_TREE_SELECTION, позволяющий выделить только один узел за один раз.
Точно так же мы поступаем и со вторым деревом, устанавливая для него режим CONTIGUOUS_TREE_SELECTION. Этот режим допускает выделение произвольного количества узлов дерева, но только с одним условием: выделяемые узлы дерева должны следовать один за другим без перерывов. Как только пользователь попытается выделить узел, не входящий в непрерывный интервал выделения, все выделение сбросится, и выбранным останется только один узел.
Никто не запрещает нам создавать стандартную модель выделения напрямую и передавать ее затем в метод setSelectionModel() класса JTree. Так мы и делаем для третьего дерева в примере, устанавливая для него режим выделения DISCONTIGUOUS_TREE_SELECTION. Кстати, мы могли этого и не делать, такой режим выделения является для стандартной модели режимом по умолчанию. Режим этот очень прост: пользователь может выделять любое количество узлов в любом порядке, как ему заблагорассудиться. К третьему дереву мы присоединяем слушателя событий от модели выделения TreeSelectionListener, который позволит нам быть постоянно в курсе того, что выделяет в дереве пользователь.

Уход за деревьями |
457 |
Но о слушателе событий чуть позже, а пока нам остается только вывести наши деревья на экран и оценить различные режимы выделения. Для размещения трех деревьев используется панель с табличным расположением GridLayout, разделенная на три ячейки одинакового размера. В этих ячейках размещаются панели прокрутки с деревьями. Кроме того, на юг окна помещается многострочное текстовое поле JTextArea c названием log, в него мы будем записывать сообщения о событиях, поступающих слушателю событий от модели выделения. Запустив программу с примером и пробуя выделять различные узлы деревьев (дополнительные режимы выделения доступны при нажатых управляющих клавишах Ctrl и Shift), вы легко увидите разницу в режимах выделения и сможете выбрать для своего дерева тот режим, который вам больше всего подходит.
Ну а теперь о том, как с помощью слушателей TreeSelectionListener следить за всеми изменениями в выделенных элементах дерева JTree. Присоединить слушателя можно как к модели выделения, так и к самому дереву JTree. Это почти одно и то же, разница лишь в том, что именно будет возвращать метод getSource() в ответ на события. В первом случае он вернет нам ссылку на модель выделения, в которой произошло изменение, а во втором — ссылку на само дерево. В классе JTree дублируются все методы модели выделения (они просто делегируют ей свои вызовы), кроме того, в классе JTree есть несколько весьма полезных методов, способных упростить работу с выделенными элементами дерева, так что, как правило, лучше присоединять слушателя непосредственно к дереву. Мы так и поступаем. Наш слушатель описан во внутреннем классе SelectionL. Каждый раз при изменении в выделенных узлах дерева вызывается метод слушателя valueChanged(). Параметр этого метода — объект TreeSelectionEvent. Он позволяет получить, во-первых, как и в случае c любым событием, источник события (у нас это дерево JTree), во-вторых, список путей узлов, которые были затронуты при смене выделения (методом getPaths()). Обратите внимание, что этот метод не позволяет получить выделенные в данный момент узлы дерева, он всего лишь содержит список изменившихся в последний раз узлов. Например, если у вас в дереве уже выделено с десяток узлов, и пользователь решает прибавить к ним еще один, данный метод вернет только один путь для нового выделенного узла, так как остальные при этом не изменятся. Вы сможете убедиться в этом, запустив программу с примером и при выделении новых узлов отслеживая (в текстовом поле), сколько путей возвращает данный метод.
Гораздо удобнее узнавать обо всех выделенных в данный момент узлах с помощью метода getSelectionPaths(), который есть и в модели выделения, и в дереве (метод дерева просто обращается к модели выделения). Данный метод возвращает массив объектов-путей TreePath ко всем выделенным в данный момент узлам дерева. Как вы помните, мы уже отмечали, что путь TreePath — это список узлов, начиная с корня, по которым надо пройти для достижения определенного узла. В случае стандартной модели (как в нашем примере) путь состоит из списка объектов-узлов TreeNode. Как правило, весь путь к выделенному узлу требуется знать редко, чаще всего достаточно информации о самом выделенном узле. Для получения этой информации служит метод getLastPathComponent(), возвращающий последний узел в пути (это собственно и есть выбранный узел). Кроме того, вы можете работать со строками, а не с путями. Поскольку дерево на экране отображается последовательно (корень, потомки в порядке добавления, их потомки также в порядке добавления), можно подсчитать, на какой строке находится тот или иной узел3. Получить номера строк выделенных узлов позволяет метод getSelectionRows(). Однако у строк есть недостаток: при свертывании или развертывании узлов дерева их номера меняются, даже если не меняются выделенные элементы, и ваша информация устаревает. Все же удобнее пользоваться
3 Переводом узлов дерева в строки на экране занимается специальный объект, ассоциированный с моделью выделения и реализующий интерфейс RowMapper. Он работает за кулисами деревьев, так что подробно разбираться в нем необязательно.

458 |
ГЛАВА 15 |
путями TreePath, но номера строк могут быть достойной альтернативой. Вы также сможете увидеть их в текстовом поле log.
Ну и напоследок мы полностью исследуем путь TreePath первого выделенного элемента. Обратите внимание, что прежде чем получать пути, необходимо удостовериться, что массив, возвращаемый методом getSelectionPaths(), их вообще содержит. В то время как сам массив никогда не станет пустой ссылкой null, элементов в нем может и не быть, что необходимо учитывать (такое событие возникает, когда пользователь сбрасывает выделение в дереве). Анализировать путь проще всего с помощью метода getPath(), возвращающего массив узлов, начиная с корня, ведущих к нужному нам узлу. Так как мы используем стандартную модель и данные узлов у нас хранятся в объектах DefaultMutableTreeNode, мы можем смело преобразовывать узлы, из которых состоит путь, к данному типу. Данные всех узлов, составляющих путь, мы получаем методом getUserObject() и выводим в текстовое поле, так что вы сможете своими глазами убедиться в том, что путь начинается от корня и постепенно приводит нас к выделенному узлу.
Впечатляющая часть методов класса JTree посвящена именно работе с выделенными элементами, так что пользоваться можно не только интерфейсом модели выделения и методом getSelectionPaths(). Составим небольшую таблицу наиболее полезных методов класса JTree для работы с выделением, в случае необходимости вы сможете обращаться к ней как к простому справочнику (табл. 15.2).
Таблица 15.2. Методы класса JTree для работы с выделением
Методы |
Описание |
add(set)SelectionPath(s), |
На самом деле данные методы принадлежат модели выделения |
add(set)SelectionRow(s) |
TreeSelectionModel дерева и позволяют программно прибавлять к вы- |
|
деленным узлам новые. Но если вам захочется забыть о моделях, |
|
Swing позволит это сделать, как будто их вовсе нет: все методы моде- |
|
ли выделения есть и в классе самого дерева JTree |
clearSelection() |
Сбрасывает все выделенные в данный момент узлы дерева, так что |
|
выделенного в нем ничего не остается |
getMinSelectionRow(), |
Удобные методы при работе с узлами дерева по номерам строк: пер- |
getMaxSelectionRow() |
вый метод возвращает номер первой выделенной строки (минималь- |
|
ный), а второй номер последней выделенной строки (максимальный) |
isPathSelected(), |
Эта пара методов позволяет без труда выяснить, выделен ли некото- |
isRowSelected() |
рый узел в дереве (он может быть задан путем TreePath или номером |
|
строки) |
Внешний вид деревьев
Мы узнали, как подготавливать и настраивать модель данных дерева для вывода данных на экран и как работать с выделенными узлами. Теперь было бы неплохо познакомиться с тем, как дерево позволяет настраивать свой внешний вид и внешний вид своих узлов. Нетрудно догадаться, что все полностью находится в ваших руках, как и принято в Swing. Работу по отображению узлов дерево JTree выполняет не само, оно переадресует ее специальному отображающему объекту (renderer), который должен реализовывать несложный интерфейс TreeCellRenderer. Создавая необходимый отображающий объект и учитывая в нем особенности узлов вашего дерева, вы сможете расцветить его всеми возможными цветами и украсить любыми значками.
У вас также остаются общие унаследованные от базового класса JComponent библиотеки Swing свойства, такие как font или foreground, которые мы не раз уже обсуждали при рассмотрении различных компонентов Swing. Они позволят быстро сменить используе-
Уход за деревьями |
459 |
мые деревом шрифты и цвета для всех узлов дерева разом. Это не самый гибкий подход, но иногда его оказывается достаточно.
Интерфейс отображающего объекта TreeCellRenderer на самом деле чрезвычайно прост. В нем определен всего один метод getTreeCellRendererComponent(), который обязуется возвратить некоторый графический компонент для переданных ему в качестве параметров дерева JTree, узла для отображения и дополнительных свойств узла (эти свойства определяют, выделен ли узел, раскрыт или свернут, лист ли это, владеет ли он фокусом ввода). Этот графический компонент и служит для отображения деревом узла. Используется данный компонент точно так же, как и в случае со списками JList, которые мы изучали в главе 11: он не добавляется на экран и остается незамеченным для графической системы, дерево задействует его как особую «кисть», вызывая метод paint() компонента в том месте, где располагается отображаемый в данный момент узел. Поэтому создавать новый компонент для каждого отображаемого узла не только не нужно, но и крайне расточительно и неэффективно. Компонент требуется один, для каждого узла просто меняются свойства этого компонента4.
По умолчанию в дереве JTree используется стандартный отображающий объект
DefaultTreeCellRenderer из пакета javax.swing.tree. Он унаследован от надписи JLabel и для каждого узла возвращает соответствующим образом настроенный (с подходящими текстом и значком) единственный экземпляр самого себя, то есть надписи. Этот экземпляр и служит для отображения всех узлов дерева. При этом объект DefaultTreeCellRenderer старается максимально оптимизировать прорисовку узлов дерева, в частности, он отключает все стандартные механизмы надписи JLabel, например, оповещение об изменении надписи и значка (это привязанные свойства JavaBeans) и автоматическую проверку корректности надписи. Учитывая, сколько узлов приходится отображать в больших деревьях, подобная оптимизация приходится весьма кстати.
Возникает резонный вопрос: «В дереве могут храниться данные любых типов, как их отображает стандартный объект?». Интересно, что для преобразования узла в строку, которая будет выведена на экран, стандартный отображающий объект не вызывает напрямую метод toString(), как это делает, к примеру, стандартный отображающий объект списка JList, а применяет особый метод класса JTree с названием convertValueToText(). По умолчанию данный метод просто вызывает для узла метод toString(), но его можно переопределить и по-своему обрабатывать преобразование узла в строку. Иногда это проще, чем написание нового отображающего объекта.
Объект DefaultTreeCellRenderer способен не только на отображение текста узла со стандартными значками. Как оказывается, его можно довольно тонко настроить, и во многих ситуациях этого оказывается достаточно, чтобы ваше дерево приняло именно тот внешний вид, который необходим приложению. При этом не стоит забывать, что стандартный отображающий объект унаследован от надписи JLabel, а, значит, вы смело можете использовать в тексте узла язык HTML, начиная его с «волшебной» комбинации символов <html>. Уже одно это дает вам прекрасные возможности для получения текста различных размеров, цветов и начертаний буквально одним мановением руки. Более того, легко можно сменить значки, необходимые для вывода узлов, и еще некоторые свойства (табл. 15.3).
Таблица 15.3. Свойства стандартного отображающего объекта дерева
Свойства |
Описание |
font |
Задает шрифт, который будет использоваться отображающим |
|
объектом для вывода узлов. Того же эффекта можно добиться |
|
сменой свойства font самого дерева JTree |
4 Это ярко выраженный шаблон проектирования приспособленец, упомянутый нами в главе 11, когда мы в первый раз столкнулись с отображающими объектами.