Курсовая работа (т): Системы программирования
А1: Знак_числа := Знак
А2: Целое := Целое*10 + Цифра
А3: Если Знак_числа = «-» то Целое := -Целое Все-если
б) Диагностические сообщения:
Д1: «Строка не является десятичным числом»;
Д2: «Два знака рядом»;
Д3: «В строке отсутствуют цифры»;
Д4: «В строке встречаются недопустимые символы»
Обозначим: S - строка на входе автомата; Ind - номер очередного символа; q - текущее состояние автомата; Table - таблица, учитывающая символы завершения и другие символы.
Тогда алгоритм сканера-распознавателя можно представить следующим образом.
:= 1:= 1
Выполнить А0
Цикл-пока q ¹≠ «Е» и q ¹≠ «К»
Если S[Ind] = «+» или S[Ind] = «-»,
то j := 1
иначе Если S[Ind] ³ ≥«0» и S[Ind] ≤«9»,
то j := 2,
иначе j := 3
Все-если
Все-если
Выполнить Ai := Table [q, j]. A():= Table [q, j]:= Ind +1
Все-цикл
Если q = «К»
то Выполнить А3
Вывести сообщение «Это число»
иначе Вывести сообщение Дi
Все-если
Синтаксический анализатор
YACC - компьютерная программа, служащая стандартным генератором синтаксических анализаторов (парсеров) в Unix-системах. Название является акронимом «Yet Another Compiler Compiler» («ещё один компилятор компиляторов»). Yacc генерирует парсер на основе аналитической грамматики, описанной в нотации BNF (форма Бэкуса-Наура) или контекстно-свободной грамматики. На выходе yacc выдаётся код парсера на языке программирования Си.
Yacc отображает файл спецификаций в процедуру на языке C, которая разбирает входной текст в соответствии с заданной спецификацией. Алгоритм же самого разбора относительно прост, знание его облегчит понимание механизма нейтрализации ошибок и обработки неоднозначностей.
Построение синтаксических анализаторов.
Синтаксические анализаторы регулярных языков на вход получают строку лексем. Пример. Синтаксический анализатор списка описания целых скаляров, массивов и функций (упрощенный вариант), например: int xaf, y22[5], zrr[2][4], re[N], fun(), *g;
После лексического анализа входная строка представлена в алфавите:- идентификатор; N - целочисленная константа; служебные символы: ≪[ ] ( ) , ; *».
Функцию переходов зададим синтаксической диаграммой (рис. 4).
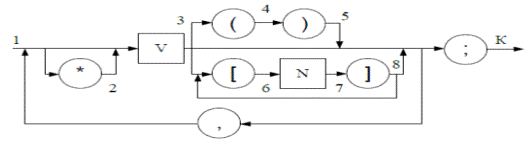
Рисунок 4.
По диаграмме построим таблицу автомата (рис. 5).
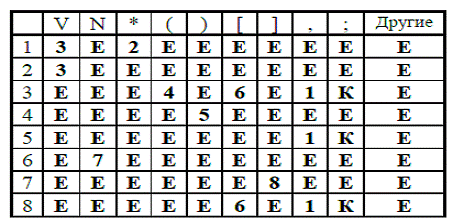
Рисунок 5.
Алгоритм распознавателя:
:= 1:= 1
Цикл-пока q ¹≠ «Е» и q ¹ ≠«К»
q := Table [q, Pos(S[Ind], «VN*()[];»)] := Ind +1
Все-цикл
Если q = «К»
то Выполнить А3
Вывести сообщение «Это число»
иначе Вывести сообщение Дi
Все-если
Глава 4. Домашняя работа №4
Описание лексики LEX
для языка Си
Генерируется программа lex.yy.c. Будучи загруженной с библиотекой, она для каждой распознанной цепочки выполняет соответствующие С-операторы, а остальные фрагменты входного файла копирует в выходной файл без изменений.
Разрабатываемый язык относится к разделу Си подобных языков, код
регистрозависим. Правильная программа на данном языке представляет собой
непустой список функций. Точкой входа в программу считается функция с название main. Функция состоит из имени функции,
списка параметров и тела. Тело функции является набором операторов. Операторы
разграничиваются с помощью разделителя “;”. Операторы объединяются в блоки с
помощью фигурных скобок.
Обозначения:
[ ] - необязательная часть
… - часть, повторяющаяся произвольное количество раз
< > - описание конструкции
<Б>|<Ц>|<пБ>|<пЦ>|<пБЦ> - буква | цифра | последовательность букв | последовательность цифр | последовательность букв и/или цифр или пусто
<И> - <имя объекта>
<В> - <выражение>
<ЛВ> - <ЛогическоеВыражение>
<ОБ> - <ОператорИлиБлок> (<О> - одиночный оператор)
<К> - <константа>
Язык различает следующие типы данных:
|
Название типа |
Псевдонимы типа |
|
number |
|
|
real |
|
|
char |
chara, charac, charact, character, character |
|
bool |
|
|
data |
|
Основными конструкциями языка являются:
|
Завершение функции и возврат значения |
return <значение> |
|
Cоздание/уничтожение экземпляров объектов |
create, kill |
|
Оператор присваивания |
<И><= <В> ; |
|
Условный оператор |
when <ЛВ> then <ОБ> [else <ОБ>]; |
|
Переключатель |
with <В> {?<К>:<ОБ> …} |
|
Оператор цикла |
repeat <ОБ> when <ЛВ> |
|
Вызов функции |
<ИМЯ_ФУНКЦИИ>(<ПАРАМЕТРЫ>) |
Используемые арифметические операторы:
|
+сложение |
|
|
- |
вычитание |
|
/ |
деление |
|
* |
умножение |
|
% |
остаток от деления |
Операторы сравнения:
|
== |
равенство |
|
< |
меньше |
|
> |
больше |
|
=< |
меньше-равно |
|
=> |
больше-равно |
|
<> |
неравенство |
Логические операторы:
|
! |
Инверсия |
|
^ |
Кольцевая сумма |
|
| |
Побитовое сложение |
|
& |
Побитовое умножение |
|
|| |
Или |
|
&& |
И |
Константы могут быть целыми, вещественными, символьными (с экранированием служебных символов).
Незначащие символы - символы языка, разбивающие текст программы на лексемы: символ пробела, перевода строки, табуляции и возврата каретки.
Комментарии - не оказывают влияние на код программы и используются только для удобства программиста. Комментарии могут быть двух видов:
строчные:
· //<произвольный набор символов>\r\n (занимают одну строку);
блочные:
· /*<произвольный набор символов>*/(могут занимать любое число строк). Вложенные блочные комментарии не поддерживаются.
Идентификаторы и объекты могут определяться в любом месте программы, причем идентификаторы и имена объектов объявление вне объявления функций являются глобальными, например:
i;check(numbers j)
{
return (i+j);
}
Язык является объектно-ориентированным. Объекты определяются следующей
конструкцией:
{
<тип> <имя идентификатора>;
<тип> <имя метода>(<список параметров>);
}
Точка входа в программу определяется функцией main0.
В ходе выполнения лабораторных работ была разработана система регулярных
выражений, а также классы и действия для расширения лексического акцептора, до
анализатора.
|
Имя автомата |
Имя группы слов |
Регулярное выражение |
Действие |
Примечание |
|
main |
brakes |
[(){}] |
tables.processBraket(Lexem); |
Скобки |
|
main |
charSt |
['] |
ignoreLastWord=true;stack.push(lexAcceptor);lexAcceptor=lexAcceptors[findAutomat("CharB")]; |
Обнаружен символ |
|
main |
conditionOper |
[<>=]+ |
tables.processOperator(Lexem); |
Операторы сравнения, присваивания |
|
main |
fifth |
[0-4]+"#5" |
tables.base5ToBase10(Lexem); tables.processConst(Lexem, typeInt); |
пятеричка |
|
main |
float |
([0-9]+[.][0-9]*)|([0-9]*[.][0-9]+) |
tables.processConst(Lexem, typeDouble); |
десятичное |
|
main |
id |
[a-zA-Z]+[0-9] |
tables.processIdent(Lexem, -1); |
идентификатор |
|
main |
int |
[0-9]+ |
tables.processConst(Lexem, typeInt); |
целое |
|
main |
keyword |
([a-zA-Z]+)|([?:]) |
ti.put(0,"keyword");tables.CheckForAlias(Lexem);tables.processKeyword(Lexem); ti.put(Lexem.groupIndex, Lexem.textOfWord); |
|
|
main |
logicalOper |
[&|^!]+ |
tables.processLogicalOper(Lexem); |
Логические операторы |
|
main |
separator |
[,;.] |
|
|
|
main |
sign |
[-+*/%] |
|
Знаки операций |
|
main |
space |
[ \n\r\t]+ |
ignoreLastWord = true; tables.debugGroupWordEndln(Lexem); |
|
|
CharB |
char |
other |
lexAcceptor=lexAcceptors[findAutomat("CharE")];tables.processConst(Lexem, typeChar); |
Символ! |
|
CharB |
ekr |
[\\] |
ignoreLastWord=true;lexAcceptor=lexAcceptors[findAutomat("CharEk")]; |
Символ экранируется! |
|
CharB |
empty |
['] |
Lexem.groupIndex=codeCharError; ti.put(0,"char error"); |
Пустой символ, не верно! |
|
CharEk |
CharError1 |
other |
Lexem.groupIndex=codeCharError;ti.put(0,"char error"); |
|
|
CharEk |
char |
[\\nt0'] |
lexAcceptor=lexAcceptors[findAutomat("CharE")]; Lexem.textOfWord=new StringBuffer("\\"+Lexem.textOfWord.toString());tables.processConst(Lexem, typeChar); |
Список экранируемых символов |
|
CharE |
CharError2 |
other |
Lexem.groupIndex=codeCharError;ti.put(0,"char error"); |
Неверный конец символа |
|
CharE |
Exit |
['] |
ignoreLastWord=true;lexAcceptor=(fAutomat)stack.pop(); |
Конец символа |
Краткое описание функций интерфейсного класса
|
void CheckForAlias(lexem Lex) |
Служебная функция для замены псевдонимов типов (boole, boolea, boolean -> bool и т.д.) |
|
public boolean isBoolConst(lexem Lex) |
Служебная функция для разрешения конфликта пересечения групп ключевых слов и булевских констант |
|
public int isKeyWord(lexem Lex) |
Служебная функция проверки на принадлежность к ключевым словам |
|
public int processIdent(lexem Lex, int type) |
Функция обработки идентификаторов и занесения их в таблицу при необходимости |
|
public int processConst(lexem Lex, int type) |
Функция обработки констант и занесения их в таблицу при необходимости |
|
public int processKeyword(lexem Lex) |
Функция обработки ключевых слов и занесения их в таблицу при необходимости |
|
public int processOperator(lexem Lex) |
Функция обработки операторов сравнения и присваивания (разрешение конфликтов) |
|
public int processLogicalOper(lexem Lex) |
Функция обработки логических операторов (разрешение конфликтов) |
|
public void base5ToBase10(lexem Lex) |
Служебная функция перевода из системы счисления по основанию 5 в систему счисления по основанию 10 |
|
public String getIdentTable() public String getConstTable() public String getKeywordTable() |
Служебные функции для вывода таблиц |
|
public void debugGroupWordFill(lexem Lex) public void debugGroupWordEndln(lexem Lex) public String debugGroupWordGet() |
Служебные функции для построения отладочного представления программы в виде токенов (групп слова, индекс слова) |
|
determinateGroupIndex |
Функция, создающая ассоциативный массив имен групп слов и индексов этих групп |
|
debugGroupName |
Служебная функция для вывода таблице построенной на основе массива соответствия имен и индексов групп |
Встроенные переменные:
1) yytext[] - одномерный массив (последовательность символов), содержащий фрагмент входного текста, удовлетворяющего регулярному выражению и распознанного данным правилом;
2) yyleng - целая переменная, значение которой равно количеству символов, помещенных в массив yytext.
Встроенные переменные позволяют определить конкретную последовательность
символов, распознанных данным правилом. При применении правила анализатор lex автоматически заполняет значениями
встроенные переменные. Эти значения можно использовать в действии примененного
правила.
Пример правила:
[a-z]+ printf(“%s”,yytext);
Регулярное выражение правила определяет бесконечное множество последовательностей символов, состоящих из букв латинского алфавита. Данное правило применяется, когда из входного потока символов поступает конкретная последовательность символов, удовлетворяющих его регулярному выражению. Оператор языка С printf выводит в выходной поток эту последовательность символов.
Встроенные функции:
1) yymore(). В обычной ситуации содержимое yytext обновляется всякий раз, когда производится применение некоторого правила. Иногда возникает необходимость добавить к текущему содержимому yytext цепочку символов, распознанных следующим правилом;
2) yymore() вызывает переход анализатора к применению следующего правила. Входная последовательность символов, распознанная следующим правилом, будет добавлена в массив yytext, а значение переменной yyleng будет равно суммарному количеству символов, распознанными этими правилами;
3) yyless(n). Оставляет в массиве yytext первые n символов, а остальные возвращает во входной поток. Переменная yyleng принимает значение n. Лексический анализатор будет читать возвращенные символы для распознавания следующей лексемы. Использование yyless(n) позволяет посмотреть правый контекст.
4) input(). Выбирает из входного потока очередной символ и возвращает его в качестве своего значения. Возвращает ноль при обнаружении конца входного потока;
5) output(c). Записывает символ с в выходной поток;
6) unput(c) Помещает символ с во входной поток;
7) yywrap(). Автоматически вызывается при обнаружении конца входного потока. Если возвращает значение 1, то лексический анализатор завершает свою работу, если 0 - входной поток продолжается текстом нового файла. По умолчанию yywrap возвращает 1. Если имеется необходимость продолжить ввод данных из другого источника, пользователь должен написать свою версию функции yywrap(), которая организует новый входной поток и возвратит 0.
Пример входного файла:
%%
\"[^"]* { if( yytext[yyleng - 1] == '\\')
yymore();
{ /* здесь должна быть часть программы, обрабатывающая и закрывающую кавычку */ }
}
Входной файл генератора lex содержит одно правило.
Анализатор распознает строки символов, заключенные в двойные кавычки, причем символ двойная кавычка внутри этой строки может изображаться с предшествующей косой чертой.
Анализатор должен распознавать кавычку, ограничивающую строку, и кавычку, являющуюся частью строки, когда она изображена как \".
Допустим, на вход поступает строка "абв\"эюя".
Сначала будет распознана цепочка "абв\ и, так как последним символом в этой цепочке будет символ "\", выполнится вызов yymore().
В результате повторного применения правила к цепочке "абв\ будет добавлено "эюя, и в yytext мы получим: "абв\"эюя, что и требовалось.
Встроенные макрооперации
· ECHO - эквивалентно printf(“%s”,yytext); . Печать в выходной поток содержимого массива yytext.
· BEGIN st - перевод анализатора в состояние с именем st.
· BEGIN 0 - перевод анализатора в начальное состояние.
· REJECT - переход к следующему альтернативному правилу. Последовательность символов, распознанная данным правилом, возвращается во входной поток, затем производится применение альтернативного правила.
Альтернативные правила.
Регулярное выражение, входящее в правило, определяет множество последовательностей символов.