Курсовая работа (т): Системы программирования
Два правила считаются альтернативными, если определяемые ими два множества последовательностей символов имеют непустое пересечение, либо существуют такие две последовательности из этих множеств, начальные части которых совпадают.
Примеры альтернативных правил:
) Регулярное выражение
SWITCH - определяет единственную последовательность символов SWITCH, а регулярное выражение;
[A-Z]+ - определяет бесконечное множество последовательностей символов, в том числе и SWITCH.
) Регулярное выражение
INT - определяют последовательность INT, которая является подпоследовательностью последовательности INTEGER, определяемой регулярным выражением
INTEGER
) Регулярное выражение
AC+ - определяет множество, являющееся пересечением множеств, определяемых выражениями
[BC]+
A[CD]+
В лексическом анализаторе каждый входной символ учитывается один раз.
Поэтому в ситуации, когда возможно применение нескольких правил, действует следующая стратегия:
1) Выбирается правило, определяющее самую длинную последовательность входных символов;
2) Если таких правил оказывается несколько, выбирается то из них, которое текстуально стоит раньше других.
Если требуется несколько раз обработать один и тот же фрагмент входной цепочки символов, то можно воспользоваться функцией yyless или макрооператором REJECT.
Пример 1 (Предположим, что мы хотим подсчитать все вхождения цепочек she и he во входном тексте.
Для этого я могла бы написать следующий входной файл для lex):
%{int s=0,h=0;%}
%%{ s++;(1); }h++;
Пример2:
%%
[jJ][aA][nN][uU][aA][rR][yY] printf("Январь");
[fF][eE][bB][rR][uU][aA][rR][yY] printf("Февраль");
[mM][aA][rR][cC][hH] printf("Март");
[aA][pP][rR][iI][lL] printf("Апрель");
[mM][aA][yY] printf("Май");
[jJ][uU][nN][eE] printf("Июнь");
[jJ][uU][lL][yY] printf("Июль");
[aA][uU][gG][uU][sS][tT] printf("Август");
[sS][eE][pP][tT][eE][mM][bB][eE][rR] printf("Сентябрь");
[oO][cC][tT][oO][bB][eE][rR] printf("Октябрь");
[nN][oO][vV][eE][mM][bB][eE][rR] printf("Ноябрь");
[dD][eE][cC][eE][mM][bB][eE][rR] printf("Декабрь");
Генератор построит конечный автомат, который распознает английские наименования месяцев и выводит русские значения найденных английских слов.
Все другие последовательности входных символов без изменений копируются в
выходной поток.
Глава 5. Домашняя работа №5
Описание продуктов
Приобретение лицензии Studio XE для Linux или С++ Studio для Win Intel Parallel Composer- это не просто компилятор С++ от Intel. Он уже проинтегрирован в Visual Studio вместе с библиотекой производительности IPP и параллельной библиотекой TBB, что значительно облегчает процесс разработки параллельного кода для новичков, т.е. тех, кто еще не пользовался продуктами Intel, такими, например, как Compiler Pro, и только собирается попробовать улучшить производительность своих приложений с помощью технологий Intel.
Наличие сразу нескольких компонент в пакете позволит сразу же начать оптимизировать свою программу с использованием параллельных технологий, которые содержит Composer:
Вычислительные примитивы, реализованные в виде функций в библиотеке IPP, гарантируют высокую производительность алгоритмов на платформах Intel;
Поддержка компилятором элементов стандарта С++ 0х облегчит кодирование программистам.Parallel Inspector
Это самый востребованный и ожидаемый инструмент на сегодняшний день, так как он помогает избавиться от ошибок в многопоточной программе на этапе верификации, повышая корректность и стабильность ее исполнения. Inspector применяется не только командами тестировщиков (QA team). Нормальная инженерная практика предполагает проверку программы на наличие ошибок и самим разработчиком, хотя бы на уровне юнит-тестов (unit tests).
Я разберу, какие ошибки помогает обнаружить Parallel Inspector. Инструмент адресует два класса ошибок: ошибки многопоточности и ошибки работы с памятью, причем анализ для каждого класса запускается отдельно. Последний класс ошибок хорошо известен программистам, которые до последнего времени использовали различные инструменты, чтобы найти утечки памяти, нарушение целостности стека или доступ по несуществующим адресам. Второй класс ошибок связан с многопоточной природой программ. Они неизбежно возникают при разработке параллельных приложений, и их чрезвычайно сложно отловить, особенно если они проявляются нерегулярно и только при совпадении определенных условий.
Пример ошибок памяти:
// Запись по недействительному адресу освобожденной памяти
char *pStr = (char*) malloc(20);(pStr);(pStr, "my string"); // Ошибка!
// Попытка чтения неинициализированной памяти* pStr = (char*) malloc(20);c = pStr[0]; // Ошибка!
// Функция освобождения памяти не соответствует функции выделения
char *s = (char*)malloc(5);s;// Ошибка!
// Выход за пределы стекаstackUnderrun()
{array[10];(array, "my string");len = strlen(array);(array[len] != "Z") // Ошибка!-;
}
Ошибки многопоточности:
Наиболее распространенные ошибки многопоточности - это «гонки» (Data Races), или конкурирующий доступ потоков к разделяемым данным, и взаимоблокировки (Deadlocks), когда, захватив неправильно расставленные объекты синхронизации, потоки самозаблокировались и не могут продолжить свое выполнение.
Пример ошибки, которая рано или поздно приведет к «зависанию» программы,
представлена в примере ниже.
// Поток A захватывает критическую секцию L1, затем ожидает критическую секцию L2WINAPI threadA(LPVOID arg)
{(&L1);(&L2);(data1, data2);(&L2);(&L1);
return(0);
}
// Поток В захватывает критическую секцию L2, затем ожидает секцию L1WINAPI threadB(LPVOID arg)
{(&L2);(&L1);(data2, data1) ;(&L1);(&L2);(0);
}Parallel Amplifier
Профилировщик производительности предназначен для того, чтобы выяснить, насколько эффективно используется мультипроцессорная платформа приложением, и где находятся те узкие места в программе, которые мешают ей масштабироваться и увеличивать производительность с ростом вычислительных ядер в системе. Методология профилировки приложения проста: необходимо ответить себе на три основных вопроса, каждый из которых соответствует своему типу анализа и отражает суть, место и причины проблем с производительностью.анализ. «На что моя программа тратит вычислительное время процессора?» Нам необходимо знать те места в программе, Hotspot-функции, где больше всего тратится вычислительных ресурсов при исполнении, а также тот путь, по которому мы в эти места попали, т.е. стэк вызовов.анализ. «Почему моя программа плохо параллелится?» Бывает, что независимо от того, насколько продвинута параллельная инфраструктура приложения, ожидаемый прирост производительности при переходе, например от 4-ядерной системе к 8-ядерной так и не достигается. Поэтому тут нужна оценка эффективности параллельного кода, которая дала бы представление о том, на сколько полно используются ресурсы микропроцессора.& Wait - анализ. «Где моя программа простаивает в ожидании синхронизации или операции ввода-вывода?» Поняв, что наша программа плохо масштабируется, мы хотим найти, где именно и какие именно объекты синхронизации стали на пути к хорошей параллельности.
Программа на данный момент находится в стадии альфа тестирования и не входит в комплект Intel Parallel Studio, поэтому полный обзор до релиза приложения делать некорректно.
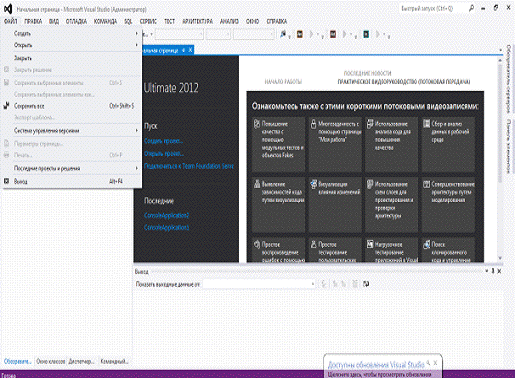
Я зарегистрировалась и получила код. Скачала Intel Parallel Studio XE 2013.
Глава 6. Домашняя работа №6
Расширения MMX/SSE. Общее представление о SSE
обеспечивает инструкции для управления кэшированием всей MMX технологии и 32-битных типов данных. Эти инструкции включают возможность записи данных в память без “засорения” кэша промежуточный буфер с быстрым доступом, и возможность упреждающей выборки кода/данных до их использования.
Потоковое Расширение SIMD обеспечивает следующие новые возможности при программировании оборудования IA архитектура Intel (Intel architecture):
· Восемь SIMD-регистров с плавающей точкой (XMM0 - XMM7);
· Тип данных SIMD (упакованные числа одинарной точности с плавающей точкой) - 128-бит;
· Набор команд SSE.регистры с плавающей точкойсодержит восемь 128-разрядных регистров общего назначения, каждый из них может быть напрямую адресован. Так как эти регистры новые, то для использования нуждаются в поддержке операционной системы.регистры с плавающей точкой содержат упакованные 128-разрядные данные. Команды SSE обращается к SIMD-регистрам с плавающей точкой, используя регистровые имена XMM0 и до XMM7 . SIMD-регистры с плавающей точкой могут быть использованы для вычислений над данными; но не могут быть использованы для адресации памяти. Адресация выполняется с помощью определенных в IA режимов адресации и регистров общего назначения (EAX, EBX, ECX, EDX, EBP, ESI, EDI и ESP).
Если произошло исчезновение порядка (underflow), а поле flush-to-zero (FZ бит 15) регистра MXCSR установлено в 1, то процессор выполняет следующие действия:
· возвращает нулевое значение в качестве результата, присваивая ему знак истинного результата;
· устанавливает в 1 биты 4 и 5 регистра MXCSR (флаги обнаружения исключений исчезновения порядка и неточного результата).
Указанные действия выполняются в том случае, если исключение underflow маскировано (бит 11 регистра MXCSR установлен в 1). При таком режиме увеличивается скорость работы программ, в которых часто происходит исчезновение порядка результата. Достигается это ценой снижения точности вычислений. Переход от операций MMX к операциям с плавающей точкой требует запуска команды EMMS. Но так как SIMD-регистры с плавающей точкой являются отдельным регистровым файлом, то команды MMX и команды с плавающей точкой могут быть смешаны с командами SSE без выполнения специальных инструкций, таких как EMMS.
Тип данных SIMD с плавающей точкой
Основной тип данных SSE это 128-разрядное значение, содержащее четыре последовательно расположенных (“упакованных”) 32-разрядных числа одинарной точности с плавающей точкой (single-precision floating-point (SPFP)) .
Данный формат сохранен и в процессорах, начиная с Pentium III, но для упакованных чисел с плавающей точкой используется представление в 32-разрядном формате с одинарной точностью. Поэтому в отдельных случаях результаты вычислений с плавающей точкой в архитектуре х87 могут отличаться от результатов таких же вычислений, использующих новые SSE SPFP-команды.
Новые команды SIMD над целыми могут работать над типами данных состоящих из упакованных байт, слов или двойных слов. Новые команды предварительной выборки работают над данными размер, которых от 32 байт и выше.
Команды SSE копирует упакованные типы данных (данные одинарной точности с плавающей точкой - двойные слова) из памяти в 64-битные или 128-битные блоки. Однако, при вычислении арифметических или логических операций над упакованными данными, SSE работает параллельно над каждым двойным словом, заключенным в SIMD регистре с плавающей точкой.
Модель выполнения SIMD
Так как потоковое расширение SSE поддерживает операции над упакованными типами данных одинарной точности с плавающей точкой, и дополнительные SIMD команды над целыми, поддерживаются операции над упакованными типами данных (байт, слово или двойное слово).
Этот подход был выбран, потому что большинство приложений обработки мультимедиа имеют следующие характеристики:
· существенна параллельность;
· широкий динамический уровень, отсюда базированы на переменных с плавающей точкой;
· регулярная и повторяющая выборка шаблонов из памяти;
· локализированные повторяющие операции выполняемые над данными;
· независимый процесс управления данными.
Формат данных в памяти
В SSE вводиться новый упакованный 128-разрядный тип данных, который состоит из четырех чисел одинарной точности с плавающей точкой. Бит 0 это наименьше значащий - бит (LSB), и бит 127 это наибольше значащий - бит (MSB). Байты в новом формате данных имеют последовательные адреса памяти. Порядок как всегда немного странный, то есть байты с меньшими адресами имеют меньшее значение, чем байты со старшими адресами.
Команды Потокового Расширения SIMD
Потоковое Расширение SIMD состоит из 70 команд, сгруппированных в следующие категории:
· Команды копирования данных;
· Арифметические команды;
· Команды сравнения;
· Команды преобразования типов данных;
· Логические команды;
· Дополнительные целочисленные SIMD-команды;
· Команды перестановки;
· Команды управления состоянием;
· Команды управления кэшированием
Глава 7. Домашняя работа №7
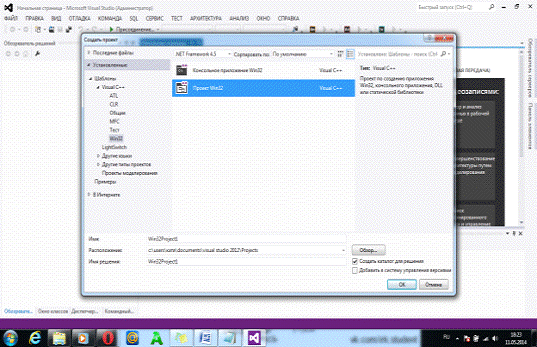
Написать программу умножения матриц, с замером времени на операцию.
Сравнить компиляторы msvs/gcc с компилятором intel.
Глава 8. Домашняя работа №8
Технология GIT. Сравнение
репозиториев gihub/bit bucket
Сравнение репозиториев github и bitbucket
Bitbucket
<#"870790.files/image018.gif">
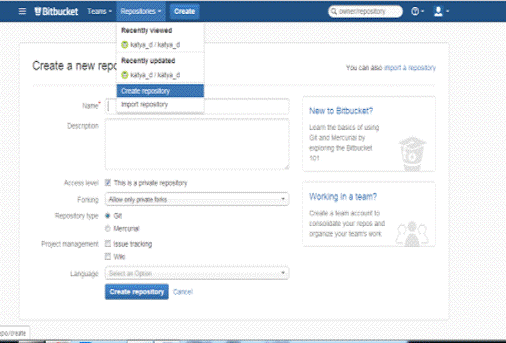
Создать репозиторий.
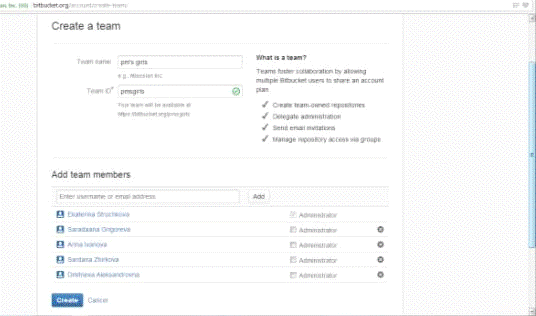
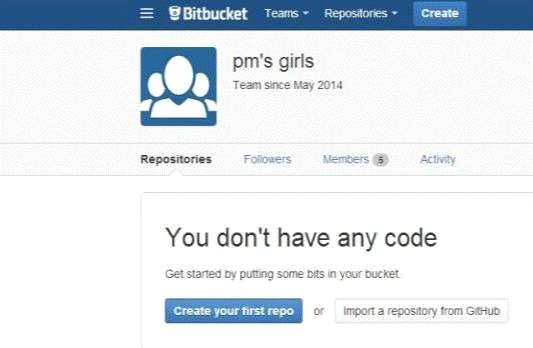
Для создания команды нужно было разделиться по группам. В нашей группе есть Жиркова Сардаана, Григорьева Сардаана, Стручкова Катя, Иванова Арина и я.
Для того чтобы создать команду нужно нажать на вкладку teams.
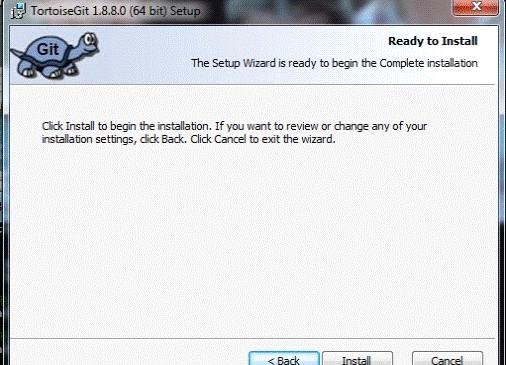
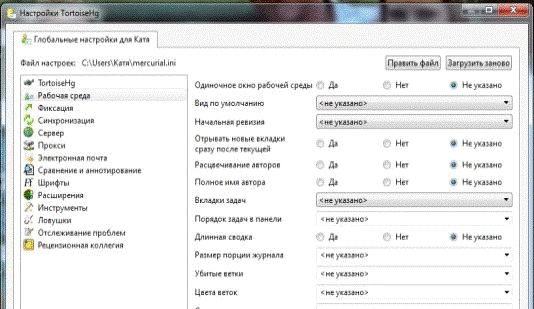
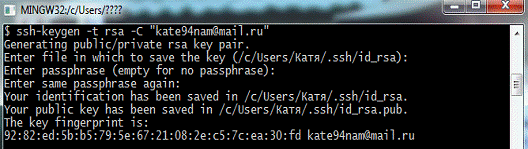
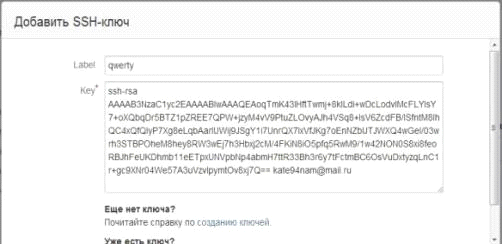
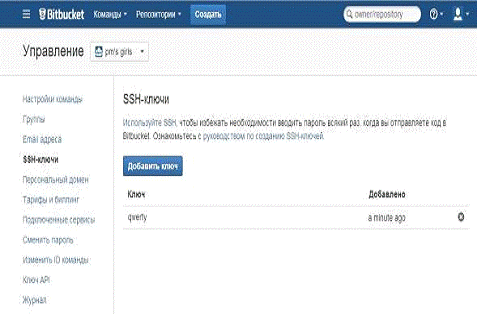
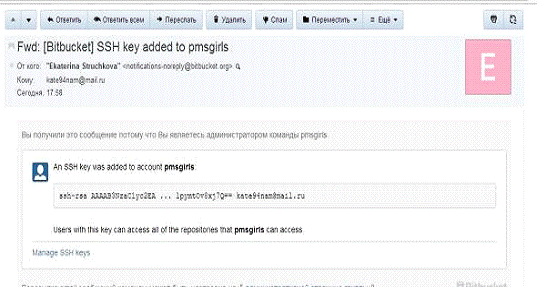
На этом базовая настройка Bitbucket окончена и можно приступать к работе над кодом.